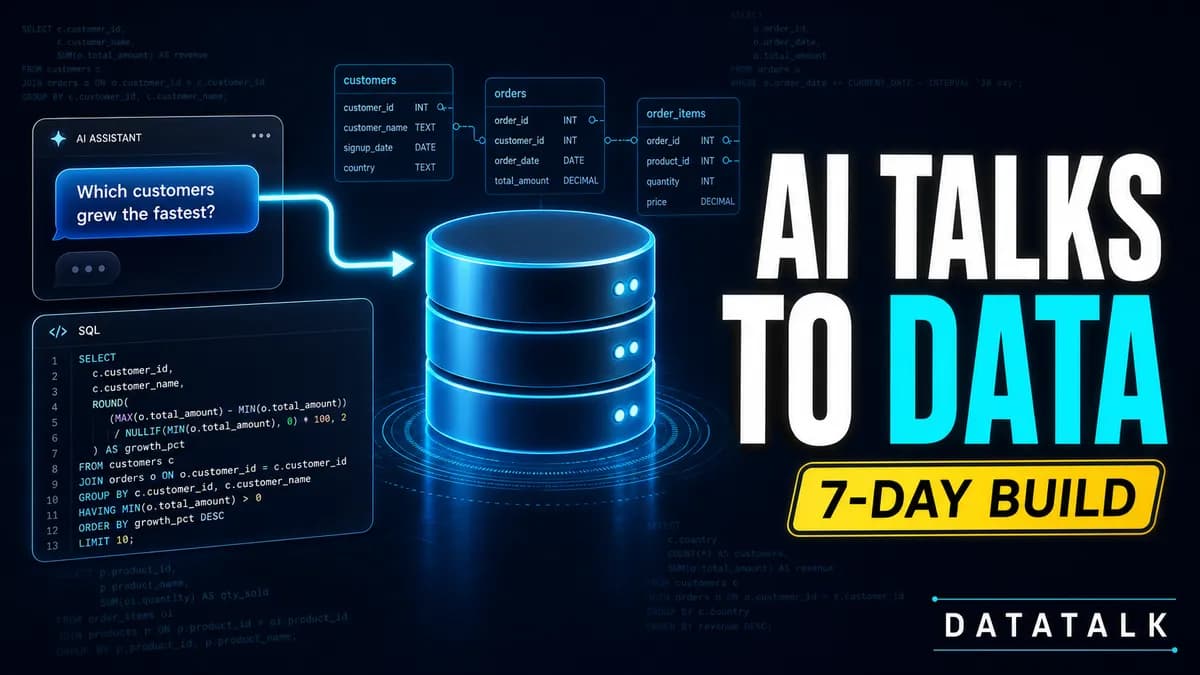
اگر امروز برای استخراج دادهها از دیتابیس به تحلیلگران وابسته هستید، احتمالاً میدانید که یک سؤال ساده میتواند ساعتها انتظار برای دریافت پاسخ درست به همراه داشته باشد. تولید یک کوئری SQL شاید آسان باشد، اما تضمین اینکه آن کوئری پاسخ تجاری صحیحی را برمیگرداند، یک چالش جدی در مهندسی سیستم است. مشکل اینجاست که اجرای موفق یک کد SQL لزوماً به معنای درست بودن پاسخ تجاری آن نیست.
DataTalk — یک عامل (Agent) دادهمحور که جزئیات آن در گزارش ۲۲ اوت ۲۰۲۶ در وبسایت dev.to منتشر شد — تلاش میکند این بحران اعتماد را حل کند. این ابزار به جای تکیه بر پرامپتهای پیچیده، دسترسی به دادهها را به عنوان یک مسئلهٔ قابلیت اطمینان مهندسی میبیند، نه صرفاً یک مسئلهی مهندسی پرامپت.
مسئلهی ترجمه
بسیاری از سازمانها با کمبود داده مواجه نیستند، بلکه با «شکاف ترجمه» دستوپنجه نرم میکنند. برای مثال، یک ذینفع ممکن است بپرسد: «کدام بخش مشتریان در فصل گذشته بیشترین رشد درآمد را داشت؟». در حالی که پاسخ این سؤال در انبار دادهها (Warehouse) موجود است، اما رسیدن به آن معمولاً مستلزم باز کردن تیکتها، پیام دادن به تحلیلگران و انتظار برای شفافسازی معیارهای اندازهگیری است.
تیمهای داده مقدار زیادی از زمان خود را صرف پاسخ دادن به نسخههای مختلف از همین سؤالات تکراری میکنند. مسئله اصلی این است که انبارهای داده واقعی، محیطهای دمو نیستند؛ آنها حاوی نامهای مبهم برای جداول، ستونهای بدون مستندات، معیارهای متناقض و مرزهای حساس دادهای هستند.
وقتی یک کاربر از «بهترین مشتریان» سؤال میکند، مدل زبانی بزرگ (LLM) باید تصمیم بگیرد که منظور دقیقاً چیست: آیا بیشترین درآمد کل است، یا بیشترین رشد درآمد، یا بالاترین نرخ بازگشت (Retention)، بیشترین حاشیه سود، بیشترین فعالیت در ۳۰ روز گذشته یا بالاترین ارزش طول عمر مشتری (LTV)؟ بدون یک چارچوب ساختاریافته، هوش مصنوعی اغلب کدی تولید میکند که با موفقیت اجرا میشود اما پاسخ غلطی ارائه میدهد. در واقع، اجرای SQL با صحت دادهها یکسان نیست.
مکانیسمهای سیستم و گردشکار
طبق مستندات این پروژه، DataTalk برای پر کردن این شکاف از یک گردشکار عاملمحور (Agentic) چندمرحلهای استفاده میکند. این سیستم صرفاً متن را به SQL تبدیل نمیکند، بلکه یک خط لوله (Pipeline) سختگیرانه را دنبال میکند:
- بازیابی زمینه (Context Retrieval): با استفاده از روش تولید بازیابیافزا (RAG) برای طرح دیتابیس (Schema RAG)، فقط جداول، ستونها و تعاریف معیارهای مرتبط را فراخوانی میکند. این کار باعث میشود عامل مجبور نباشد کل طرح عظیم انبار داده را دریافت کند.
- اعتبارسنجی و اجرا: کوئریها پیش از آنکه به انبار داده برسند، اعتبارسنجی شده و در چارچوب محدودیتهای دسترسی و مرزهای سختگیرانه اجرا میشوند.
- خودترمیمی (Self-Healing): اگر کوئری با خطا مواجه شود، عامل خطاهای اجرا را تفسیر کرده و سعی میکند کد SQL را به صورت ایمن تعمیر کند. اگر عملیات ریسکی یا مبهم باشد، سیستم برای تایید از انسان درخواست کمک میکند.
- تفسیر: نتایج نهایی را با زمینهی کافی ارائه میدهد تا کاربر بتواند به دقت معنایی دادههای بازگشتی اعتماد کند.
معماری مهندسی
معماری این سیستم بر پایه LangGraph بنا شده است تا گردشکارهای پیچیده و غیرخطی را مدیریت کند. با استفاده از رویکرد گرافمحور به جای یک فراخوانی ساده از LLM، سیستم میتواند در صورت تشخیص خطا، به مراحل بازیابی یا تعمیر بازگردد. این ساختار در واقع ترکیبی از مهندسی داده، مهندسی هوش مصنوعی و ارزیابی اپلیکیشن است.
نقشه راه این پروژه بر اهمیت «بنیاد دادهها» به عنوان حیاتیترین لایه تأکید دارد. سری ساخت هفتروزه این پروژه، مراحل را به نقاط عطف مهندسی مشخصی تقسیم کرده است:
- روز ۱ و ۲: ایجاد بنیاد دادهها و تحلیل اینکه مدلهای dbt، نامگذاریها و طراحی معنایی چگونه بر تبدیل متن به SQL تأثیر میگذارند.
- روز ۳ و ۴: پیادهسازی معماری LangGraph و ساخت گیتهای تأیید (Approval Gates) برای SQLهای خودترمیمی.
- روز ۵ و ۶: توسعه Schema RAG برای بازیابی و ایجاد یک چارچوب ارزیابی برای اندازهگیری صحت SQL، موفقیت در اجرا و ایمنی.
- روز ۷: انتقال به محیط عملیاتی (Production) همراه با ارزیابی و نظارت مستمر.
سازندگان DataTalk معتقدند پیش از آنکه یک عامل بتواند دیتابیس را کوئری کند، انبار داده باید دارای مدلهای dbt تمیز، قراردادهای نامگذاری سازگار و مستندات شفاف باشد. این ضرورت با یافتههای اخیر همسو است که نشان میدهد بسیاری از دادههای سازمانی پیش از بهرهبرداری از AI نیاز به پاکسازی و سازماندهی دارند. بدون این انضباط مهندسی، حتی پیشرفتهترین عاملها نیز شکست خواهند خورد.
این تغییر رویکرد نشان میدهد آینده هوش مصنوعی سازمانی در مدلهای بزرگتر نیست، بلکه در حفاظها (Guardrails) است. با انتقال تمرکز از «مهندسی پرامپت» به «مهندسی هوش مصنوعی»، توسعهدهندگان میتوانند سیستمهایی بسازند که در محیطهای عملیاتی، قابل مشاهده و ایمن باشند.
برای تیمهای داده، این به معنای تغییر نقش تحلیلگر است؛ از نوشتن کوئریهای تکراری به تعریف لایهی معنایی که هوش مصنوعی از آن تغذیه میکند. در واقع گلوگاه از ویرایشگر SQL به فرهنگ لغت دادهها (Data Dictionary) منتقل شده است.
توسعهدهندگانی که علاقهمند به پیادهسازی الگوهای مشابه هستند، میتوانند سری ساخت هفتروزه را دنبال کنند که همه چیز، از Schema RAG تا چارچوبهای ارزیابی صحت معنایی را پوشش میدهد. مخزن گیتهاب این پروژه به عنوان منبع اصلی برای جزئیات پیادهسازی در دسترس خواهد بود.
گام بعدی شما
- بررسی مخزن گیتهاب DataTalk برای پیادهسازی الگوهای LangGraph در پروژههای خود.
- بازنگری در نامگذاری جداول و ستونهای دیتابیس برای بهبود نرخ موفقیت مدلهای Text-to-SQL.
- مطالعهی سری آموزشی ۷ روزه برای درک نحوه ساخت سیستمهای خودترمیمی در عاملهای داده.
اما چالش اصلی در مقیاسهای عظیم، مدیریت حافظه در این گرافهاست — به تحلیل ما دربارهی گلوگاههای حافظه در پردازشهای سنگین مراجعه کنید.



گفتگو