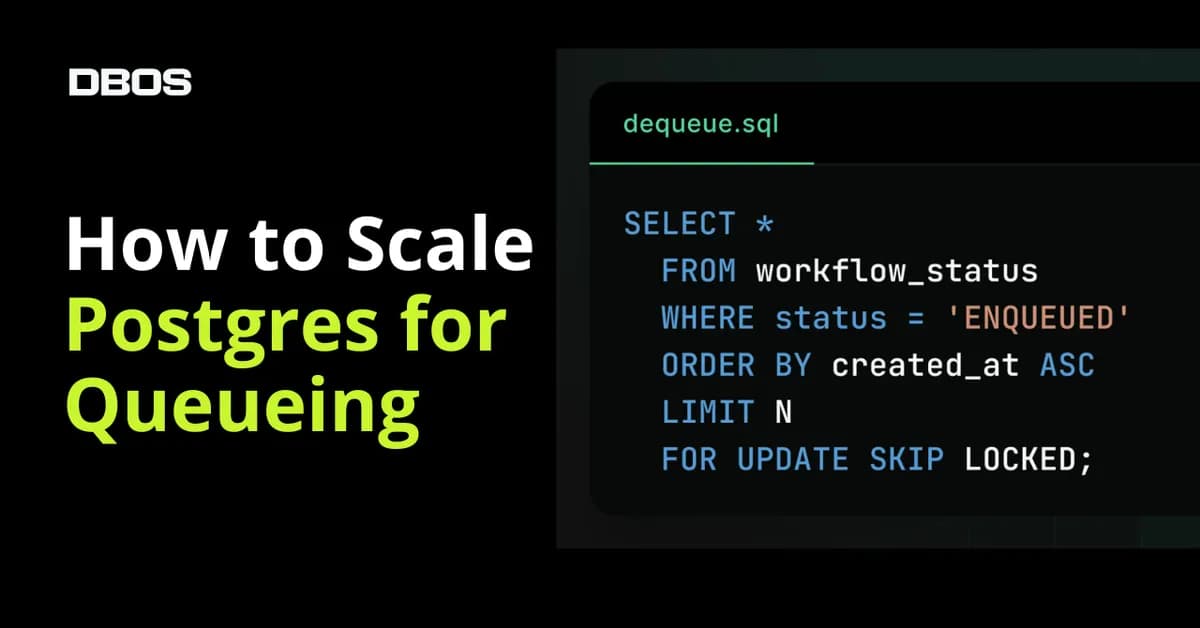
اگر امروز برای مدیریت صفهای پردازشی در مقیاس بالا از ابزارهای پیچیده استفاده میکنید، شاید زمان آن رسیده که معماری خود را بازنگری کنید. باور رایج به این نکته که برای صفبندی در مقیاس بالا حتماً به RabbitMQ یا Redis نیاز دارید، اشتباه است. طبق اعلام DBOS، یک پایگاهداده Postgres که بهدرستی تنظیم شده باشد، میتواند ۳۰,۰۰۰ اجرای گردشکار (Workflow) را در ثانیه در هزاران سرور مدیریت کند.

بیشتر مهندسان از بهکارگیری Postgres برای صفها دوری میکنند چون با مشکل «رقابت بر سر منابع» (Contention) مواجه میشوند. وقتی هزاران Worker بهطور همزمان یک جدول را چک میکنند تا تسکهای جدید را بردارند، آنها اغلب سعی میکنند همان تسکهای یکسانی را بگیرند و این امر تداخلی ایجاد میکند که معمولاً توان عملیاتی (Throughput) را به حدود ۱۰۰ اجرا در ثانیه محدود میکند. این اصطکاک معماری معمولاً تیمها را مجبور میکند تا پیچیدگیهای مربوط به ابزارهایی مثل Celery یا BullMQ را به استک تکنولوژی خود اضافه کنند.
مکانیزم رقابت در صف
در یک صف ساده و ابتدایی مبتنی بر Postgres، کلاینتها با افزودن گردشکارها به یک جدول صف (queues table)، تسکها را ارسال میکنند. سپس Workerها سعی میکنند قدیمیترین گردشکارهای ارسال شده را استخراج و پردازش کنند تا ترتیب FIFO (اولین ورودی، اولین خروجی) حفظ شود.
وقتی چندین Worker بهطور همزمان کوئری میزنند تا N تسک قدیمی را پیدا کنند، همگی ردیفهای یکسانی را میبینند. چون هر گردشکار فقط باید توسط یک Worker پردازش شود، اکثر Workerها در تصاحب آن تسک شکست میخورند و مجبور میشوند دوباره تلاش کنند. در مقیاس بالا، این چرخه تکراری (Churn) باعث ایجاد یک گلوگاه عظیم در سیستم میشود.

بر اساس تحلیل فنی DBOS، اولین گام برای شکستن این سقف، بهرهگیری از عبارت FOR UPDATE SKIP LOCKED است. این دستور ابتدایی به Workerها اجازه میدهد ردیفها را بدون اینکه مانع راه دیگران شوند، قفل کنند.
عملکرد SKIP LOCKED
انتخاب ردیفها با این عبارت دو اقدام حیاتی انجام میدهد:
- ردیفها را قفل میکند تا Workerهای دیگر نتوانند آنها را انتخاب کنند.
- هر ردیفی که پیش از این قفل شده است را نادیده میگیرد (Skip میکند) و N تسک قدیمی بعدی را که در حال حاضر توسط هیچ Worker دیگری نگه داشته نشدهاند، انتخاب میکند.


این روش اجازه میدهد Workerهای زیادی بهطور همزمان و بدون رقابت، گردشکارهای جدید را استخراج کنند. در این حالت، Worker اول N تسک نخست را قفل میکند، Worker دوم N تسک بعدی را میگیرد و این روند ادامه مییابد. بدون این «ترفند قدیمی Postgres»، مقیاسپذیری فراتر از ۱۰۰ اجرا در ثانیه تقریباً غیرممکن است.
پس از حل مشکل قفلگذاری، تیم با سد دوم یعنی خطاهای «شکست سریالسازی» (Serialization Failure) روبرو شد. این اتفاق زمانی رخ میداد که سیستم در سطح ایزولاسیون REPEATABLE READ اجرا میشد؛ سطحی که تضمین میکند یک نمای ثابت (Consistent Snapshot) از دیتابیس در طول تراکنش وجود داشته باشد.
گلوگاه سطح ایزولاسیون
هنگام استخراج بیش از ۱,۰۰۰ گردشکار در ثانیه، اکثریت عملیات با این شکستها مواجه میشدند. سطح REPEATABLE READ در ابتدا برای پشتیبانی از محدودیتهای جهانی صف استفاده میشد؛ برای مثال، پیادهسازی قانونی مانند «حداکثر N گردشکار بهطور همزمان در تمام Workerها اجرا شود». این کار مستلزم آن است که Workerها یک نمای جهانی و سازگار از وضعیت سیستم داشته باشند.
اما این رویکرد در همزمانی بالا بسیار هزینهبر میشود. اگر چندین Worker ردیفهای همپوشان را تغییر دهند، Postgres یکی از آنها را متوقف (Abort) میکند. در مقیاس بالا، Workerها زمان بیشتری را صرف تلاش مجدد برای تراکنشها میکردند تا پردازش واقعی گردشکارها.

برای رفع این مشکل، DBOS سطوح ایزولاسیون شرطی را پیاده کرد. آنها متوجه شدند که صفهای بزرگ بهندرت به کنترل جریان جهانی نیاز دارند و ترجیح میدهند از محدودیتهای محلی استفاده کنند (مثلاً «حداکثر ۱۰ گردشکار برای هر Worker») که نیازی به هماهنگی بین Workerهای مختلف ندارد.
- صفهایی که به محدودیتهای جهانی نیاز دارند، در سطح
REPEATABLE READباقی ماندند. - صفهای بدون نیاز به محدودیت جهانی به سطح
READ COMMITTEDمنتقل شدند.
این تغییر، خطاهای سریالسازی را بهطور کامل حذف کرد و توان عملیاتی را بهطور چشمگیری افزایش داد. با این حال، عبور از ۸,۰۰۰ اجرا در ثانیه باعث جهش مصرف CPU شد. مقصران اصلی، ایندکسهای ثانویه ناکارآمد و سربار فرآیند auto-vacuum در Postgres بودند. هر بار که وضعیت یک گردشکار تغییر میکرد، دیتابیس مجبور بود چندین ایندکس را بهروزرسانی کند که مقدار زیادی از توان پردازشی را میبلعید.
هزینه نگهداری ایندکسها
تیم کشف کرد که نگهداری ایندکسها و عملیات vacuum بخش قابلتوجهی از CPU دیتابیس را مصرف میکند. این مشکل از دو ناحیه اصلی نشأت میگرفت:
- کوئری استخراج: ایندکس اصلی روی
queue_nameوstatusبه یافتن تسکها کمک میکرد اما آنها را با ترتیب زمانی برنمیگرداند. این امر Postgres را مجبور میکرد تا یک مرتبسازی (Sort) گرانقیمت بر اساس برچسب زمانی انجام دهد. - ایندکسهای نظارتی: ایندکسهایی مانند آنهایی که روی ID گردشکار والد (Parent Workflow ID) بودند، برای تمام گردشکارها نگهداری میشدند، فارغ از اینکه آیا واقعاً به آنها نیاز است یا خیر.


برای حل این موضوع، تیم به سمت استفاده از «ایندکسهای جزئی» (Partial Indexes) حرکت کرد. آنها ایندکس اصلی استخراج را بهروز کردند تا شامل اولویت (Priority) و برچسب زمانی (Timestamp) باشد و آن را بهگونهای پیکربندی کردند که فقط زمانی ورودیها را نگهداری کند که وضعیت گردشکار برابر با ENQUEUED باشد.
بهینهسازی با ایندکسهای جزئی
این تغییرات دو برد اساسی در عملکرد ایجاد کرد:
- حذف مراحل مرتبسازی گرانقیمت: اکنون کوئری استخراج، گردشکارها را فوراً با ترتیب صحیح دریافت میکند.
- کاهش عملیات vacuum: به محض اینکه یک تسک استخراج (Dequeue) شود، Postgres بهجای نگهداری آن در ایندکس برای باقی عمر گردشکار، ورودی ایندکس را بهسادگی حذف میکند.

آنها همین اصل را در بخش نظارت (Observability) نیز به کار بردند. برای مثال، ایندکس روی ID گردشکار والد اکنون فقط برای گردشکارهایی نگهداری میشود که واقعاً دارای والد هستند. مجموع این بهینهسازیها باعث شد سیستم بتواند به رکورد ۸۰ میلیارد گردشکار در ماه دست یابد.
برای توسعهدهندگان، این نتایج به این معناست که «بدهی فنی» مربوط به مدیریت یک خوشه (Cluster) مجزا برای صفبندی ممکن است غیرضروری باشد. اکنون میتوانید با نگه داشتن صف و وضعیت (State) در یک دیتابیس واحد، سازگاری قویتری را تجربه کنید بدون اینکه کارایی سیستم را فدا کنید. این رویکرد بهینهسازی زیرساخت برای مدیریت جریانهای پیچیده، مشابه تغییر رویکرد در نحوه مدیریت عاملهای AI از طریق شواهد فنی است که در آن به جای تکیه بر قدرت خام محاسباتی، بر ساختارهای مدیریتی بهینه تمرکز میشود.
اگر شما در حال مدیریت یک سیستم توزیعشده هستید، باید ارزیابی کنید که آیا سطوح ایزولاسیون فعلی شما در حال محدود کردن توان عملیاتیتان است یا خیر. برای مشاهده اینکه موتور اجرای بادوام (Durable Execution Engine) شرکت DBOS چگونه این الگوها را در محیط عملیاتی پیاده کرده است، به گیتهاب یا مستندات آنها مراجعه کنید.
گام بعدی شما
- اگر از Postgres برای صف استفاده میکنید، عبارت
SKIP LOCKEDرا در کوئریهای خود بررسی کنید. - سطح ایزولاسیون تراکنشهای خود را ارزیابی کنید؛ اگر به محدودیتهای جهانی نیاز ندارید، از
READ COMMITTEDاستفاده کنید. - برای کاهش فشار CPU، ایندکسهای خود را به «ایندکسهای جزئی» تبدیل کنید تا فقط دادههای فعال را پوشش دهند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو