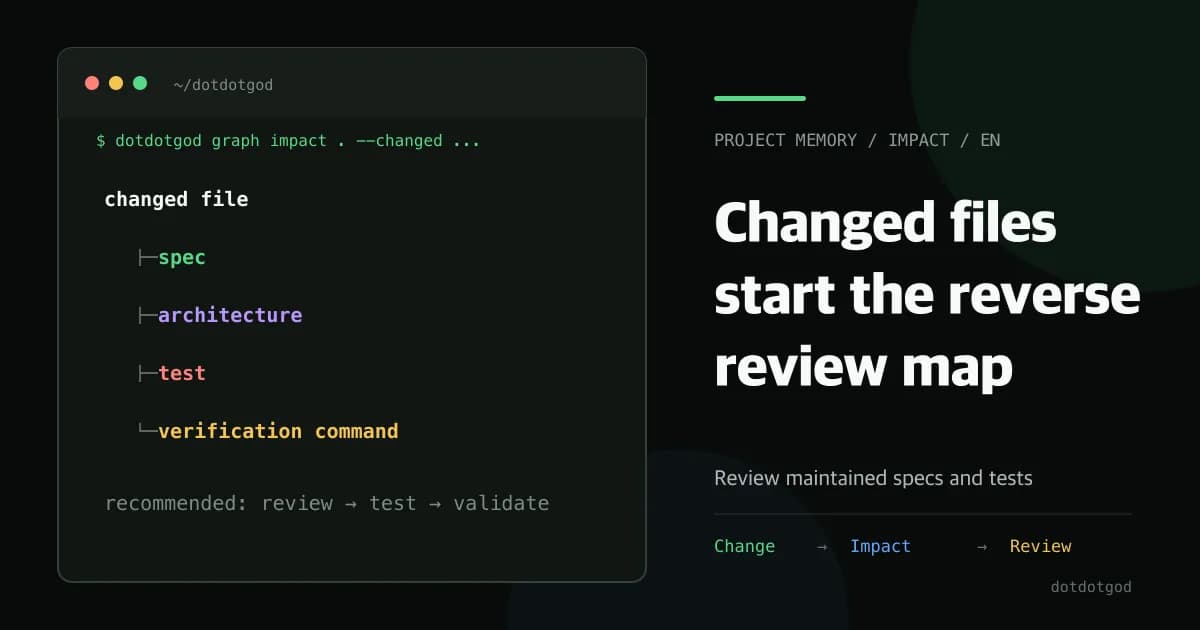
تصور کنید یک تغییر کوچک در یک فایل کد، در یک پایگاه کد (codebase) عظیم، موجی از الزامات پنهان را در سراسر پروژه ایجاد کند که هیچ جستوجوی متنی یا معنایی قادر به یافتن آنها نباشد. این چالش دقیقاً همان جایی است که dotdotgod Graph Impact وارد عمل میشود تا مسیر شناسایی مستندات وابسته را از یک حدس احتمالی به یک محاسبه قطعی تبدیل کند. طبق راهنمایی که در ۲ اوت ۲۰۲۶ در وبسایت dev.to منتشر شد، این ابزار فایلهای تغییریافته را به عنوان «بذرهایی» (seeds) در نظر میگیرد تا از طریق آنها در یک گراف محدود از روابط صریح پروژه ناوبری کند.
بیشتر برنامهنویسان برای یافتن مستندات مرتبط، به جستوجوی نام فایل یا بردار معنایی (Embedding) — که شبیه کارت معرفی عددی برای هر واژه است و میگوید این کلمه همسایهی چه کلمات دیگری است — تکیه میکنند. اما جستوجوی نام فایل به تنهایی نمیتواند پاسخ دهد که دقیقاً کدام مشخصات فنی (specifications)، یادداشتهای معماری، تستها و دستورات اعتبارسنجی باید همزمان با یک تغییر بازبینی شوند. کد و مستندات اغلب از ترمینولوژی متفاوتی استفاده میکنند و یک تغییر واحد میتواند چندین بسته (package) و مسیرهای مختلف تأیید را تحت تأثیر قرار دهد. جستوجوی برداری تنها میگوید دو سند «از نظر معنایی نزدیکاند»، اما نمیتواند توضیح دهد چرا یک تست خاص برای یک تغییر خاص اجباری است.
همانطور که در تحلیلهای پیشین ما دربارهی حافظهٔ عاملها و مدیریت زمینه اشاره کردیم، دسترسی به منبع حقیقت (Ground Truth) کلید ثبات است. حافظه پروژه را مانند یک نقشه فیزیکی تصور کنید؛ در حالی که موتورهای جستوجو فقط مکان یک شهر را به شما میگویند، Graph Impact شبکه دقیق جادههایی را نشان میدهد که تغییر کد شما را به مستندات الزامی و دستورات تأیید متصل میکند تا ثابت شود تغییرات شما به درستی عمل میکنند. این رویکرد شباهت زیادی به استراتژیهای مدیریت شواهد فنی در مقابل قدرت محاسباتی دارد تا از خطاهای احتمالی عاملهای AI در پروژههای پیچیده جلوگیری شود.
سازوکار حافظه پروژه
Graph Impact گراف پروژه را بر اساس شواهدی میسازد که انسانها مستقیماً درون مخزن (Repository) نگهداری میکنند. این کار باعث میشود منطق بازبینی همیشه قابل ردیابی و توسط تیم قابل ویرایش باشد. پایه و اساس این سیستم «حافظه پروژه» است؛ یعنی مشخصات فنی، یادداشتهای معماری، اسناد تست، شاخصهای README و روابط ردیابی (traceability) که بهگونهای در مخزن میمانند که هم انسانها و هم عاملها (Agents) بتوانند همان شواهد واحد را بخوانند و بهروزرسانی کنند.
منابع رابطه و معنای سیگنالها
این گراف در واقع نقشهای مشتقشده از این شواهد است و تیمها دقت این نقشه را با بازبینی منابع Markdown و اطلاعات ردیابی مدیریت میکنند. به نقل از مستندات این ابزار، سیستم بر چندین سیگنال خاص متکی است:
- ردیابی ساختاریافته (Structured Traceability): تگهای صریح مانند
implemented_by،verified_by،related_docو دستورات اعتبارسنجی که بالاترین سطح اعتماد را ایجاد میکنند. - روابط مستنداتی: لینکهای Markdown، سرفصلها (headings) و مسیرهای ناوبری در فایلهای README که به عنوان رابطهای اولیه عمل میکنند.
- ساختار پروژه: روابط قطعی (Deterministic) میان بستهها، سورس کد، تستها، پیکربندیها و منابع.
- سیاست حافظه (Memory Policy): تعریف نقشها و اولویتها برای مشخصات فنی فعلی، معماری، تستها و آرشیوها.
- مسیریابی قطعی: تطبیق میان مسیرها، نام فایلها، سرفصلها، فایلهای README، نواحی حافظه و نام بستهها.
اعتماد به ردیابیهای انسانی (Human-authored traceability) بسیار بیشتر از حدسهای مسیریابی است که از مسیرها یا نامها استخراج میشوند. وقتی اتصالات صریح کم باشند، فایلهای README و اصطلاحات پایدار پروژه به عنوان مسیرهای ناوبری ثانویه عمل میکنند. در نتیجه، کیفیت خروجی به هر دو عامل الگوریتم گراف و وضعیت مستندات نگهداری شده در پروژه بستگی دارد. نتایج زمانی دقیقتر میشوند که مشخصات و تستها مستقیماً به پیادهسازی واقعی اشاره کنند، READMEها به اسناد بهروز هدایت کنند و فایلها مسئولیتهای محدودی داشته باشند.

محاسبه ارزش بازبینی از طریق PPR
برای اینکه ابزار تمام گرههای مرتبط را برنگرداند — که در آن صورت تحلیل اثرگذاری (impact analysis) به یک جستوجوی گسترده و بیفایده در کل مخزن تبدیل میشد — dotdotgod از یک سیاست رتبهبندی متوازن استفاده میکند. این فرآیند از یک خط لوله (pipeline) مشخص پیروی میکند: فایلهای تغییریافته $ \rightarrow $ محدود کردن دامنه کاندیدها $ \rightarrow $ اجرای رتبهبندی صفحهبندی شخصیسازیشده (Personalized PageRank یا PPR) با چند بذر $ \rightarrow $ اعمال سیاست ردیابی و تأیید $ \rightarrow $ ساخت لیست نتایج رتبهبندی شده بر اساس «ارزش بازبینی».
فرآیند با یک PPR چند-بذری شروع میشود که ریشه در فایلهای تغییریافته دارد تا دامنه کاندیدها را محدود کند. امتیاز پایه با این محاسبه PPR آغاز میشود. سپس سیگنالهای با وزن بالا، شامل ردیابیهای صریح، سیگنالهای تست و تأیید، و نزدیکی مستقیم از طریق لینکهای Markdown و فایلهای README، به امتیاز نهایی اضافه میکنند.
اشارات مسیریابی قطعی زمانی به عنوان سیگنالهای ثانویه عمل میکنند که مسیرها، سرفصلها، نواحی حافظه یا نام بستهها مطابقت داشته باشند. در نهایت، «سیاست حافظه» اولویت ناحیه فعلی و طبقهبندی آن را به عنوان «تازه» (fresh) یا «کهنه» (stale) اعمال میکند (این طبقهبندیها مربوط به نواحی حافظه هستند و ربطی به زمان تغییر فایل ندارند) و سپس محتویات آرشیوی را جریمه میکند. در صفحه اول نتایج، ردیابیها و تستها بر موارد کماعتمادتر (که فقط بر اساس مسیریابی یافته شدهاند) اولویت دارند. وقتی تعداد فایلهای عملیاتی کافی باشد، متادیتای کماهمیت (مانند وابستگیهای ساده) از نتایج حذف میشوند.
از دستور اجرا تا لیست عملیاتی
برنامهنویسان میتوانند با دستور dotdotgod graph impact این ابزار را اجرا کنند. این دستور تا ۲۰ فایل تغییریافته منحصربهفرد را با وزن یکسان بهعنوان بذر میپذیرد و مسیرها را بر اساس ترتیب مشاهده حذف تکرار (deduplicate) میکند.
برای یک فایل واحد، دستور به این شکل است:dotdotgod graph impact . \ --changed packages/cli/src/commands/query.mjs \ --yml
وقتی چندین فایل متعلق به یک تغییر باشند، پرچم --changed تکرار میشود:dotdotgod graph impact . \ --changed packages/cli/src/commands/query.mjs \ --changed packages/cli/src/query/chunks.mjs \ --yml
فایلهای تغییریافته ابتدا ظاهر میشوند، در حالی که آیتمهایی که به چندین بذر متصلاند، در یک رتبهبندی ادغام میشوند تا مشخصات و تستهایی که برای کل تغییرات اهمیت دارند، یافت شوند. خروجی با پرچم --yml ساختاری محدود دارد که یک عامل میتواند مستقیماً آن را بخواند. برای مثال، خروجی ممکن است نتایج را بر اساس docs (مانند docs/spec/cli/QUERY.md با امتیاز ۶۵.۴ و دلایل [implemented_by, routes_to]) و tests (مانند packages/cli/test/e2e.test.mjs با امتیاز ۵۸.۱ و دلیل [verified_by]) گروهبندی کند. همچنین اقداماتی نظیر recommended_actions مانند review_related_docs و run_dotdotgod_validate را پیشنهاد میدهد.
در حالی که پرچم --compact برای انسانها کاربردی است، --json امتیازات دقیق و تشخیصهای اتوماسیون را ارائه میدهد. این امتیازات سیگنالهای اولویت هستند؛ امتیاز بالاتر نشاندهنده ارزش بیشتر برای بازبینی زودهنگام است، اما تعیین نمیکند که آیا یک فایل خراب شده است یا خیر.
سنجش کیفیت و دقت
طبق گزارش dev.to، dotdotgod کیفیت این رتبهبندیها را در مقابل نتایج مورد انتظار (Expected Results) که برای موارد نماینده (representative cases) در مخزن ثبت شدهاند، ارزیابی میکند. آنها از چهار معیار خاص برای تضمین قابلیت اطمینان استفاده میکنند:
۱. Precision@5/10: سهمی از نتایج برتر که باید یا بهتر است بازبینی شوند.
۲. Recall@10: سهمی از موارد «باید-بازبینی-شوند» که در ۱۰ نتیجه اول یافت شدهاند.
۳. MRR (Mean Reciprocal Rank): اینکه اولین مورد ضروری در کجای لیست ظاهر شده است.
۴. nDCG@10: کیفیت رتبهبندی در سراسر درجات مرتبط بودن (الزامی و توصیه شده).
یک اسکریپت ارزیابی، نتایج فعلی را با یک خط پایه (baseline) مقایسه میکند تا حکمی صادر کند. با انباشت موارد واقعی، این اندازهگیریها شواهدی را برای انتخاب آستانههای مناسب CI (تکامل مداوم) در هر پروژه فراهم میکنند.
تحلیل: چرخش از «جستوجو» به «ناوبری»
این رویکرد یک تغییر بنیادین در تجربه توسعهدهنده است؛ گذار از «جستوجو» برای یافتن زمینه (Context) به «ناوبری» در یک گراف شناختهشده. چنین بهینهسازیهای ساختاری در تحلیل کد، مشابه آنچه در ابزار code-review-graph برای کاهش ۸۲ برابری مصرف توکنها مشاهده شد، منجر به بهرهوری عملیاتی بسیار بالاتری میشود. در این اکوسیستم، دو ابزار نقشهای متمایزی دارند:
- dotdotgod query: از پرسشهای زبان طبیعی و بردارهای چندزبانه برای یافتن اسنادی که از نظر معنایی نزدیک به پرسش هستند استفاده میکند.
- graph impact: از فایلهای تغییریافته و ترکیبی از ردیابی/PPR/سیاست برای یافتن آیتمهایی که باید پس از یک تغییر، اول بازبینی شوند استفاده میکند.
رتبهبندی پیشفرض Graph Impact از شباهت برداری (embedding similarity) استفاده نمیکند. با قرار دادن مسیریابی لغتنامهای (lexical routing) و جستوجوی برداری در حافظههای (cache) جداگانه و مرزهای شکست مجزا، ابزار یک مرز تفسیرپذیر را حفظ میکند. هر نتیجه مشخص میکند که آیا از طریق شباهت معنایی آمده است یا از طریق شواهد نگهداری شده مانند مسیرهای README. این رویکرد در واقع تلاشی برای کاهش نرخ خوانش تصادفی فایلها از طریق استفاده از گرافهای دانش کد است.
برای برنامهنویس، این یعنی کاهش «مالیات مستندسازی». اگر فهرست مطالب یک مستند، یک نقشه پیشرو از یک پرسش محصول به مشخصات فنی است، Graph Impact یک نقشه معکوس از تغییرات کد به بخشهایی است که باید بازبینی شوند.
برای پیادهسازی این گردش کار، این مراحل را دنبال کنید: تغییر فایل $ \rightarrow $ اجرای graph impact $ \rightarrow $ بازبینی مشخصات و تستهای مرتبط $ \rightarrow $ بهروزرسانی کد و مستندات لازم $ \rightarrow $ اجرای تستها و dotdotgod validate. چون کش گراف یک داده مشتقشده است، مشخصات سورس و کد همیشه مبنای قضاوت باقی میمانند.
گام بعدی شما
- گردش کار خود را به این ترتیب تغییر دهید: تغییر فایل $ \rightarrow $ اجرای graph impact $ \rightarrow $ بازبینی مستندات و تستهای مرتبط $ \rightarrow $ بهروزرسانی کد و مستندات $ \rightarrow $ اجرای
dotdotgod validate. - تگهای ردیابی صریح مانند
verified_byرا به فایلهای Markdown خود اضافه کنید تا دقت گراف افزایش یابد. - از خروجی
--jsonبرای تحلیل عمیقتر امتیازات و اتوماسیون فرآیندهای QA استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو