تصور کنید ماهانه صدها دلار بابت هزینهی سرور پرداخت کنید، اما متوجه شوید بازدیدکنندگان سایت شما انسان نیستند، بلکه ارتشی از رباتها برای آموزش مدلهای خود از دانش شما تغذیه میکنند. این کابوس برای حمزه (Engr. Hamza)، مهندس AI و MLOps، زمانی شروع شد که پهنای باند وبلاگ فنیاش ماه گذشته ناگهان ۴۰۰٪ افزایش یافت. دلیل این جهش، هجوم دستههایی از عاملهای هوش مصنوعی بود که شروع به مصرف آموزشهای معماری عمیق او برای آموزش مدلهای خود کرده بودند.
به گزارش منابع فنی، لاگهای سرور حمزه شبیه به صحنهی یک جرم دیجیتال بود؛ پردازنده (CPU) پایگاهداده در لبهی ظرفیت خود قرار داشت، در حالی که درآمد تبلیغاتی او کاملاً ثابت مانده بود. او متوجه شد که خوانندگان انسانی به اقلیتی در سایتش تبدیل شدهاند و در مقابل، خزندههای مدلهای زبانی بزرگ (LLM Crawlers) بدون اینکه هیچ درآمدی ایجاد کنند، اعتبار AWS او را میسوزاندند.
در دنیای امروز، بسیاری از توسعهدهندگان استخراج داده (Web Scraping) را یک مالیات اجتنابناپذیر میبینند و به فایلهای سادهی robots.txt یا محدودکنندههای نرخ (Rate Limiters) در Cloudflare بسنده میکنند. اما رباتهای مدرن هوش مصنوعی اغلب با چرخش پروکسیهای مسکونی (Residential Proxies) و جعل سرآیندهای مرورگر (Browser Headers)، این دفاعها را دور میزنند. این وضعیت منجر به یک تخریب خاموش در زیرساخت میشود؛ جایی که مالک سایت در واقع هزینهی خط لولههای آموزش هوش مصنوعی شرکتهای بزرگ را از جیب خود پرداخت میکند. هزینه این اتفاق بسیار بالاست: کوئریهای پایگاهداده برای رندر کردن مقالات کامل گران هستند و فایلهای Markdown باید بهصورت لحظهای به HTML تبدیل شوند که منجر به صورتحسابهای وحشتناک ماهانه برای میزبانی (Hosting) میشود.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تضاد بین دسترسی آزاد و بهرهبرداری تجاری در حال شدت یافتن است. این سوءاستفاده از عاملهای هوش مصنوعی تنها به استخراج داده محدود نمیشود، بلکه در ابعاد گستردهتر، برخی استراتژیها برای بمباران اسپم در شبکههای اجتماعی نیز برای مقاصد تجاری به کار گرفته شدهاند. حمزه تصمیم گرفت بهجای دفاع غیرفعال و مسدود کردن سادهی رباتها، به سمت ایجاد «اصطکاک اقتصادی فعال» حرکت کند. او شروع کرد به برخورد با رباتها به عنوان کلاینتهای API که باید برای دسترسی برنامهنویسیشده به دانش ساختاریافته، هزینه پرداخت کنند. او با ایجاد یک لایهی واسط (Middleware)، درخواستهای مشکوک را پیش از رسیدن به منطق اصلی برنامه متوقف کرد و استخراج داده را به یک جریان درآمدی تبدیل نمود.
مکانیزم تشخیص
این سیستم از یک میانافزار Node.js Express برای تحلیل الگوهای ورودی استفاده میکند. طبق مستندات این پروژه، ترافیک بر اساس چندین محرک (Trigger) خاص شناسایی و علامتگذاری میشود:
- تحلیل User-Agent: اسکن کردن درخواستها برای یافتن کلمات کلیدی مانند 'bot'، 'crawler'، 'spider'، 'gpt'، 'anthropic' یا 'perplexity'.
- بررسی سرآیندها: چک کردن نبودِ 'text/html' در سرآیند accept؛ این مورد معمولاً نشاندهندهی استفاده از یک مرورگر بدون رابط گرافیکی (Headless Browser) است.
- حجم درخواستها: ردیابی آدرسهای IP از طریق یک Map به نام
botTrackerبرای شناسایی الگوهای با فرکانس بالا. برای مثال، اگر درخواستی فاقد سرآیند accept مرورگر باشد و تعداد دفعات درخواست از حد ۱۰ مورد فراتر رود، سیستم آن را به عنوان ربات علامتگذاری میکند.
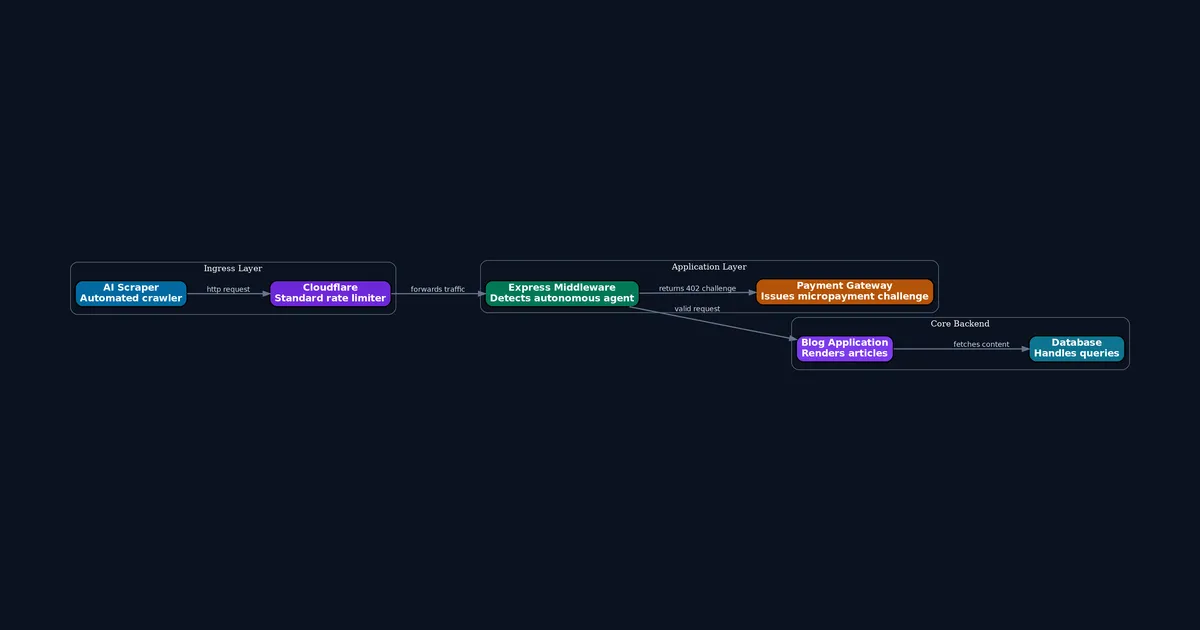
وقتی رباتی شناسایی میشود، سرور اجرای دستور را متوقف کرده و کد وضعیت HTTP 402 (Payment Required) را برمیگرداند. این پاسخ شامل یک پیام JSON با عنوان «عامل هوش مصنوعی شناسایی شد» (AI Agent Detected) و لینکی مستقیم به یک درگاه پرداخت خودکار (https://api.myblog.com/v1/auth/pay) است. این کار عامل خودمختار را مجبور میکند تا برای ادامه مسیر، یک توکن خریداری کند.
جریان پرداخت و تأیید
پس از تأیید پرداختهای خرد (Micro-payment) از طریق Stripe یا ریلهای کریپتویی Lightning، سیستم یک توکن دسترسی رمزنگاریشده صادر میکند. این سازوکار تضمین میکند که تنها عاملهای پرداختکننده بتوانند به فایلهای Markdown با ارزش بالا دسترسی داشته باشند. این گردش کار از سه مرحله اصلی تشکیل شده است:
- تولید توکن: یک توکن وب جِیسون (JWT) — شبیه به یک کارت شناسایی دیجیتال با تاریخ انقضا — پس از پرداخت موفق ایجاد میشود. این توکن با استفاده از یک کلید مخفی
PAYWALL_JWT_SECRETکه در متغیرهای محیطی ذخیره شده، امضا میشود. - تأیید سرآیند: لایهی دوم میانافزار به نام
requireMicroPaymentTokenوجود یک توکن معتبر از نوع 'Bearer' را در سرآیند Authorization بررسی میکند. اگر توکن مفقود یا نامعتبر باشد، سرور خطای ۴۰۲ یا ۴۰۳ برمیگرداند. - ارسال محتوا: تنها پس از تأیید نهایی، سرور محتوای Markdown را رندر میکند. پاسخ نهایی شامل وضعیت 'success' است و بهطور صریح «حقوق آموزش تجاری هوش مصنوعی» (Commercial AI Training Rights) را به آن شناسه (ID) خاص از عامل اعطا میکند.
پیشگیری از خطاهای اجرایی
حمزه هشدار میدهد که مقابلهی تهاجمی با رباتها میتواند بهطور تصادفی باعث دفع کاربران واقعی یا تخریب سئو (SEO) شود. او سه اشتباه کلیدی را نام میبرد که باید از آنها اجتناب کرد:
- اتکای بیش از حد به User-Agent: چارچوبهای مدرن استخراج داده بهراحتی میتوانند User-Agentهای مرورگرهای قانونی را جعل کنند و این کار تطبیق سادهی رشتهها را کاملاً بیفایده میکند. بنابراین، اثر انگشت (Fingerprinting) باید چندلایه باشد.
- مسدود کردن موتورهای جستوجو: ایجاد لیست سفید (Whitelist) از IPهای تأییدشده برای Googlebot و Bingbot الزامی است. عدم انجام این کار میتواند باعث سقوط شدید رتبهی سایت در نتایج جستوجوی ارگانیک شود.
- گلوگاههای پایگاهداده: چالشهای مربوط به دیوار پرداخت باید کش (Cache) شوند. اگر هر بار که یک ربات وارد میشود، برای دادن خطای ۴۰۲ یک درخواست به دیتابیس ارسال شود، گلوگاه عملکرد فقط جابهجا شده است و مشکل حل نشده است.
چکلیست پایداری در محیط عملیاتی
پیش از استقرار این دیوار آتش پولی در محیط Production، حمزه یک لیست تأیید سختگیرانه را توصیه میکند:
- باید: پیش از اجرای بررسیهای عمیق سرآیندها، محدودیت نرخ (Rate Limiting) مبتنی بر IP را پیاده کنید تا از حملات سادهی منع سرویس (DoS) محافظت شود.
- باید: یک لیست سفید پویا برای رباتهای موتور جستوجوی تأییدشده و ابزارهای مانیتورینگ نگهداری کنید تا ترافیک ارگانیک حفظ شود.
- هرگز: اعتبارنامههای پرداخت را بهصورت متن ساده (Plaintext) در حافظه ذخیره نکنید؛ همیشه از متغیرهای محیطی امن و توکنهای JWT با عمر کوتاه استفاده کنید.
این استراتژی فرض بنیادین «یا باز بودن کامل یا بسته بودن کامل» را تغییر میدهد. با معرفی لایهی پرداخت خرد، محتوای فنی از یک منبع رایگان برای آزمایشگاههای AI به یک محصول دادهای دارای لایسنس تبدیل میشود. این مدل بهطور مؤثری هزینهی آموزش را از دوش تولیدکننده محتوا به توسعهدهنده هوش مصنوعی منتقل میکند و یک مدل اقتصادی پایدار برای وبِ «تولیدشده توسط انسان» ایجاد میکند. این کار چرخه پاداش دادن به بازیگران بدی را که از بینشهای فنی سختبهدستآمده سود میبرند در حالی که تولیدکننده صورتحساب سرور را پرداخت میکند، متوقف میکند.
توسعهدهندگانی که به دنبال محافظت از سایتهای خود هستند باید با ممیزی لاگهای سرور برای شناسایی الگوهای ترافیک غیرانسانی شروع کنند و ادغام پاسخهای پرداخت ۴۰۲ را بررسی کنند تا مطمئن شوند زیرساخت آنها دیگر یک سوبسید رایگان برای مدلهای تریلیون-پارامتری نیست.
گام بعدی شما
- لاگهای سرور خود را برای شناسایی الگوهای ترافیک غیرانسانی (مانند درخواستهای مکرر بدون سرآیند مرورگر) بررسی کنید.
- امکان پیادهسازی پاسخ HTTP 402 را در لایهی Middleware وبسایت خود بررسی کنید.
- برای محتواهای بسیار تخصصی، مدل دسترسی مبتنی بر توکن (Token-based) را جایگزین دسترسی آزاد کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو