تصور کنید دستیاری دیجیتال دارید که دقیقاً میداند چه کتابهایی در قفسه شماست و آخرین مصاحبههای نویسندگان موردعلاقهتان را خوانده است. این تجربه، هدف نهایی Everlogue است تا مشکل همیشگی توهم در مدلهای زبانی را در حوزه توصیههای کتاب حل کند. پلتفرم Everlogue این معماری را پیادهسازی کرده است تا تعادلی میان دقت دادههای ساختاریافته و لحن گرم و انسانی در گفتگو ایجاد کند.
بسیاری از توصیههای هوش مصنوعی بر اساس دادههای کلی یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — ارائه میشوند. طبق گزارش توسعهدهندگان این پلتفرم، این رویکرد اغلب منجر به پیشنهاد کتابهای خیالی یا خلاصههای اشتباه از داستانها میشود، زیرا مدلها صرفاً بر اساس احتمالات آماری کلمات پاسخ میدهند. برای حل این بحران، Everlogue از یک معماری دوگانه استفاده کرده تا «کشف واقعبینانه» را از «گفتگوی عمیق» جدا کند و تضمین کند هر توصیه، عنوانی واقعی است که در اکوسیستم سیستم موجود است.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت و دقت مدلهای بازیابیافزا اشاره کردیم، کلید موفقیت در کاهش توهم، محدود کردن فضای پاسخدهی مدل است. Everlogue برای این کار از Sanity Content Lake و پروتکل زمینهٔ مدل (MCP) استفاده میکند تا شکاف بین دادههای خام و هوش مصنوعی گفتگومحور را پر کند و تجربهای مشابه یک فروشنده کتاب خبره را بازسازی کند.
معماری دوگانه: تفکیک مسیرها
این عامل برای مدیریت درخواستها از دو مسیر مجزا استفاده میکند تا جستوجوی کاتالوگ با پرسوجوهای واقعگرایانه مخلوط نشود و مدل دچار سردرگمی نشود:
- مسیر توصیه: این بخش با استفاده از زبان GROQ و ابزار
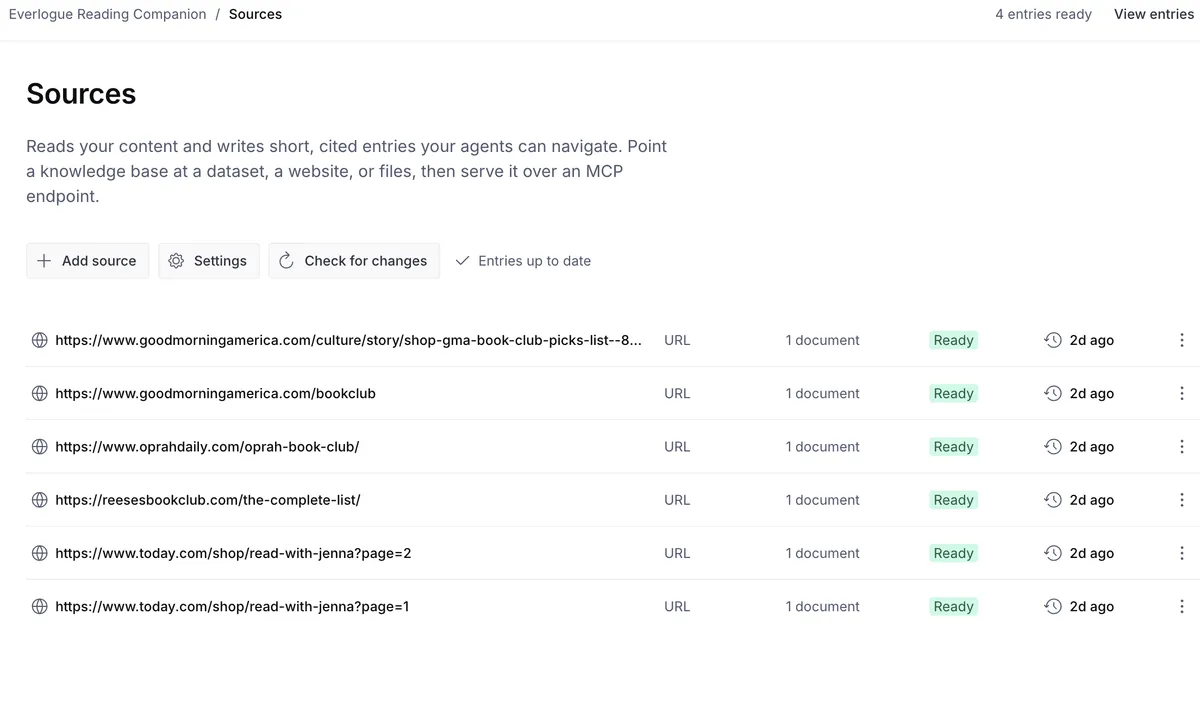
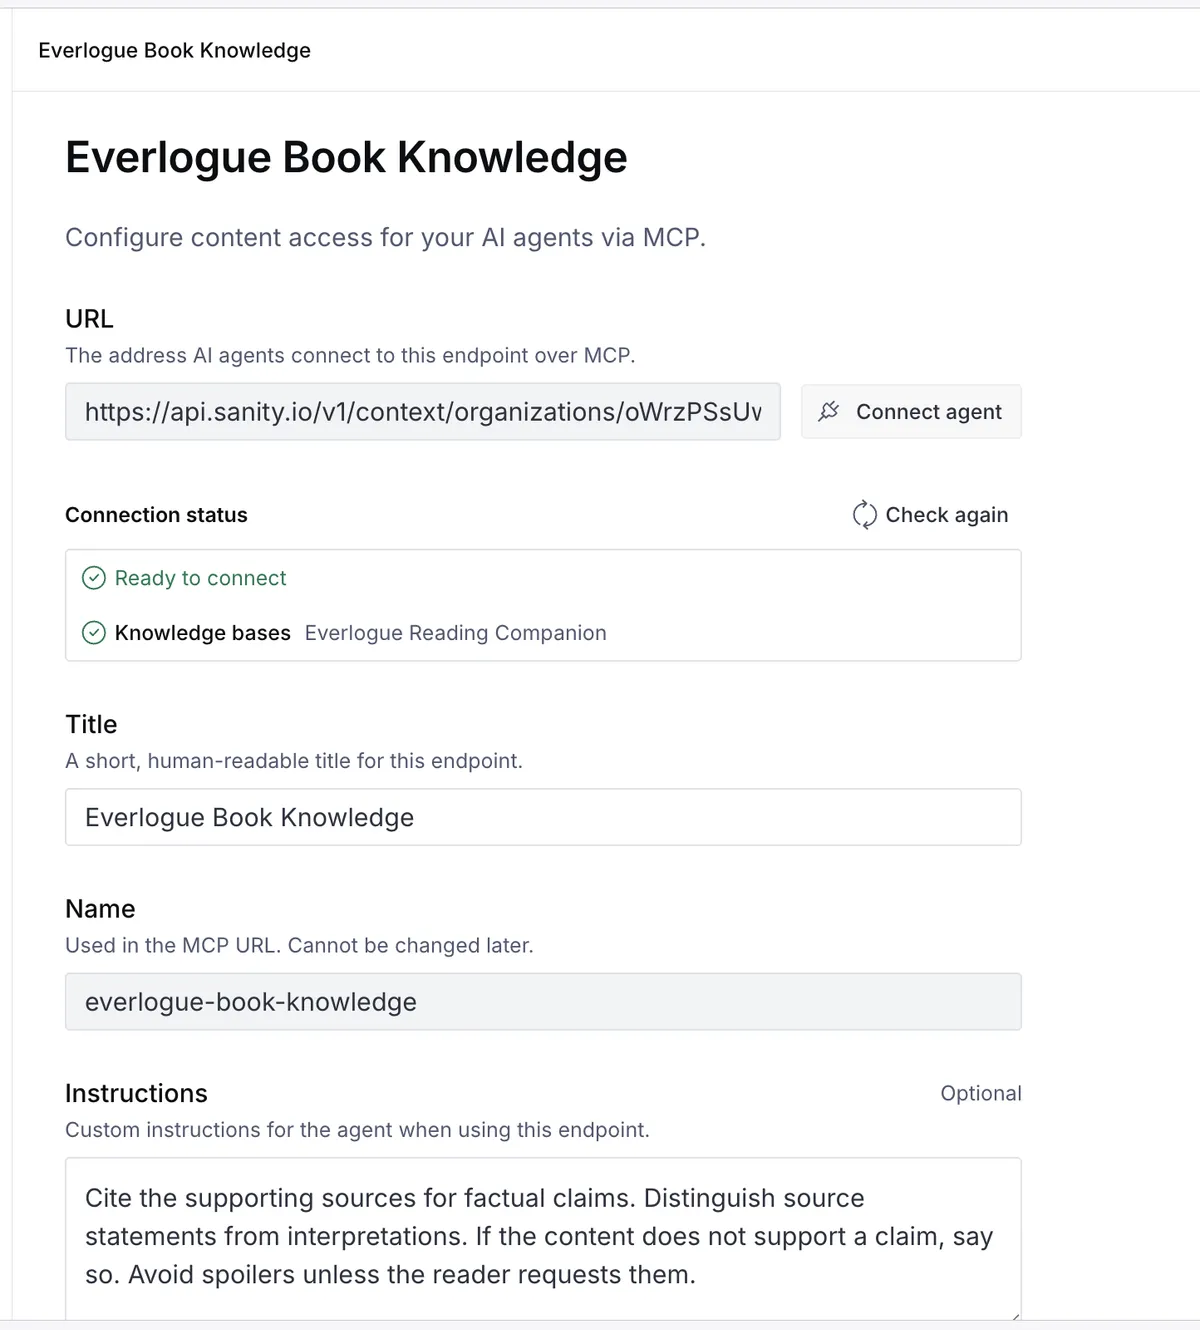
@sanity/clientمستقیماً کاتالوگ ساختاریافته را میکاود. سیستم کتابهایی را که کاربر در لیست «میخواهم بخوانم» (Want to Read) دارد شناسایی کرده و عناوینی را که قبلاً خوانده است یا در حال حاضر در حال مطالعه آنهاست، حذف میکند. در این مسیر، یک کتاب برای توصیه شدن لزوماً نیازی به داشتن مقاله در پایگاه دانش ندارد؛ یک عنوان که توسط کاربر وارد شده است میتواند تنها از طریق توصیفات کاتالوگ و ژانرهایش واجد شرایط توصیه شود. - مسیر پایگاه دانش: برای پاسخ به سوالات عمیقتر، عامل از طریق یک کلاینت MCP به نقطه انتهایی Everlogue Book Knowledge متصل میشود. این مسیر به مدل اجازه میدهد خلاصهها و مصاحبههای نویسندگان را از ۶ منبع وب منتخب بازیابی کند. در اینجا، پاسخهای مبتنی بر مقاله حتماً باید از منابع بازیابی شده استفاده کنند، در حالی که توصیههای مبتنی بر کاتالوگ نباید ارجاعات ساختگی به مقالات ابداع کنند.
رشد کاتالوگ و مدیریت دادهها
بنیاد این سیستم کاتالوگی است که با انتخابهای چهار باشگاه بزرگ کتاب آغاز شد: باشگاه کتاب ریس (Reese’s)، باشگاه کتاب اپرا (Oprah’s)، Read with Jenna و باشگاه کتاب GMA. این هسته اولیه، استانداردی برای کیفیت محتوا ایجاد کرد.
برای گسترش این کتابخانه، کاربران میتوانند فایلهای CSV خود را از Goodreads وارد کنند تا لیستهای «میخواهم بخوانم»، «در حال مطالعه» و «خوانده شده» آنها شخصیسازی شود. همچنین کاربران میتوانند هر کتابی را جستوجو کرده و به قفسه Everlogue خود اضافه کنند. اگر کتابی هنوز در کاتالوگ نباشد، این اقدام یک «درخواست برای بررسی» ایجاد میکند. پس از تایید توسط تیم مدیریت، کتاب به کاتالوگ مشترک میپیوندد و برای سایر کاربران نیز قابل کشف و توصیه میشود.
جزئیات فنی پیادهسازی
توسعهدهنده برای هسته پردازشی از مدل OpenAI gpt-5.4-mini استفاده کرده است. برای حفظ دقت و جلوگیری از خطاهای مدل، ابزارهای تخصصی زیر به کار گرفته شدهاند:
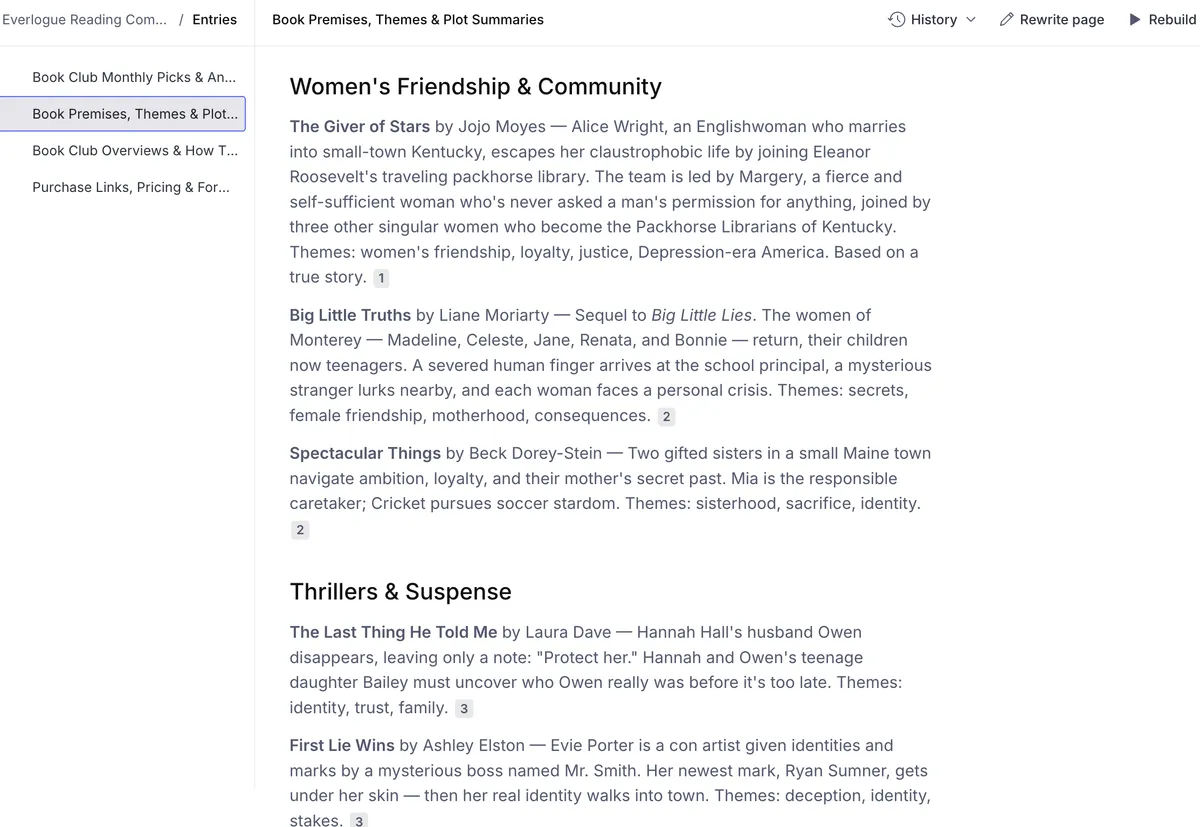
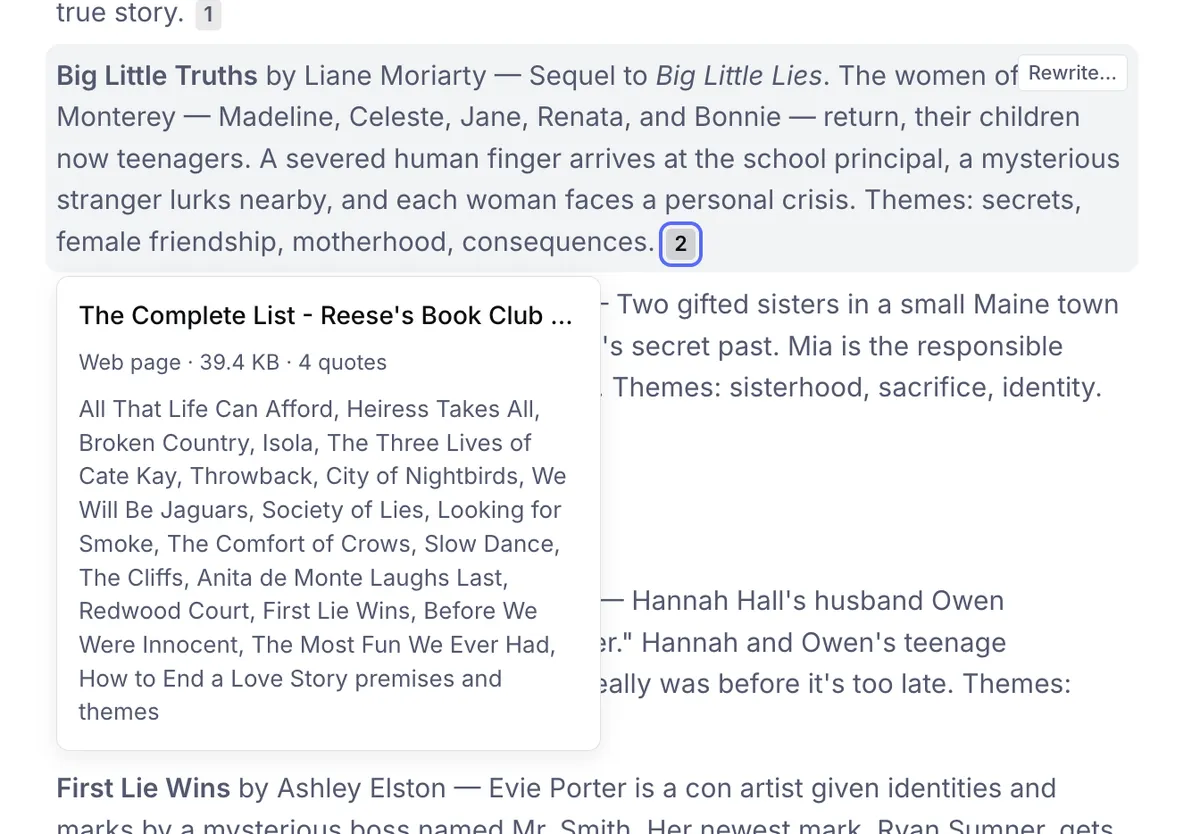
- Sanity Context: برای جذب اعلانهای باشگاههای کتاب، خلاصهها و مصاحبهها از ۶ منبع وب استفاده میشود. توسعهدهنده تمام این ورودیها و استنادها را بهصورت دستی بازبینی کرده است تا کیفیت ویراستاری پیش از رسیدن به دست عامل تضمین شود.
- ابزارهای MCP: عامل از
initial_contextبرای پیمایش در پایگاه دانش،knowledge_base_searchبرای یافتن ورودیهای مرتبط وknowledge_base_readبرای استخراج محتوای نهایی استفاده میکند. مدل موظف است پیش از پاسخ دادن، حتماً محتوا را بازیابی کرده و عناوین منابع و URLهایی را که واقعاً از آنها استفاده کرده است، ذکر کند. - احراز هویت: سیستم با استفاده از Clerk، پروفایل کاربر را شناسایی میکند تا قفسههای کتاب و بازخوردهای هر فرد بهصورت شخصیسازی شده مدیریت شود. هویت خواننده احراز شده تعیین میکند که کدام ورودیهای قفسه و بازخوردها باید اعمال شوند.
- روابط دادهای: Sanity روابط حیاتی بین کتابها و ژانرها، پروفایلهای خواننده، قفسهها و ورودیهای قفسه، امتیازها و نقدها را ذخیره میکند. همچنین اطلاعات اختیاری مانند تعداد صفحات و شماره سریال کتابها، امکان اعمال محدودیتهای صریح در هنگام توصیه را فراهم میکند.
بهینهسازی تجربه کاربری
برای اینکه تعاملات طبیعی به نظر برسند، قوانین سختگیرانهای برای مدیریت امتیازات پایین، ترجیحات فعلی کاربر، ترتیب سریالهای کتاب و جلوگیری از پیشنهادهای تکراری وضع شده است.
یکی از چالشهای فنی، کلمات «پرکننده» (Filler words) در جستوجوها بود. سیستم بهروزرسانی شد تا عباراتی مثل «کتابِ...» را از کوئریها حذف کند؛ بنابراین درخواست «درباره کتاب خانه در کاجها بگو» مستقیماً عنوان واقعی را در کاتالوگ جستوجو میکند، نه یک عبارت توصیفی را که در دیتابیس وجود ندارد.
همچنین برای حفظ لحن صمیمی و گرم، نام منابع و URLها از متن نهایی پاسخها حذف شدهاند تا گفتگو شبیه به چت با یک انسان باشد. جریان توصیه بهگونهای طراحی شده که ابتدا درخواست را تفسیر کند، کاندیداهای واجد شرایط را بازیابی کرده، حداکثر ۳ مورد را انتخاب کند و توضیحات کوتاهی بدون لو دادن داستان (Spoiler-free) بر اساس متادیتای موجود ارائه دهد.
ردیابی هزینه و عملکرد
برای پایداری اقتصادی و عملیاتی، Everlogue هر تعامل را در Sanity ثبت میکند. توسعهدهنده تعداد توکنهای هر سوال، ورودیهای کششده، مدتزمان پاسخدهی و نتایج نهایی را مانیتور میکند.
در تستهای اولیه، هزینه دو سوال زنده در مجموع حدود ۰.۰۱۵ دلار برآورد شده است. این ردیابی دانهبندی شده اجازه میدهد پلتفرم محدودیتهای مصرف روزانه را برای بازدیدکنندگان تعریف کرده و پنجرههای زمینه (Context Windows) را بهینه کند.
پایداری فنی همچنین با اصلاح خطاهای ورود اول (First-sign-in) بهبود یافت که مربوط به شناسایی پروفایل پس از احراز هویت Clerk بود. ساختار شناسایی پروفایل تغییر کرد تا از تراکنشهای ایجاد پروفایل در Sanity استفاده کند و جستوجوهای مجدد بهگونهای اصلاح شدند که از تکرار درخواستهای مموئیزه شده (Memoization) عبور کنند. علاوه بر این، شخصیسازی صفحه اصلی به پشت مرزهای بارگذاری (Loading Boundaries) مجزا منتقل شد و کوئریهای مستقل بهصورت موازی اجرا شدند تا دادههای کتابخانه همیشه تازه بمانند.
لایه ویراستاری: انسان در حلقه
برخلاف بسیاری از سیستمهای تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — که جذب داده را مرحله نهایی میبینند، Everlogue آن را یک فرآیند ویراستاری میداند. توسعهدهنده تمام ورودیهای مربوط به پیشفرضهای کتاب، مضامین و گفتگوهای نویسندگان را بازبینی و اصلاح کرده است.
این رویکرد «انسان در حلقه» (Human-in-the-loop) مانع از لو رفتن داستانها شده و تضمین میکند ادعاهای واقعگرایانه همیشه مستند باشند. برای مثال، در یک تست عملی روی کتاب The Christie Affair، سیستم توانست بهدرستی ابزارهای زمینه را فراخوانی کرده، شخصیت «نینا د گرامونت» را شناسایی کرده و پاسخی مستند ارائه دهد.
این معماری نقش هوش مصنوعی را از یک «نویسنده خلاق» به یک «کتابدار دقیق» تغییر میدهد. با جداسازی «چه بخوانیم» (کاتالوگ) از «چرا مهم است» (پایگاه دانش)، سیستم از تله ابداع ارجاعات برای کتابهایی که فقط در قالب متادیتا وجود دارند، رها میشود.
برای توسعهدهندگان، این پروژه ثابت میکند که موثرترین عاملها لزوماً آنهایی نیستند که پرامپتهای بزرگتری دارند، بلکه آنهایی هستند که مرزهای دادهای دیسیپلینشدهای دارند. استفاده از MCP اجازه میدهد عامل سبک بماند و در عین حال به دانش خارجی گسترده و تاییدشده دسترسی داشته باشد.
اگر در حال ساخت عاملی با محتوای حجیم هستید، بررسی کنید که چگونه پروتکل MCP میتواند بازیابی دادهها را از منطق اصلی مدل جدا کند تا نرخ توهم کاهش یابد.
گام بعدی شما
- اگر در حال ساخت عاملی با محتوای حجیم هستید، بررسی کنید که چگونه پروتکل MCP میتواند بازیابی دادهها را از منطق اصلی مدل جدا کند تا نرخ توهم کاهش یابد.
- برای کاهش هزینههای استنتاج، سیستم ردیابی توکن به توکن مشابه Everlogue را برای مانیتورینگ مصرف API خود پیاده کنید.
- لایه ویراستاری انسانی را به جای تکیه بر جذب خودکار دادهها در سیستمهای RAG قرار دهید تا کیفیت خروجیها تضمین شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو