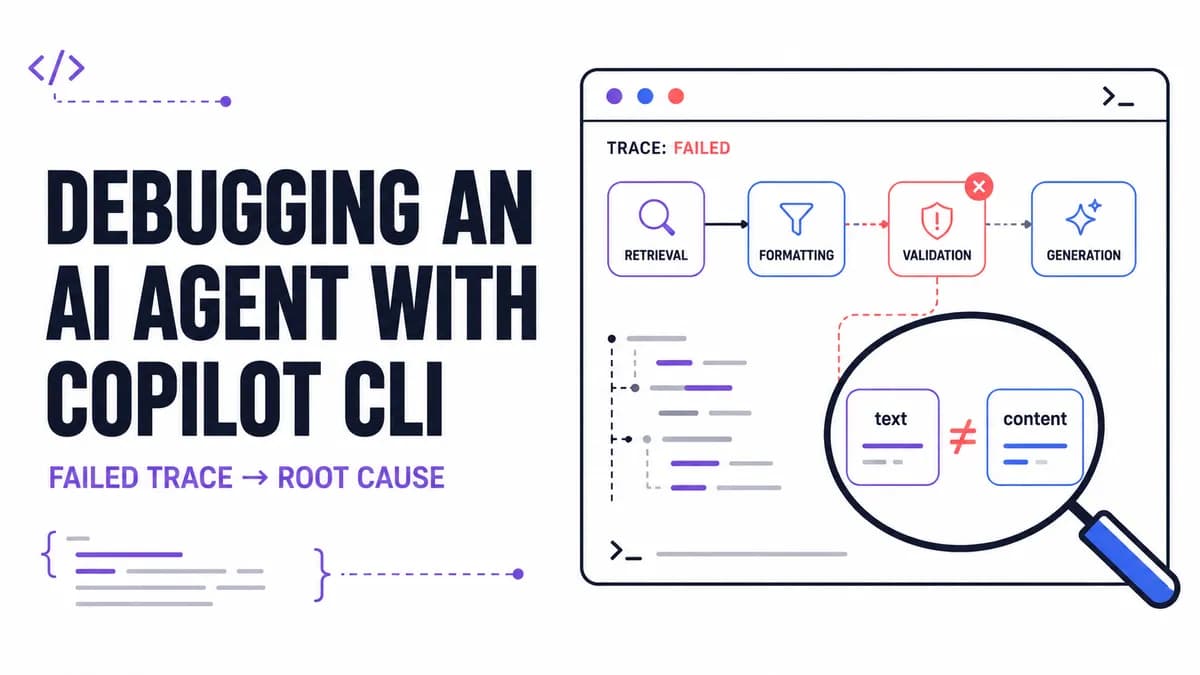
تصور کنید با کابوس عیبیابی یک عامل هوش مصنوعی (AI Agent) سر و کار دارید که هرگز کرش نمیکند، اما بهسادگی پاسخهای غلط تولید میکند. در ۲ سپتامبر ۲۰۲۶، یک آزمایش عملی نشان داد که GitHub Copilot CLI چگونه میتواند با خواندن ردپاهای ساختاریافته (Structured Execution Traces) از طریق پروتکل زمینهٔ مدل (MCP) — بهجای اسکن هزاران خط لاگ خام — این مشکل را حل کند.
بسیاری از توسعهدهندگان در حال حاضر برای یافتن خطاهای عاملها به یک «دیوار از لاگها» تکیه میکنند. این روش ناکارآمد است زیرا شکستهای عاملها اغلب به مسیر زمان اجرا (Runtime Path) وابسته است — یعنی اینکه کدام ابزار اجرا شده و بین مرحله بازیابی و تولید چه اتفاقی افتاده است — نه یک Stack Trace دراماتیک. چالش اصلی اینجاست که یک مرحله میتواند از نظر فنی موفق باشد (هیچ خطایی پرتاب نشود) اما از نظر رفتاری اشتباه باشد. این موضوع بهویژه برای توسعهدهندگان فولاستک که با Next.js، TypeScript، اپلیکیشنهای MERN و ویژگیهای هوش مصنوعی در اکوسیستمهایی مانند TheCampusCoders کار میکنند، حیاتی است.
برای حل این مشکل، در این آزمایش از AgentInspect استفاده شد؛ ابزاری که برای ثبت مرزها (Boundaries) در جریانهای کاری عامل طراحی شده است. با قرار دادن منطق برنامه در توابع inspectRun() و step()، توسعهدهندگان میتوانند یک رکورد قطعی از آنچه عامل واقعاً انجام داده است ایجاد کنند. این کار یک خطای مبهم مانند «زمینه کافی نیست» را به توالی قابل ردیابی از رویدادها تبدیل میکند.
کالبدشکافی یک شکست خاموش
مورد تست در این آزمایش، یک عامل کمک-پروژه بود که با TypeScript و Next.js ساخته شده بود. جریان کاری عامل ساده بود: بازیابی پنج تکه (Chunk) از اسناد، قالببندی آنها در قالب یک زمینه (Context)، اعتبارسنجی آن زمینه و در نهایت تولید پاسخ.
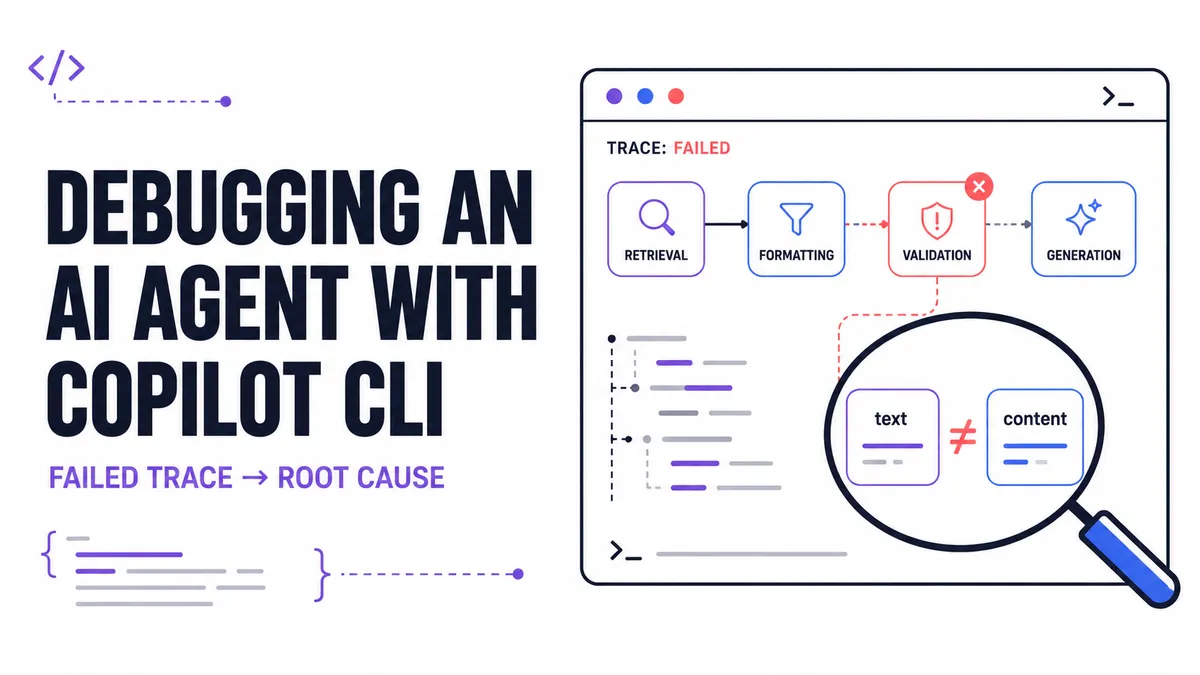
یک باگ ظریف در بخش قالببند (Formatter) ایجاد شده بود. ابزار بازیاب (Retriever) دادهها را در این ساختار بازمیگرداند:type RetrievedChunk = { id: string; text?: string; content?: string; };
با این حال، تابع قالببند از فیلد اختیاری اشتباهی استفاده میکرد:function formatContext(chunks: RetrievedChunk[]) { return chunks.map((chunk) => chunk.content ?? "").join("\n\n"); }
از آنجایی که دادهها در واقع در فیلد text قرار داشتند و تایپهای ادغام (Integration Types) سست بودند، TypeScript کد را رد نکرد و تابع نیز هیچ خطایی پرتاب نکرد. عامل بهسادگی یک رشته خالی را به مدل زبانی بزرگ (LLM) ارسال کرد، که منجر به یک پیام شکست کلی با مضمون «زمینه پروژه کافی نیست» شد.
ثبت مرزهای کاربردی
برای تضمین تکرارپذیری، در این آزمایش از Node.js نسخه ۲۰ یا جدیدتر استفاده شد و هر دو بسته AgentInspect روی نسخه پایه ۶.۱۷.۴ با دستورات زیر تثبیت شدند:
npm install [email protected]npm install --save-dev @agent-inspect/[email protected]
جریان کاری با inspectRun("project-help-agent-broken", ...) پوشانده شد و از تابع step() برای نامگذاری مرزهای حیاتی استفاده شد. بهطور مشخص، توسعهدهنده از step.tool برای بازیابی و از step برای منطق برنامه استفاده کرد و متادیتایی مانند returnedField: "text" و mapperField: "content" را به مرحله قالببندی افزود.
برای ردیابی موفقیت رفتاری، تابع observeOutcome در یک مرحله به نام validate_context به کار رفت. این کار یک بررسی سفارشی ایجاد کرد تا ببیند آیا context.trim().length > 0 است یا خیر. اگر طول رشته صفر بود، وضعیت به عنوان «شکست خورده» (failed) علامت میخورد، حتی اگر کد بدون کرش اجرا شده باشد. در نهایت، از step.llm() برای برچسبگذاری مرز تولید پاسخ استفاده شد. برای جلوگیری از تغییرات تصادفی مدل (Model Variance)، بهجای یک ارائهدهنده LLM زنده، از یک تابع قطعی (Deterministic) استفاده شد.
«موفقیت» در برابر «درستی»
پس از اجرای تست، توسعهدهنده آخرین ردپا را لیست کرد و گزارش را با دستورات زیر بررسی نمود:npx agent-inspect list --dir .agent-inspectnpx agent-inspect report <run-id> --dir .agent-inspect
گزارش یک نتیجه متناقض را نشان داد: وضعیت کلی «موفق» (success) بود و ۴ مرحله (۱ مدل زبانی، ۱ ابزار، ۲ منطق) کامل شده بودند، اما خروجی مشاهدهشده context_available شکست خورده بود. این موضوع ثابت کرد که اجرای موفق جاوااسکریپت لزوماً به معنای نتیجه رفتاری درست نیست.
برای اینکه این فرآیند برای CI/CD کاربردی باشد، توسعهدهنده از یک بررسی قطعی استفاده کرد:npx agent-inspect check <run-id> --dir .agent-inspect --fail-on-observation failed
این دستور وضعیت «شکست» را بازگرداند و یک روش برنامهریزیشده برای شکار شکستهای خاموش عامل فراهم کرد که ابزارهای تست سنتی از آن میگذشتند.
اتصال استک عیبیابی
برای تشخیص این مشکل، توسعهدهنده AgentInspect را از طریق یک سرور MCP محلی (stdio) به GitHub Copilot CLI متصل کرد. این کار با افزودن یک فایل پیکربندی .mcp.json در سطح پروژه انجام شد:
{
  "mcpServers": {
    "agent-inspect": {
      "type": "local",
      "command": "npx",
      "args": [
        "-y",
        "@agent-inspect/[email protected]",
        "--dir",
        ".agent-inspect"
      ],
      "tools": [
        "list_recent_runs",
        "get_trace_facts",
        "get_execution_tree",
        "get_first_causal_failure",
        "get_failed_observations",
        "compare_runs"
      ]
    }
  }
}
در حالی که Copilot CLI از پیکربندی سطح کاربر در ~/.copilot/mcp-config.json پشتیبانی میکند، برای این تست محدوده سطح پروژه ترجیح داده شد. پس از اعتماد به پوشه، توسعهدهنده سرور را با دستور /mcp show agent-inspect تأیید کرد. اگرچه سرور ۱۲ ابزار اصلی فقط-خواندنی را ارائه میدهد، اما برای متمرکز نگه داشتن مجموعه ابزارها، تنها ۶ ابزار ذکر شده در بالا فعال شدند.
بهجای اینکه از هوش مصنوعی بخواهد «عامل را درست کن»، توسعهدهنده از یک پرامپت بسیار محدود استفاده کرد. این پرامپت از Copilot میخواست که پاسخ خود را به چهار دسته مجزا تقسیم کند: حقایق ثبتشده (Persisted Facts)، اولین شکست علی (First Causal Failure)، تشخیص احتمالی و کد منبع خاصی که باید بررسی شود. همچنین صراحتاً ویرایش فایلها بدون تأیید قبلی ممنوع شد.
تشخیص مبتنی بر شواهد
Copilot حدس نزد؛ بلکه زنجیرهای از شواهد ارائه شده توسط سرور MCP را دنبال کرد:
- موفقیت بازیابی: ابزار
retrieve_project_docsبا موفقیت به پایان رسید. - حجم دادهها: پنج تکه داده از مرز بازیابی عبور کردند (
retrievedChunkCount: 5). - ناهماهنگی فیلد: قالببند منتظر
contentبود اما فیلد بازگشتیtextبود (returnedField: "text", mapperField: "content"). - زمینه خالی: مرز پرامپت دارای صفر کاراکتر قابل استفاده بود (
usableCharacterCount: 0). - شکست مشاهدهشده: بررسی
context_availableصراحتاً شکست خورد. - جریان اجرا: یک مرحله برچسبگذاری شده با LLM پس از شکست اعتبارسنجی ظاهر شد.
ابزار get_first_causal_failure در اینجا حیاتی بود. این ابزار خروجی مشاهدهشده شکستخورده و مرحله والد آن را شناسایی کرد، بدون اینکه علیت را صرفاً بر اساس برچسبهای زمانی (Timestamps) فرض کند. بر اساس این حقایق، Copilot خط دقیق کد را که باعث خطای نگاشت (Mapping) شده بود شناسایی کرد و پیشنهاد داد .map((chunk) => chunk.content ?? "") به .map((chunk) => chunk.text ?? "") تغییر یابد.
توسعهدهنده با اجرای مجدد تست و تأیید اینکه انتظار قطعی اکنون از طریق npx agent-inspect check پاس میشود، اصلاحیه را تأیید کرد.
استقرار مرزهای اعتماد
این گردشکار یک تفکیک مسئولیت حیاتی ایجاد میکند. AgentInspect حقایق زمان اجرا را حفظ میکند، سرور MCP نمای محدودی از آن حقایق را ارائه میدهد و GitHub Copilot CLI آن حقایق را به کد منبع متصل میکند. توسعهدهنده انسانی به عنوان داور نهایی باقی میماند و تصمیم میگیرد که آیا فرضیه درست است یا خیر، پیش از آنکه هرگونه تغییر در کد اعمال شود.
جزئیات مرز سرور MCP
بسیار مهم است که بدانیم سرور @agent-inspect/mcp-server (که در زمان تست در حالت Preview بود) چه کارهایی انجام میدهد و چه کارهایی انجام نمیدهد:
آنچه انجام میدهد:
- خواندن ردپاها (Traces) از دایرکتوری محلی پیکربندی شده.
- بازگرداندن نتایج محدودشده و حذفشده از پروفایلهای اشتراکی بهصورت پیشفرض.
- ارائه ساختار اجرا، مشاهدات شکستخورده و TraceFacts.
- فراهم کردن شناسههای پایدار برای اجراها و رویدادها جهت ارجاع.
آنچه انجام نمیدهد:
- فراخوانی ابزارها در داخل اپلیکیشن هدف.
- بازپخش (Replay) اجرای عامل.
- ویرایش کد منبع یا تغییر در ردپاها.
- اعمال خودکار اصلاحات.
حریم خصوصی با ثبت متاداده بهجای پرامپتهای خام یا دادههای حساس مشتری مدیریت میشود. در حالی که فرآیند MCP محلی است، توسعهدهنده اشاره میکند که حقایق بازگشتی به کلاینت ممکن است طبق طرح GitHub کاربر و سیاستهای سازمان به سرویس مدل ارسال شوند. قوانین عملی برای این مورد شامل عدم قرار دادن اسرار (Secrets) در نام مراحل و در نظر گرفتن GitHub Copilot به عنوان یک مرز اعتماد مجزا است.
محدودیتها و موازنه
این روش یک راهکار جادویی برای تمام باگهای عامل نیست. این متد نیازمند ابزارگذاری (Instrumentation) معنادار در مرزهای مهم است؛ یک مرحله با نامگذاری بد یا متادیتای گمراهکننده همچنان میتواند هوش مصنوعی را به اشتباه بیندازد. علاوه بر این، ردپاهای مبتنی بر متاداده نمیتوانند هر شکست معنایی یا مشکل کیفیت پرامپت را توضیح دهند.
سایر محدودیتها عبارتند از:
- سرور MCP در حالت Preview است، به این معنی که سطح ابزارها ممکن است تغییر کند.
- این یک گردشکار توسعه محلی و CI است، نه یک ابزار مانیتورینگ برای ناوگان تولید (Production Fleet).
- نتیجه کاملاً به کیفیت ابزارگذاری ارائه شده توسط توسعهدهنده وابسته است.
با این حال، برای توسعهدهندگان TypeScript، این الگو بهطور قابل توجهی قابلاعتمادتر از چسباندن لاگها در یک پنجره چت است. این کار فضای جستجو را کاهش میدهد و از توهم (Hallucination) هوش مصنوعی درباره علتها بر اساس زمانبندیهای تصادفی در فایل لاگ جلوگیری میکند.
این تغییر، عیبیابی عاملها را از یک بازی حدسزدن احتمالی به یک حلقه منضبط تبدیل میکند: رفتار شکستخورده $\rightarrow$ ردپای محلی $\rightarrow$ حقایق محدود $\rightarrow$ فرضیه $\rightarrow$ تغییر کد تاییدشده.



گفتگو