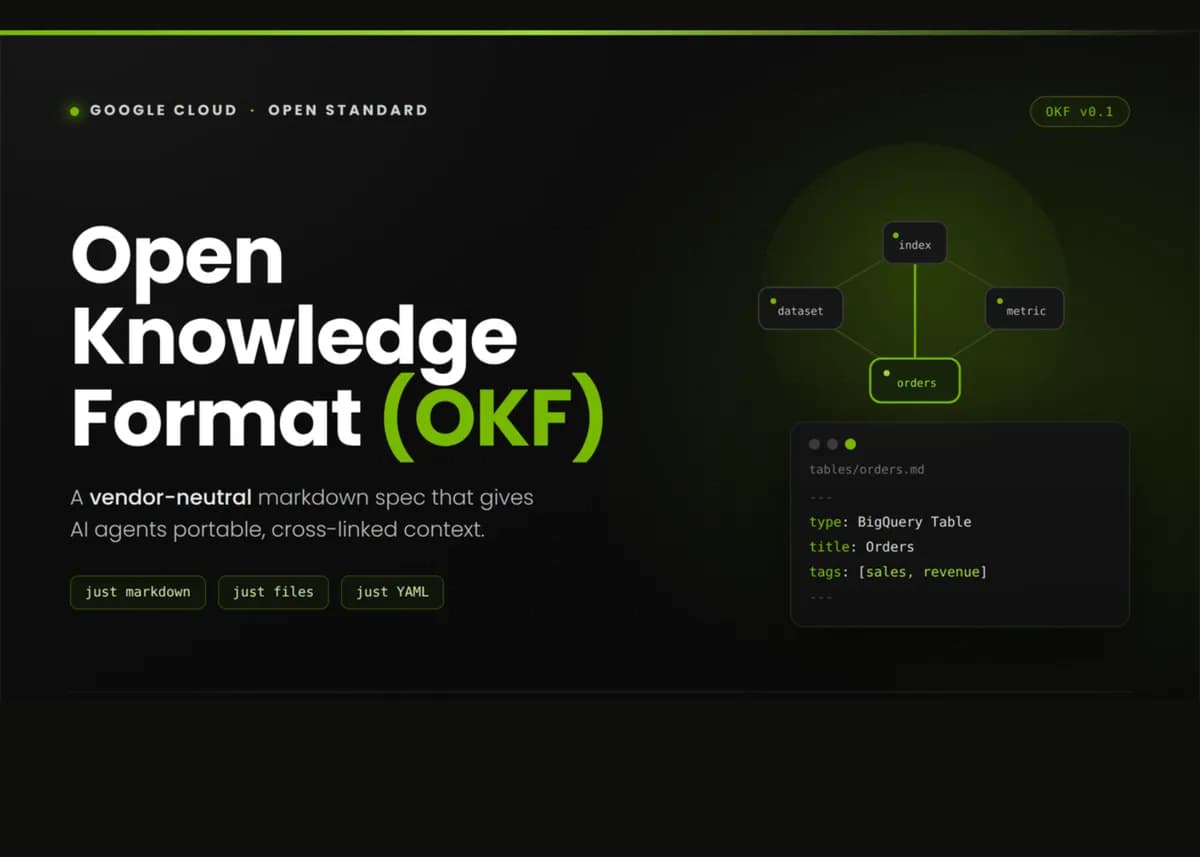
عاملهای هوش مصنوعی تنها به اندازه دانشی که به آن دسترسی دارند، کارآمد هستند؛ اما واقعیت این است که اکثر دادههای سازمانی در سیلوهای ناسازگار زندانی شدهاند. گوگل کلود (Google Cloud) برای شکستن این بنبست، نسخه ۰.۱ قالب دانش باز (Open Knowledge Format یا OKF) را معرفی کرد. این یک مشخصه (Specification) است که طراحی شده تا ویکیها و کاتالوگهای پراکنده را به استانداردی قابلحمل و تعاملپذیر برای زمینهی (Context) مدلهای زبانی بزرگ (LLM) تبدیل کند.
بسیاری از سازمانها با مشکل «زمینه تکهتکه» (fragmented context problem) دستوپنجه نرم میکنند. در این وضعیت، دادههای حیاتی — مانند طرحهای جداول (table schemas)، تعاریف معیارها (metric definitions)، مسیرهای Join و دستورالعملهای فنی (runbooks) — در APIهای مختلف، درایوهای مشترک، کامنتهای کد، docstringها و حتی در ذهن مهندسان ارشد پراکندهاند. طبق گزارش مارکتکپوست (marktechpost)، وقتی از یک عامل سؤال میشود «چگونه کاربران فعال هفتگی را از جریان رویدادها محاسبه کنم؟»، مدل باید پاسخ را از این سطوح پراکنده و متقابلاً ناسازگار جمعآوری کند. این وضعیت باعث میشود هر سازندهٔ عامل مجبور شود مشکل مونتاژ دادهها را از صفر حل کند، که منجر به تکرار گسترده تلاشها در سراسر صنعت میشود، زیرا هر فروشنده کاتالوگ، مدلهای دادهای یکسانی را دوباره اختراع میکند.
الگوی LLM-Wiki
مبانی مفهومی OKF به یک یادداشت (gist) در آوریل ۲۰۲۶ توسط آندری کارپاتی (Andrej Karpathy) درباره «ویکیِ مدل زبانی» بازمیگردد. کارپاتی استدلال کرد که در حالی که انسانها ثبت جزئیات و دفترداری در ویکیهای شخصی را خستهکننده مییابند، مدلهای زبانی در بهروزرسانی ارجاعات متقاطع و ویرایش همزمان چندین فایل مهارت دارند. مدلهای زبانی خسته نمیشوند و فراموش نمیکنند که لینکها را بهروزرسانی کنند.
OKF این الگو را رسمی میکند و از قراردادهای شخصی (bespoke) به سمت یک استاندارد جهانی میرود. پیش از این، الگوهای مشابهی مانند مخازن Obsidian که به عاملهای کدنویسی متصل بودند، مخازن «متادیتا به عنوان کد» یا فایلهای قراردادی خاص مانند AGENTS.md و CLAUDE.md دیده میشدند. اما چون هر یک از اینها سفارشی و خاص بودند، نمیتوانستند با یکدیگر تعامل داشته باشند. OKF لایهی تعاملپذیری را استاندارد میکند تا عاملها بتوانند کارهای سنگین سازماندهی را بر عهده بگیرند.
معماری فنی OKF
یک بسته OKF نه یک سرویس است و نه یک پلتفرم، بلکه صرفاً فهرستی (Directory) از فایلهای مارکداون (Markdown) است. این یک فرمت خنثی از نظر فروشنده است که هم برای عاملها و هم برای انسانها کاربرپسند است. هر فایل نماینده یک «مفهوم» (Concept) خاص است — مانند یک جدول BigQuery، یک مجموعه داده (dataset)، یک معیار، یک پلیبوک (playbook)، یک دستورالعمل (runbook) یا یک API — و مسیر فایل (file path) به عنوان شناسهی منحصربهفرد آن عمل میکند.
برای مثال، یک بسته مربوط به فروش میتواند چنین ساختاری داشته باشد:
sales/index.mdsales/datasets/orders_db.mdsales/tables/orders.mdsales/tables/customers.mdsales/metrics/weekly_active_users.md
هر فایل مفهومی از دو بخش اصلی تشکیل شده است:
- یک بلوک YAML در ابتدای فایل (front-matter) که حاوی متادیتای ساختاریافته است.
- بدنه مارکداون برای محتوای توصیفی.
در میان فیلدهای ساختاریافته، تنها یک فیلد اجباری است: type. سایر فیلدهای رزرو شده شامل title (عنوان)، description (توضیحات)، resource (منبع)، tags (برچسبها) و timestamp (برچسب زمانی) هستند. برای نمونه، یک ورودی جدول BigQuery، لینک منبع خود (مثلاً لینک console.cloud.google.com) و برچسبها را در بلوک YAML قرار میدهد، در حالی که جدول طرح (schema) — که جزئیاتی مانند ستونهای order_id و customer_id را شرح میدهد — در بدنه مارکداون قرار میگیرد.
تعاملپذیری و منطق گراف
OKF با استفاده از لینکهای بومی مارکداون، یک سیستم فایل استاندارد را به یک گراف دانش (Knowledge Graph) تبدیل میکند. این لینکها به عاملها اجازه میدهند بین مفاهیم مرتبط جابهجا شوند؛ مثلاً لینک کردن معیار «کاربران فعال هفتگی» به جدول خاص «سفارشات» که برای محاسبه آن استفاده شده است. این امر گرافی ایجاد میکند که غنیتر از روابط سادهی والد-فرزندی در سیستم فایل است.
برای تسهیل افشای تدریجی (progressive disclosure) و حسابرسی (auditing)، بستهها میتوانند بهطور اختیاری شامل فایلهای index.md برای ناوبری و فایلهای log.md برای ردیابی تاریخچه تغییرات باشند. بر اساس مستندات گوگل، چون این فرمت بر پایه YAML و Markdown استاندارد است، بهطور بومی در گیتهاب نمایش داده میشود، به صورت tarballهای ساده منتقل میشود و روی هر سیستم فایلی قابل سوار شدن (mount) است. هیچ طرح فشردهسازی، محیط اجرای (runtime) جدید و یا SDK اجباری وجود ندارد.
سه اصل طراحی
- حداقل سختگیری (Minimally opinionated): OKF دقیقاً یک فیلد را برای هر مفهوم اجباری میکند:
type. این مشخصه، سطح تعاملپذیری را تعریف میکند، نه مدل محتوا را؛ بنابراین هر چیز دیگری بر عهده تولیدکننده است. - استقلال تولیدکننده و مصرفکننده: بستهای که توسط انسان نوشته شده را میتوان توسط یک عامل خواند، و بستهای که توسط یک خط لوله (pipeline) تولید شده را میتوان در یک بصریساز (visualizer) مشاهده کرد. این فرمت به عنوان یک قرارداد عمل میکند و ابزارها را در هر دو طرف قابل تعویض میسازد.
- فرمت، نه پلتفرم: OKF به هیچ ابر، پایگاه داده، ارائهدهنده مدل یا چارچوب عاملی وابسته نیست. برای خواندن، نوشتن یا ارائه آن هرگز به یک حساب کاربری اختصاصی نیاز نخواهد بود.
OKF در مقابل RAG سنتی
یک تفاوت حیاتی بین OKF و تولید بازیابیافزا (RAG) وجود دارد. در حالی که RAG دانش را در لحظه پرسوجو از تکههای (chunks) خام و بدون ساختار داده با استفاده از مدلهای جاسازی (embedding models) و ذخیرهسازهای برداری استخراج میکند، OKF مفاهیم سازمانیافته و لینکشده را ذخیره میکند. این به عامل اجازه میدهد تا مستقیماً یک پایگاه دانش ساختاریافته را بخواند و بهروزرسانی کند، به جای اینکه به دنبال تکههای متنی مشابه بگردد. برخلاف شاخصهای RAG که قابلحمل نیستند و بر تکهها تکیه دارند، OKF قابلحمل است و بر پایه مفاهیم است.
پیادهسازی عملی
گوگل برای نمایش کاربرد این فرمت، ابزارهای مرجعی را منتشر کرده است که شامل یک عامل غنیساز BigQuery، یک بصریساز HTML استاتیک و سه بسته نمونه است. این فرمت برای چندین مورد کاربرد با تأثیر بالا طراحی شده است:
- متادیتا به عنوان کد: تیمهای داده میتوانند تعاریف جداول و معیارهای BigQuery را به صورت یک بسته صادر کرده، آنها را در کنترل نسخه (version control) در کنار SQLهای خود قرار دهند و تغییرات را از طریق Pull Requestها بررسی کنند.
- دستورالعملهای عاملی (Agentic Runbooks): عاملهای On-call میتوانند یک فایل
index.mdرا بخوانند، لینکهای متقاطع را دنبال کنند و مسیرهای Join خاص مورد نیاز برای رفع یک حادثه را پیدا کنند. - تبادل بین فروشندگان: فروشندگان ثالث میتوانند خروجی کاتالوگ خود را به صورت یک بسته OKF ارسال کنند و به عامل اجازه دهند مستقیماً و بدون هیچ کار یکپارچهسازی (integration)، آن را مصرف کند.
- ویکیهای تیم توسعه: تیمها میتوانند فضاهای قدیمی و بهروز نشده Notion یا Obsidian را با مارکداونهای نسخهبندی شدهای جایگزین کنند که یک عامل آنها را بهروز نگه میدارد.
از دیدگاه فنی، این اقدام فرض صنعت را از «دانش به عنوان یک پایگاه داده» به «دانش به عنوان یک سیستم فایل نسخهبندی شده» تغییر میدهد. گوگل شرطبندی کرده است که یک فرمت با حداقل سختگیری، سرعت پذیرش عاملها را در محیطهای مختلف ابری افزایش میدهد.
توسعهدهندگان میتوانند با استفاده از کتابخانههای استاندارد پایتون مانند pathlib و re و PyYAML برای تجزیه ساختار دایرکتوری و نقشهبرداری از گراف لینکها، شروع به ساخت مصرفکنندگان OKF کنند. نبود یک بکاند اجباری به این معناست که این بستهها میتوانند دقیقاً در کنار کدهایی که توصیف میکنند، در هر مخزن Git قرار بگیرند.
پذیرش گسترده این فرمت به این بستگی دارد که آیا سایر ارائهدهندگان بزرگ LLM آن را بپذیرند یا خیر. اما در حال حاضر، این طرح یک نقشه راه concrete برای هر کسی فراهم میکند که میخواهد از محدودیتهای RAG ساده فراتر رفته و به سمت یک معماری دانش سازمانیافته و عاملمحور حرکت کند.
گام بعدی شما
- اگر از RAG برای مدیریت دانش سازمانی استفاده میکنید، ساختار فایلهای خود را با الگوهای OKF (ترکیب YAML و Markdown) مقایسه کنید.
- برای تیمهای داده: تعاریف جداول BigQuery خود را به صورت فایلهای متنی در Git ذخیره کنید تا قابلیت نسخهبندی داشته باشند.
- مستندات فنی پروژه خود را از فرمتهای بسته به مارکداون لینکدار تبدیل کنید تا برای عاملهای آینده آماده شوید.
اما تأثیر این استاندارد بر نحوه آموزش مدلهای تخصصی حتی عمیقتر است — به تحلیل ما درباره Fine-tuning مدلهای بازمتن مراجعه کنید.



گفتگو