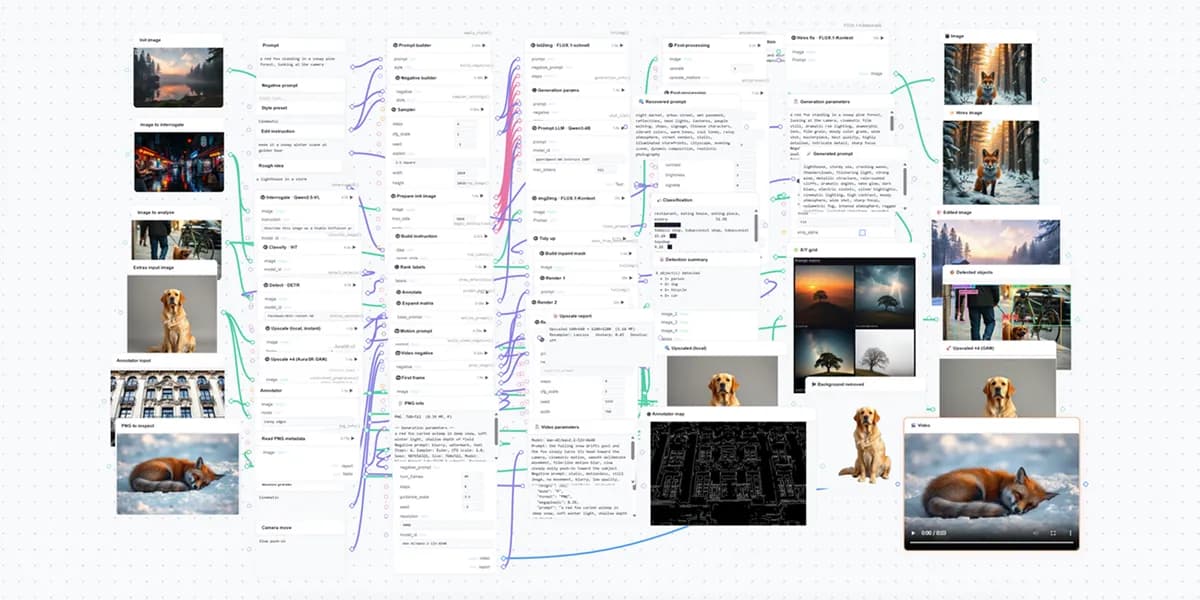
تصور کنید تمام قدرت یک ایستگاه کاری گرافیکی گرانقیمت را در یک تب مرورگر داشته باشید و دیگر نگران پر شدن حافظه VRAM نباشید. در ۱۰ سپتامبر ۲۰۲۶، شرکت Gradio با معرفی Workflow1111، استانداردهای تولید تصویر را تغییر داد و قابلیتهای AUTOMATIC1111 (stable-diffusion-webui) را در قالب یک سیستم گرهمحور (Node-based) بازسازی کرد. با این تغییر، یک بوم مرورگر واحد جایگزین نیاز به GPUهای قدرتمند محلی برای اجرای خطلولههای پیچیده تولید تصویر شد.
برای سالها، جامعهی هنر دیجیتال با نصبهای دشوار و نیاز به حافظه ویدیویی (VRAM) — که شبیه به فضای میز کار برای پردازش دادههاست — دستوپنجه نرم میکرد. اگرچه ابزارهایی مثل ComfyUI منطق گرهمحور را معرفی کردند، اما آنها اغلب به سختافزار محلی یا نمونههای پیچیده ابری وابسته بودند. همانطور که در تحلیلهای پیشین ما دربارهی دموکراتیزه شدن دسترسی به مدلهای بازمتن اشاره کردیم، حذف سد سختافزاری کلید رشد این اکوسیستم است. در همین راستا، مدلهایی مانند Pony Diffusion V6 XL با ارائه آزادی عمل بیشتر به هنرمندان، مسیر عبور از پلتفرمهای تجاری بسته را هموار کردند. Gradio اکنون بار محاسبات را به ابر منتقل کرده است؛ کاربران تنها با یک حساب Hugging Face یا ارائه یک توکن دسترسی میتوانند وارد شوند. پس از ورود، فراخوانی مدلها از سهمیهی پردازشی (Quota) خود کاربر استفاده میکند.
معماری Workflow1111
طبق مستندات فنی huggingface.co، معماری Workflow1111 از ۷۳ گره در ۱۱ خطلوله رسانهای متمایز تشکیل شده است. هر گره در این بوم، یکی از چهار عملگر اصلی را اجرا میکند و ورودیها و خروجیهای این عملگرها به پورتهایی تبدیل میشوند که لبهها (Edges) را برای اتصال به یکدیگر به کار میبرند:
- fn: توابع استاندارد پایتون برای مدیریت منطق و پسپردازش.
- model: مدلهایی که از طریق InferenceClient و توسط ارائهدهندگان استنتاج (Inference Providers) فراخوانی میشوند.
- space: محیطهای Gradio Spaces خارجی که روی هاب میزبانی شدهاند.
- dataset: ردیفهای خاصی که مستقیماً از مجموعهدادههای هاب استخراج میشوند.
خطلولههای اصلی تولید
خطلوله اصلی تبدیل متن به تصویر (Text-to-Image) — فرآیندی که در آن مدل توصیفات متنی را به پیکسل تبدیل میکند — دقیقاً تجربه کلاسیک A1111 را بازسازی کرده است. این بخش شامل کنترلهای پرامپت منفی، تعداد گامها (Steps)، CFG، بذر (Seed)، عرض، ارتفاع و یک فیلد model_id برای انتخاب چکپوینت مدل است. یک تابع «سازنده پرامپت» (Prompt-builder) ابتدا متن را پاکسازی کرده و پیشتنظیمات سبک (Style presets) را به آن اضافه میکند و سپس آن را به گره مدل میفرستد. برای تضمین ماندگاری دادهها، یک گره تابع پسپردازش، پارامترهای تولید را در متادیتای فایل PNG خروجی مینویسد.
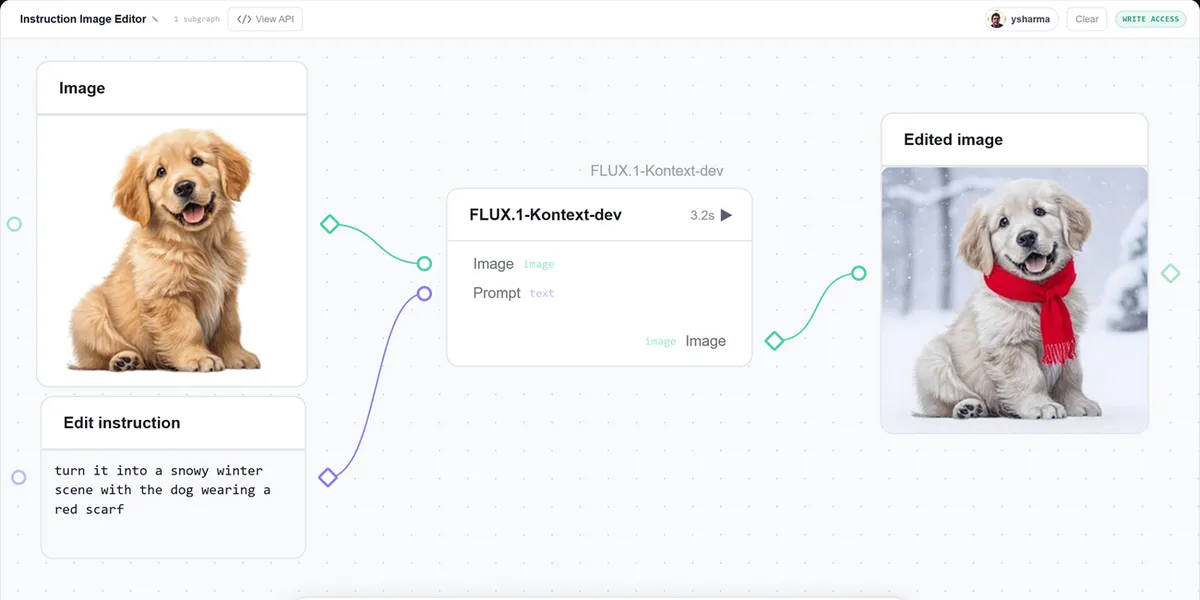
برای حل مشکل کیفیت در ابعاد بالا، این سیستم از مدل FLUX.1-Kontext برای اجرای «اصلاح رزولوشن بالا» (Hi-resolution fix) استفاده میکند. بهجای روش سنتی A1111 که ابتدا بزرگنمایی و سپس حذف نویز میکرد، در اینجا یک مسیر انحرافی دو-گرهای وجود دارد. نتیجهی متن-به-تصویر به گره Kontext با یک دستور اصلاحی خاص ارسال میشود: «جزئیات ریز و بافتهای میکروسکوپی را تقویت کن، اما ترکیببندی را دقیقاً یکسان نگه دار». خروجی این فرآیند، تصویری بزرگتر و بسیار تیزتر است.
قابلیت تبدیل تصویر به تصویر (Image-to-Image) نیز توسط همین گره Kontext مدیریت میشود. کاربران یک تصویر را آپلود کرده، تغییرات مورد نظر را توصیف میکنند و نتیجهی ویرایش شده را دریافت میکنند. نکتهی متمایز، ادغام مستقیم مدلهای زبانی بزرگ (LLM) در جریان خلاقیت است. برای مثال، مدل Qwen3-4B میتواند یک پرامپت ساده مثل «فانوسی در طوفان» را بگیرد و آن را به فهرستی تمیز از حداکثر ۴۰ تگ توصیفی تبدیل کند؛ مواردی مانند: «دریای طوفانی، صخرههای خیس، ترکیببندی دراماتیک، نمای زاویه پایین، نورپردازی حجمی، لحن شوم». این رویکرد بهینهسازی پرامپتها یادآور تلاشهای Veridian Resonance در کاهش دفعات بازبینی است که با مهندسی محدودیتها، دقت تولید را افزایش داد.
برخلاف ComfyUI، برای این ادغام LLM هیچ گره سفارشی (Custom Node) در کار نیست. در یک جریان کاری Gradio، مدل LLM و مدل انتشار (Diffusion) هر دو عملگرهای مدل معمولی هستند که روی یک بوم واحد قرار دارند.
بینایی پیشرفته و ماسکگذاری
تحلیل تصویر (Interrogation) توسط Qwen2.5-VL مدیریت میشود؛ یک مدل بینایی-زبانی (VLM) که تصاویر را توصیف میکند تا پرامپتهای لازم برای بازتولید آنها ساخته شود. این مدل جایگزین سیستمهای مبتنی بر CLIP در A1111 شده است. برای مثال، Qwen2.5-VL میتواند به عکسی از یک بازار شبانه نگاه کند و پرامپتی بنویسد که احتمالاً منجر به تولید آن عکس شده است. این فرآیند بهصورت موازی با یک گره طبقهبندی ViT اجرا میشود که برچسبهای اشیا را با درصد اطمینان برمیگرداند (مثلاً: رستوران ۵۱.۹٪، توتونفروشی ۱۵.۶٪، اسباببازیفروشی ۹.۱٪). به دلیل اینکه gr.Workflow اینها را موازی اجرا میکند، هر دو پاسخ تقریباً در زمان اجرای یک مدل دریافت میشوند.
برای ترمیم تصویر (Inpainting)، Workflow1111 بهجای رنگآمیزی دستی که در روشهای سنتی لازم بود، از تشخیصدهنده DETR برای یافتن خودکار اشیا استفاده میکند. برای مثال، DETR میتواند شش شیء را در یک عکس خیابانی (سه نفر، یک سگ، یک دوچرخه و یک ماشین) پیدا کند. سپس جریان کاری به دو شاخه تقسیم میشود:
- بصریسازی (Visualization): یک شاخه کادرهای تشخیص داده شده (Bounding boxes) را روی تصویر اصلی رسم میکند.
- ماسکگذاری (Masking): شاخه دیگر این کادرها را به یک ماسک برای خطلولههای ترمیم پاییندستی تبدیل میکند.
این عملیات ماسکگذاری بهصورت محلی با استفاده از Pillow و NumPy انجام میشود، به این معنی که تنها فراخوانی تشخیص اشیا نیاز به اتصال شبکه دارد.
ابزارهای کاربردی و انیمیشن
قابلیتهای بخش «Extras» از طریق گرههای تخصصی بازسازی شدهاند. سیستم شامل یک خطلوله «ماتریس پرامپت» است که در آن یک پرامپت پایه (مثلاً «یک درخت بلوط تنها») توسط یک گره تابع با چهار پسوند (در هنگام طلوع، در یک طوفان تندری، زیر کهکشان راه شیری، در مه پاییزی) ترکیب میشود. از آنجایی که gr.Workflow عملگر حلقه (Loop) ندارد، چهار گره متن-به-تصویر بهصورت موازی در کنار هم روی بوم قرار گرفتهاند. چون این گرهها در یک عمق وابستگی قرار دارند، همزمان اجرا شده و یک گره نهایی آنها را در قالب یک صفحه تماس (Contact sheet) یکپارچه میکند.
سایر ابزارهای کاربردی عبارتند از:
- بزرگنمایی (Upscaling): یک نمونهبرداری مجدد Lanczos محلی (گره fn) برای سرعت بالا که به سرعتِ تغییر اندازه در Pillow عمل میکند، یا مدل AuraSR x4 (اولین گره space روی بوم) برای بزرگنمایی با کیفیت بالا از طریق یک Space در هاب.
- حذف پسزمینه: توسط گره BRIA RMBG-2.0 تامین میشود که کل مدل در Space مخصوص خود قرار دارد و بوم صرفاً آن را فراخوانی میکند.
- تولید نقشهها (Annotators): قابلیتهای Canny، line art، sketch، luma-depth و posterize به صورت توابع ساده NumPy پیاده شدهاند. روی عکس نمای یک ساختمان، هر کدام از اینها حدود ۰.۵ ثانیه روی CPU زمان میبرند.
از ۳۶ گره عملگر در این اپلیکیشن، ۳۲ مورد گرههای fn هستند و ۲۲ تای آنها کاملاً در داخل پردازش (In-process) و بدون نیاز به شبکه اجرا میشوند. این یعنی تقریباً دو-سوم بوم حتی در صورت قطع اتصال اینترنت فعال میماند. از آنجایی که اینها توابع معمولی پایتون هستند، میتوان آنها را مستقیماً بدون نیاز به بوم، سرور یا GPU تست کرد.
برای انیمیشن، سیستم دادههای تصویری را به گره Wan 2.2 I2V A14B ارسال میکند. در نسخه دمو، این گره تصویری از یک روباه خوابیده را که بیدار میشود، متحرک میکند. این پیشرفت در سرعت تولید محتوای متحرک، مشابه بهینهسازیهای Linum در کاهش زمان آموزش ویدیوها است که بازدهی تولید را به شدت افزایش داده است. چون یک گره مرجع میتواند چندین خطلوله پاییندستی را تغذیه کند، سیستم میتواند متادیتای PNG (پرامپت، پرامپت منفی، گامها، CFG، بذر، اندازه تصویر و مدل) را بخواند و همزمان تصویر را متحرک کند، بدون اینکه نیاز به آپلود مجدد باشد.
ادغام GPU محلی و API
در حالی که دمو روی سختافزار راه دور اجرا میشود، سیستم از اجرای محلی نیز پشتیبانی میکند. یک گره fn میتواند مدلی را بهصورت محلی بارگذاری کرده و روی GPU کاربر اجرا کند. برای مثال، اپلیکیشن FastVideo/fastvideo-fasth3-preview از gr.Workflow برای اجرای FastH3 (یک تقطیر چهار-گامی از MiniMax-H3) روی ZeroGPU استفاده میکند. این کار با استفاده از دکوراتور @spaces.GPU برای مدیریت تخصیص GPU انجام میشود که در زمان نیاز GPU را به تابع اختصاص داده و پس از اتمام فراخوانی، آن را آزاد میکند.
هر گره خروجی روی بوم بهطور خودکار به یک نقطه اتصال REST تبدیل میشود. Workflow1111 نه گره خروجی (Endpoint) را ارائه میدهد:
/image ، /edited_image ، /generated_prompt ، /recovered_prompt ، /detected_objects ، /x_y_grid ، /upscaled_local ، /annotator_map و /png_info.
این نقاط اتصال همچنین به عنوان ابزارهای MCP (Model Context Protocol) عمل میکنند. با اجرای برنامه با دستور mcp_server=True هر گره خروجی به ابزاری تبدیل میشود که عاملهای هوش مصنوعی مانند Claude Code یا Cursor میتوانند آنها را فراخوانی کنند. این عاملها میتوانند تولید تصویر یا تشخیص اشیا را به عنوان گامهایی در یک وظیفه بزرگتر، بدون نیاز به کد رابط (Glue code) اجرا کنند و توکن خود را در هدر X-HF-Token ارسال نمایند. این امر تضمین میکند که Space هیچ توکنی از خودش را ذخیره نمیکند.
مقایسه با ComfyUI
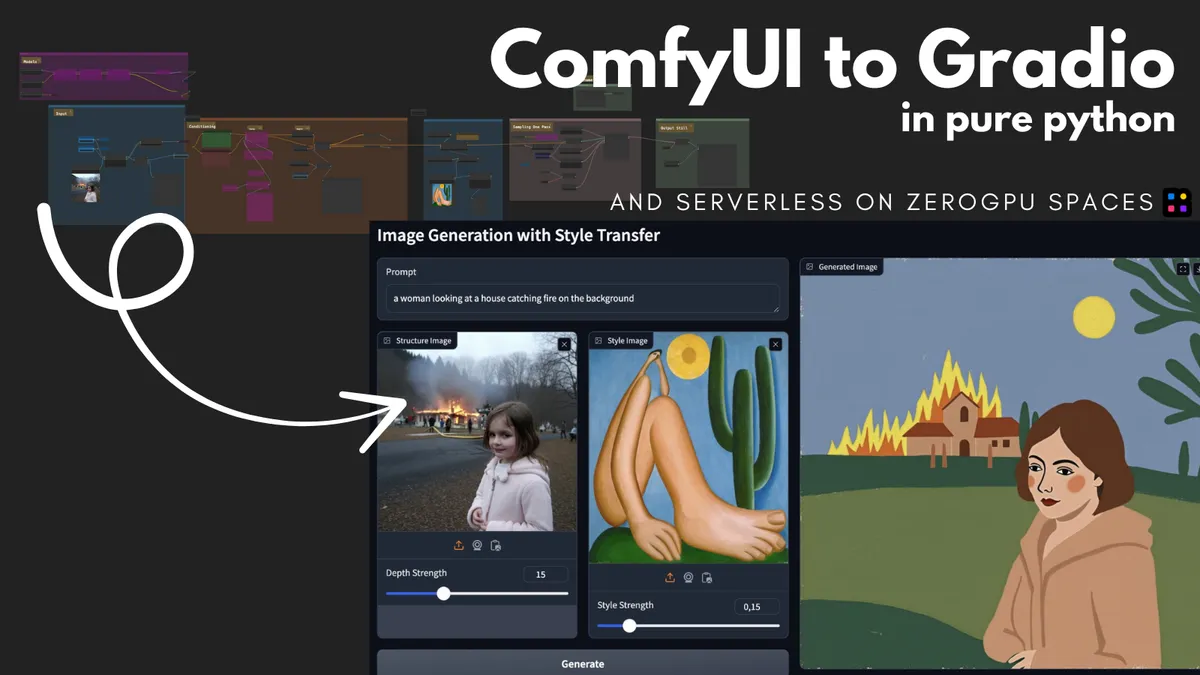
Gradio این جریان کاری را به عنوان جایگزینی دسترسپذیرتر برای ComfyUI معرفی میکند. در حالی که هر دو از گرافها استفاده میکنند، gr.Workflow اجازه میدهد گرهها سختافزاری باشند که کاربر مالک آنها نیست و هر Space در هاب یا هر API را فراخوانی کند. این سیستم امکان ترکیب مودالیتههای مختلف — LLMها، VLMها و مدلهای انتشار — را روی یک بوم واحد و بدون نیاز به نصب گرههای سفارشی فراهم میکند.
از آنجایی که این سیستم بر پایه توابع استاندارد پایتون ساخته شده است، هر منطق سفارشی را میتوان بدون نیاز به نوشتن پلاگینهای تخصصی اضافه کرد. یک توسعهدهنده میتواند با یک تابع ساده شروع کند، از bind= برای تبدیل آن به گره و از edges= برای اتصال آنها استفاده کند. این امر ابزار هنر AI را از یک نرمافزار نصبی محلی به یک سرویس وب قابل استقرار تبدیل میکند که میتواند از طریق یک URL عمومی به اشتراک گذاشته شود و تحت هویت کاربر از طریق OAuth اجرا گردد.
کاربران میتوانند با کپی کردن (Duplicate) فضای Workflow1111 شروع کنند تا آن را برای نیازهای خود بازطراحی کنند، یا با پنج جریان کاری پایه شروع کنند که هر کدام در حدود یک دقیقه اجرا میشوند. در نهایت، دستور gradio deploy کل پروژه را روی یک Space مستقر میکند.
گام بعدی شما
- فضای Workflow1111 را در Hugging Face کپی (Duplicate) کنید تا ساختار گرهها را برای نیازهای خود تغییر دهید.
- اگر توسعهدهنده هستید، از قابلیت MCP برای متصل کردن این خطلولهها به عاملهای کدنویسی خود استفاده کنید.
- توابع پایتون ساده خود را با دستور
bind=به گره تبدیل کرده و در بوم Gradio مستقر کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو