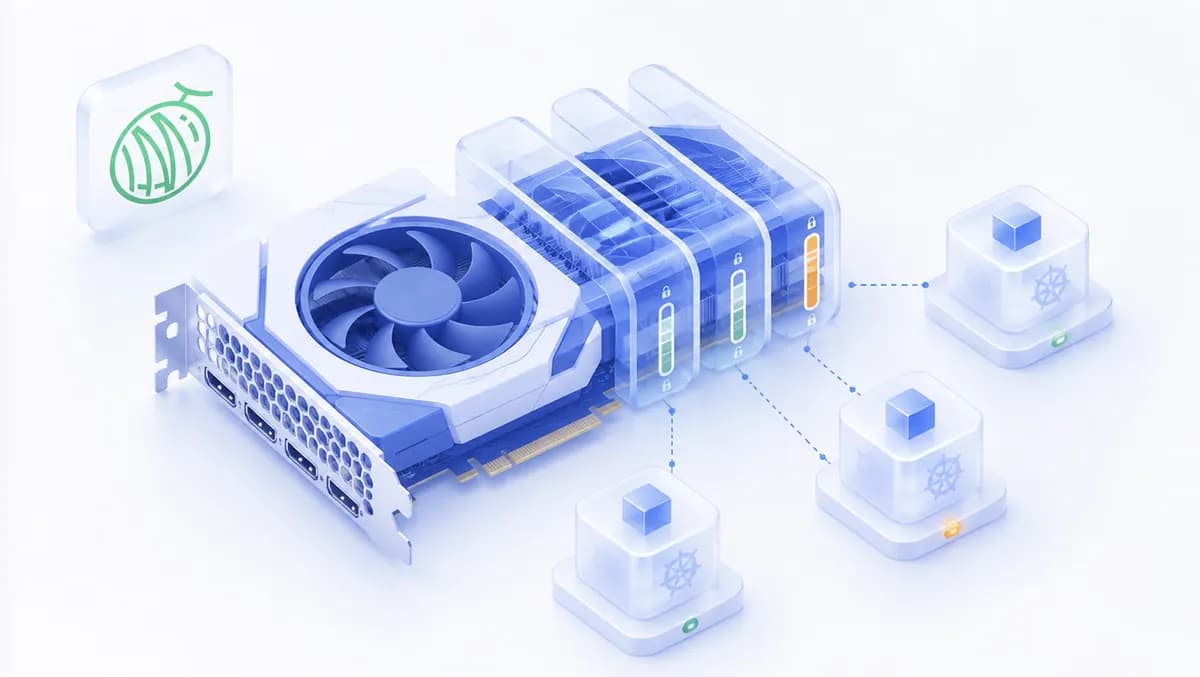
تصور کنید برای یک گره ۸ پردازشی H100 سالانه تا ۴۸۰ هزار دلار هزینه پرداخت میکنید، اما بخش زیادی از این قدرت پردازشی هرگز استفاده نمیشود. این اتلاف سرمایه به دلیل ساختار کوبرنتیز است که GPUها را به عنوان واحدهای تجزیهناپذیر تخصیص میدهد.
HAMi (میانافزار مجازیسازی محاسبات هوش مصنوعی ناهمگون) با ایجاد امکان درخواست برشهای دقیق از حافظه و توان محاسباتی، تضمین میکند که شما فقط هزینه ظرفیتی را بدهید که واقعاً مصرف میکنید. این ابزار درست مانند تقسیم یک پیتزای بزرگ بین چندین نفر است، بهجای آنکه هر کس برای یک تکه کوچک، یک پیتزای کامل سفارش دهد.
همانطور که در تحلیلهای پیشین ما درباره بهینهسازی زیرساختهای مدلهای زبانی اشاره کردیم، گلوگاه اصلی اکنون نه در دسترسی به مدل، بلکه در مدیریت بهینه سختافزار است. این چالش در ابعاد کلانتر نیز دیده میشود؛ جایی که مدلهای تأمین مالی چرخهای انویدیا تلاش میکنند تا دسترسی به سختافزارهای عظیم را تسهیل کنند. اکثر خوشههای (Cluster) مشترک AI با شکاف عمیقی میان ظرفیت تخصیص داده شده و بهرهوری واقعی روبهرو هستند. طبق مستندات فنی، پیش از عرضه قابلیت Dynamic Resource Allocation (DRA)، کوبرنتیز تنها میتوانست GPUها را بهصورت کارتهای کامل زمانبندی کند.
برای مثال، اگر یک پاد تنها به ۴ گیگابایت از ۸۰ گیگابایت حافظه یک H100 نیاز داشته باشد، باز هم تمام کارت را برای مدت زمان اجرای خود رزرو میکند. این وضعیت منجر به زیربهرهبرداری شدید از سختافزارهای گرانقیمت میشود؛ بهطوری که یک چتبات در ساعات کمترافیک، کارتهای اختصاصی را بیاستفاده رها میکند. در حالی که داشبوردها تمام GPUها را «اشغال شده» نشان میدهند، ابزارهای نظارتی مانند nvidia-smi مصرف واقعی بسیار ناچیزی را گزارش میکنند. این پارادوکس باعث میشود مدیران بودجههای جدیدی برای خرید GPU درخواست کنند، در حالی که سختافزار موجود از نظر ریاضی ظرفیت خالی دارد.
HAMi که در ژوئیه ۲۰۲۶ به وضعیت Incubating در بنیاد CNCF رسید، این خلأ را با افزودن یک لایه اجباری در داخل کانتینر پر میکند. این لایه بدون نیاز به تغییر در کد برنامهها یا ایمیجها، حجم کاری را به بودجههای تعیینشده محدود میکند. شرکتهایی مانند SNOW و NIO در حال حاضر از HAMi در محیطهای عملیاتی خود استفاده میکنند.

این لایه مجازیسازی بازمتن بر روی شتابدهندههای مختلفی عمل میکند و طیف وسیعی از سختافزارها را پشتیبانی میکند:
- GPUهای NVIDIA
- MLUهای Cambricon
- DCUهای Hygon
- NPUهای Ascend
- Moore Threads
- MetaX
هر تولیدکننده از طریق یک پلاگین دستگاه و بکاِند ایزولاسیون خاص به سیستم متصل میشود. در سختافزارهای انویدیا، HAMi جایگزین پلاگین استاندارد میشود و با رهگیری API درایور CUDA در داخل کانتینر، سقف حافظه را اعمال میکند. کاربران همچنان از nvidia.com/gpu استفاده میکنند، اما دو منبع گسترشیافته به آن اضافه میکنند:
nvidia.com/gpumem: برای تخصیص دقیق حافظه (مثلاً ۸۰۰۰ مگابایت).nvidia.com/gpucores: برای تخصیص هستههای محاسباتی (مثلاً ۳۰ هسته).

یک درخواست اشتراکی GPU در HAMi چهار مرحله را طی میکند:
۱. پلاگین دستگاه: به صورت DaemonSet در هر گره اجرا شده و هر ۳۰ ثانیه وضعیت دستگاهها را بررسی میکند تا تلمتری را از طریق انوتیشنهای hami.io/node-nvidia-register منتشر کند.
۲. وبهوک تغییردهنده (Mutating Webhook): هنگام ایجاد پاد، مانیفست را بررسی میکند. اگر کلیدهایی مثل nvidia.com/gpumem را ببیند، نام زمانبندی پاد را به hami-scheduler تغییر میدهد. در اینجا درخواست یک GPU دیگر به معنای «یک کارت کامل» نیست، بلکه به معنای «یک کارت فیزیکی مشترک» است.
۳. گسترشدهنده زمانبندی: یک نقشه زنده از مصرف هر GPU میسازد. این سیستم گرههای کمظرفیت را حذف کرده و بر اساس سیاستهای Binpack یا Spread، بهترین برش را انتخاب و در انوتیشن پاد ثبت میکند.
۴. کتابخانه داخلی کانتینر: پلاگین دستگاه متغیرهای محیطی (مانند CUDA_DEVICE_MEMORY_LIMIT_0) و فایلهای ld.so.preload را به کانتینر تزریق میکند. این کتابخانه کنترلی بین برنامه و درایور قرار میگیرد و اگر برنامه بخواهد از سقف حافظه عبور کند، خطای torch.OutOfMemoryError صادر میکند.

ایزولاسیون در HAMi بیشتر شبیه به یک «حصار» است تا یک «دیوار» سخت.
در مقایسه با MIG (Multi-Instance GPU) که مرزهای سختافزاری ایجاد میکند، HAMi یک حصار نرمافزاری است. این یعنی در حالی که بودجهها را بهدقت کنترل میکند، نمیتواند جلوی شکستهای سطح دستگاه را بگیرد؛ اگر درایور یک کارت مشترک ریست شود، تمام کاربران آن کارت اثر میپذیرند. اما در مقایسه با Time-Slicing (قطعهبندی زمانی)، HAMi بسیار پایدارتر است. در Time-Slicing هیچ سقف حافظهای وجود ندارد و یک برنامه میتواند تمام حافظه را اشغال کرده و سایرین را کرش کند، اما HAMi درخواستهای اضافی را رد میکند.
جالب است که HAMi و MIG مکمل یکدیگرند. HAMi میتواند ابزار nvidia-mig-parted را برای تغییر هندسه MIG متناسب با کارهای ورودی مدیریت کند تا نیاز به تنظیمات دستی nvidia-smi mig از بین برود.

صرفهجوییهای مالی از طریق دو استراتژی زمانبندی حاصل میشود:
- Binpack (بستهبندی متراکم): برنامهها را در کمترین تعداد ماشین possibly جمع میکند. این کار به مقیاسدهندههای خودکار اجازه میدهد گرههای خالی را سریعاً خاموش کنند و مستقیماً هزینههای ابری را کاهش دهند. در این راستا، ترکیب KServe و KEDA راهکاری مؤثر برای رفع گلوگاههای مقیاسدهی GPU در محیطهای کوبرنتیزی هستند.
- Spread (پخش): برنامهها را بهطور مساوی پخش میکند تا تداخل کمتر شود و برای استنتاجهای حساس به تأخیر مناسبتر باشد، اما گرهها را همیشه «گرم» نگه میدارد و مانع کاهش مقیاس میشود.
برای شرکتهایی که سختافزار شخصی دارند، اعداد تکاندهنده است. در یک ناوگان ۱۰۰۰ پردازشی H100، هر ۱۰ درصد افزایش در بهرهوری واقعی، به معنای ۲.۵ تا ۳ میلیون دلار سرمایهای است که بهجای بیکاری، در حال تولید ارزش است.

استقرار HAMi نیازمند جایگزینی پلاگین دستگاه فعلی است. اجرای همزمان HAMi و پلاگین استاندارد انویدیا باعث تداخل در ثبت منابع میشود. توصیه میشود از برچسب gpu=on برای rollout مرحلهبهمرحله در خوشهها استفاده کنید.
گام بعدی شما
- اگر داشبوردهای بهرهوری GPU شما در بررسیهای مالی باعث شرمساری میشود، HAMi را روی یک Pool استنتاج آزمایش کنید.
- استقرارها را از حالت Over-provisioning به برشهای دقیق
gpumemوgpucoresتغییر دهید. - در صورت نیاز به ایزولاسیون سختافزاری کامل، از حالت
nvidia.com/vgpu-mode: "mig"استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره ترازهای انرژی در مراکز داده مدرن مراجعه کنید.



گفتگو