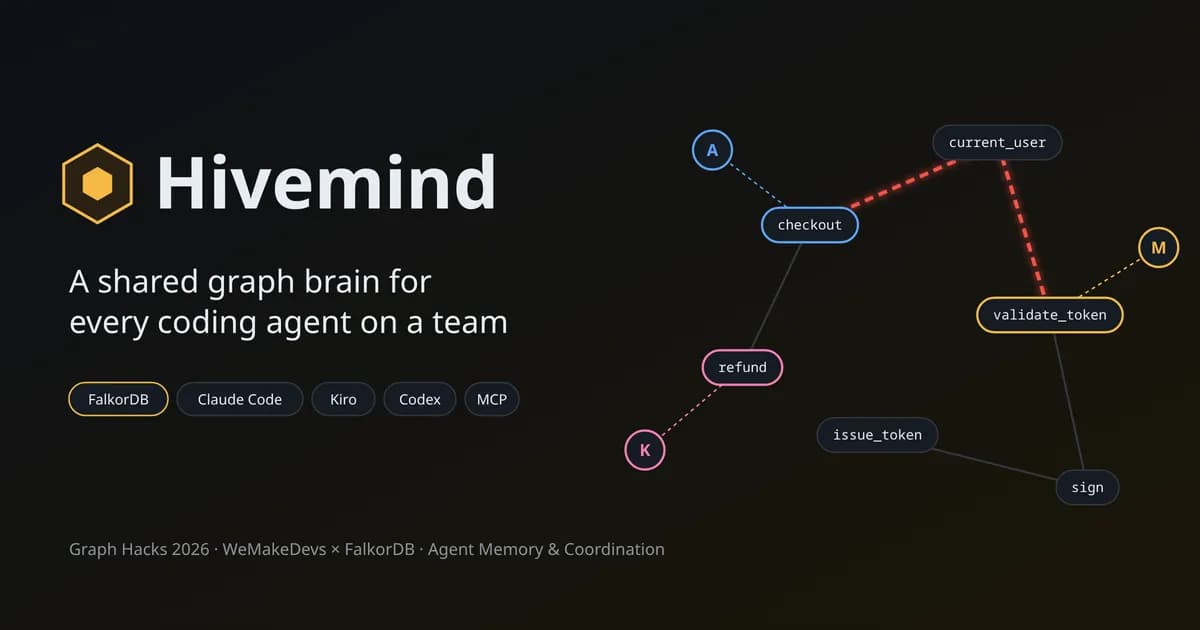
تصور کنید تیمی متشکل از پنج برنامهنویس را در نظر بگیرید که هر کدام از عاملهای هوش مصنوعی متفاوتی روی یک کدبیس واحد کار میکنند. آنها اغلب با مشکلی به نام «سیلوی حافظه» (Memory Silo) مواجه میشوند؛ وضعیتی که در آن یک عامل، دقیقاً همان خطایی را تکرار میکند که عامل دیگر پیش از این کشف و شناسایی کرده است. Hivemind، یک سیستم حافظه مشترک که بر پایه FalkorDB ساخته شده است، این مشکل را با تبدیل کدبیس و دانش تیمی به یک گراف واحد و قابل پیمایش حل میکند.
اکثر تیمهای توسعه مدرن امروزه از ترکیبی از عاملها مانند Claude Code، Kiro و Codex استفاده میکنند، اما این ابزارها معمولاً در انزوا عمل میکنند. هر جلسه (Session) از نقطه صفر شروع میشود و عاملها هیچ آگاهی لحظهای از تغییراتی که همتیمیهایشان در کد ایجاد میکنند، ندارند. این فقدان هماهنگی منجر به ایجاد «تداخلات نامرئی» میشود؛ تداخلاتی که Git نمیتواند آنها را شناسایی کند، زیرا این تداخلات مربوط به منطق و قصد (Intent) برنامهنویس هستند، نه صرفاً تداخلهای متنی ساده در خطوط کد. این چالش در واقع نسخهای فنیتر از بنبست همگامسازی حافظه در حسابهای شخصی AI است که بسیاری از بنیانگذاران استارتاپها با آن دستوپنجه نرم میکنند.
مسئله: تداخلات نامرئی
برای درک بهتر، یک تیم فرضی پنج نفره را تصور کنید که روی بکاند یک فروشگاه کار میکنند: پریا (سرپرست فنی)، مارکو، عایشه، کن و لنا. مارکو از Kiro میخواهد که پشتیبانی از JWT را اضافه کند، که مستلزم تغییر تابع validate_token() در فایل shop/tokens.py است. بهطور همزمان، عایشه از Codex میخواهد که قابلیت محدودیت نرخ درخواست (Rate Limiting) را به تابع checkout() در فایل shop/orders.py اضافه کند.
اگرچه اینها دو فایل متفاوت هستند، اما تابع checkout() تابع current_user() را فراخوانی میکند و این تابع نیز به نوبه خود validate_token() را صدا میزند. بنابراین، تغییرات عایشه به کدی وابسته است که مارکو در حال حاضر در حال تغییر آن است. Git این مورد را شناسایی نمیکند چون هیچ تداخل ادغامی (Merge Conflict) در متن وجود ندارد. علاوه بر این، اگر تلاش اول مارکو — جایگزینی بررسی HMAC با رمزگشایی PyJWT — باعث شکست تست test_refresh_session شود و او کار را برای آن روز متوقف کند، عاملِ لنا در صبح روز بعد هیچ حافظهای از آن شکست نخواهد داشت و احتمالاً همان رویکرد معیوب را دوباره امتحان میکند.
رویکردهای موجود تنها بخشهایی از این مشکل را پوشش میدهند. Git و بررسیهای کد (Code Reviews) مسائل را تنها پس از اتمام کار پیدا میکنند. فایلهای دستنویس مانند CLAUDE.md یا AGENTS.md استاتیک هستند و نمیتوانند پیشرفت لحظهای کار را منعکس کنند. حافظه داخلی هر عامل در یک ماشین و درون یک ابزار خاص محبوس شده است. همچنین، پرسیدن از همتیمیها در چت، به این بستگی دارد که افراد به یاد داشته باشند چه چیزی را بپرسند.
Hivemind با تکیه بر مفهوم حافظه گرافمحور، هر تکه از دانش تیمی را مستقیماً به توابعی که بر آنها اثر میگذارد متصل میکند. به جای تکیه بر یک فایل متنی تخت یا تاریخچه چت، این سیستم از یک گراف برای پاسخ به پرسشهای حیاتی استفاده میکند: «چه کسی در حال تغییر این تابع است؟»، «دیروز در اینجا چه چیزی شکست خورد؟» و «اگر این بخش را ویرایش کنم، چه چیزی خواهد شکست؟»
معماری حافظه مشترک
سیستم Hivemind در دو لایه مجزا در یک نمونه از FalkorDB عمل میکند:
- لایه کد (The Code Layer): این لایه با استفاده از ماژول
astپایتون از مخزن کد (Repository) تجزیه و تحلیل میشود. این لایه هر تابع، توابعی که آن تابع فراخوانی میکند و ایمپورتهای فایل را ثبت میکند. برای جلوگیری از بهروزرسانیهای غیرضروری، سیستم یک هش (Hash) از درخت نحو (Syntax Tree) ذخیره میکند؛ بنابراین تغییرات در فرمتبندی یا ویرایش کامنتها نادیده گرفته میشوند، اما تغییرات در منطق باعث اجرای مجدد ایندکسگذاری میشود. این دادهها در دستههای حجیم با استفاده از دستوراتUNWINDوMERGEنوشته میشوند. - لایه حافظه تیمی (The Team Memory Layer): این لایه اقدامات انسانها و عاملها را ثبت میکند. این لایه «قصدها» (Intents یا همان تسکها)، «تلاشها» (Attempts یا نتایج تستها) و «تصمیمات» (Decisions یا قوانین معماری) را به توابع خاصی در لایه کد پیوند میدهد.
جزئیات: مکانیسمهای گراف
- پشتیبانی از چند-گراف (Multi-graph): هر تیم گراف اختصاصی خود را (مثلاً
hivemind_shopیاhivemind_payments) در یک پایگاه داده واحد دارد. - اتصال مستقیم: هر عامل مستقیماً از طریق پروتکل Redis به پایگاه داده متصل میشود و این امر نیاز به یک سرور واسط برای Hivemind را از بین میبرد.
- یکپارچگی ابری: سیستم برای دسترسی آسانتر از یک سطح رایگان ابری (Cloud Tier) استفاده میکند.
- پیمایش زمینهای (Contextual Traversal): پرسشهایی مانند «عامل من قبل از ویرایش checkout باید چه چیزی بداند؟» به پیمایشهای گراف تبدیل میشوند تا توابع متصل و ادعاهای مرتبط را پیدا کنند.
حل فراخوانیهای توابع (Resolving Function Calls)
وقتی یک تابع validate_token را فراخوانی میکند، ایندکسکننده باید تصمیم بگیرد دقیقاً کدام تابع مد نظر است. Hivemind ابتدا اولویت را به تعریفی در همان فایل میدهد. اگر پیدا نشد، از هر تابعی با آن نام استفاده میکند. این فرآیند از طریق یک کوئری Cypher مدیریت میشود:
MATCH (a:Function {file: $file}) UNWIND a.calls AS name MATCH (b:Function {name: name}) WHERE b <> a WITH a, collect(b) AS targets, [t IN collect(b) WHERE t.file = a.file] AS local UNWIND CASE WHEN size(local) > 0 THEN local ELSE targets END AS t MERGE (a)-[:CALLS]->(t)
اگرچه این روش یک بررسی کامل نوع (Type Checker) نیست و ممکن است توسط Dispatchهای پویا گمراه شود، اما اجرای مجدد آن بعد از هر ویرایش بسیار ارزان است و برای کدهای معمولی اپلیکیشن به اندازه کافی دقیق است.
جلوگیری از تداخلات پیش از وقوع
یکی از حیاتیترین ویژگیها، «قلاب تداخل پیش از ویرایش» است. قبل از اینکه عاملی فایلی را تغییر دهد، Hivemind یک کوئری Cypher اجرا میکند تا بررسی کند آیا هر تابعی که در حال تغییر است، در فاصله سه فراخوانی با تابعی قرار دارد که در حال حاضر توسط توسعهدهنده دیگری «تصاحب» (Claimed) شده است یا خیر:
MATCH (t:Function) WHERE t.qname IN $mine MATCH p = (t)-[:CALLS*1..3]->(o:Function)<-[:CLAIMS]-(i:Intent {status: 'active'}) WHERE i.dev <> $me RETURN t.qname, o.qname, i.dev, i.description, [n IN nodes(p) | n.qname] AS path
اگر تداخلی شناسایی شود، سیستم ویرایش را متوقف کرده و یک توضیح مسیر (Path Explanation) به توسعهدهنده ارائه میدهد. بررسی کامل سه حالت را اجرا میکند: خود تابع، کدی که عامل فراخوانی میکند، و کدی که عامل را فراخوانی میکند. برای هر کدام، کوتاهترین مسیر برای خوانایی بیشتر حفظ میشود. برای جلوگیری از مختل کردن کار عادی، Hivemind به جای مسدود کردن سخت، از یک هشدار یکباره استفاده میکند؛ پس از اینکه توسعهدهنده آن را تایید کرد، هشدار به عنوان یک گره ذخیره شده و برای آن ویرایش خاص دیگر ظاهر نمیشود.
خودکارسازی ثبت حافظه
نسخههای اولیه سیستم به عاملها متکی بودند تا به صورت دستی ابزارهایی مانند record_attempt را فراخوانی کنند، اما توسعهدهنده متوجه شد که عاملها به دلیل تمرکز شدید روی وظیفه اصلی، به ندرت این کار را انجام میدهند. برای رفع این مشکل، Hivemind ثبت حافظه را به قلابهای سیستمی منتقل کرد که در نقاط ثابت فعال میشوند:
- دریافت پرامپت: پرامپت اولیه (مثلاً «پشتیبانی JWT را به توکنهای احراز هویت اضافه کن») بهطور خودکار به یک «وظیفه» (Task) تبدیل میشود.
- پیش از ویرایش: توابعی که در حال ویرایش هستند تصاحب شده و برای تداخل بررسی میشوند.
- پس از ویرایش: فایلها مجدداً ایندکس میشوند. اگر هش
validate_tokenتغییر کرده باشد، سیستم دقیقاً میداند کدام تابع لمس شده است. - اجرای تست: سیستم دستوراتی مانند
pytest،unittest،jest،go testیاcargo testرا شناسایی میکند. اگر کد خروجی ۱ باشد، نام تست شکستخورده از خروجی استخراج شده و به عنوان یک «تلاش» (Attempt) متصل به توابع تغییریافته ثبت میشود. - پایان جلسه: خلاصه نهایی عامل به عنوان یک یادداشت پیشرفت برای آن وظیفه ذخیره میشود.
نرمالسازی رفتار عاملها
از آنجایی که Claude Code، Kiro و Codex از فرمتهای رویداد و نام ابزارهای متفاوتی استفاده میکنند، Hivemind یک لایه نرمالسازی به کار میگیرد:
- Claude Code: رویدادها را با فرمت PascalCase (مانند
PreToolUseوPostToolUseFailure) ارسال میکند و از ابزارهایی مثلEdit،WriteوBashاستفاده میکند. - Kiro: رویدادها را با فرمت camelCase (مانند
preToolUseوagentSpawn) ارسال میکند و ازfs_writeوexecute_bashاستفاده میکند و وضعیت را درtool_response.result[0]قرار میدهد. - Codex: از نامهای رویداد مشابه کلود استفاده میکند اما نام ابزارها در نسخههای مختلف متفاوت است (
shell،exec_command،apply_patch).
Hivemind ویرایشها و دستورات را بر اساس ورودیهایشان شناسایی میکند، نه بر اساس نام ابزار. این لایه نرمالسازی با استفاده از دادههای واقعی (Payloads) استخراج شده از جلسات واقعی به عنوان تستهای مرجع ساخته شده است، زیرا مستندات رسمی ناقص بودند.
تجمیع حافظه و تحویل وظایف
برای جلوگیری از پر شدن گراف با دادههای تکراری، Hivemind ورودیهای مرتبط را ادغام میکند. اگر یک تلاش جدید دارای نتیجه و تستهای شکستخورده مشابه تلاش قبلی باشد، یا عبارتهای بسیار مشابهی داشته باشد، سیستم صرفاً یک شمارنده را افزایش میدهد (که در رابط کاربری به صورت یک نشان یا Badge نمایش داده میشود). این مکانیسم بهینهسازی یادآور رویکرد سیستم Eling در حذف تکرار دادهها برای مدلهای متضاد است تا از اتلاف منابع جلوگیری شود.
وقتی یک تست در نهایت پاس شود، سیستم یک یال RESOLVES ایجاد میکند تا شکستهای قبلی را به عنوان «حل شده» علامتگذاری کند:
MATCH (f:Attempt {outcome: 'failed'})-[:TOUCHED]->(fn:Function) WHERE fn.qname IN $q AND coalesce(f.resolved, false) = false WITH DISTINCT f MATCH (a:Attempt {id: $fix}) CREATE (a)-[:RESOLVES]->(f) SET f.resolved = true, f.resolved_dev = $dev
در اینجا از DISTINCT استفاده شده است زیرا یک شکست میتواند چندین تابع را در کوئری لمس کند؛ بدون آن، یالهای RESOLVES تکراری ایجاد میشد.
تصمیمات نیز جایگزین یکدیگر میشوند. یک تصمیم جدید روی همان کد، تصمیم قدیمی را SUPERSEDES (جایگزین) میکند، هرچند ابزار why() همچنان میتواند تاریخچه را بازیابی کند. این امر تضمین میکند که عاملها فقط تصمیم فعال فعلی را ببینند در حالی که ردپای حسابرسی (Audit Trail) حفظ شود.
این ساختار تحویل بیوقفه وظایف را ممکن میکند. وقتی مارکو کار را متوقف میکند، عامل او وظیفه را با یک یادداشت تحویل میدهد. وقتی لنا کار را از سر میگیرد، یک کوئری Resume یال OWNS را به او منتقل کرده و جلسه او را به وظیفه متصل میکند:
MATCH (i:Intent {id: $task}) OPTIONAL MATCH (:Developer)-[o:OWNS]->(i) DELETE o WITH DISTINCT i MATCH (d:Developer {name: $me}), (s:Session {id: $session}) CREATE (d)-[:OWNS]->(i) CREATE (s)-[:WORKS_ON]->(i) SET i.status = 'active'
این کار به عامل لنا دسترسی کامل به تاریخچه تصاحبها، تلاشهای شکستخورده و تصمیمات معماری پریا را در یک فراخوانی میدهد.
بصریسازی مغز
Hivemind شامل یک داشبورد است که کدبیس را نقشهبرداری کرده، توابع را بر اساس فایل گروهبندی میکند و کارهای توسعهدهندگان را با رنگهای خاص مشخص میکند. این سیستم از الگوریتمهای FalkorDB برای ارائه بینشهای عمیقتر استفاده میکند:
- PageRank: توابعی را رتبهبندی میکند که بقیه کد بیشترین وابستگی را به آنها دارند.
- Betweenness Centrality: توابعی را پیدا میکند که بسیاری از مسیرهای فراخوانی از آنها عبور میکنند و آنها را به عنوان مناطق پرخطر تداخل علامتگذاری میکند.
- ShortestPath: اتصال بین دو تابع نامرتبط را بصری میکند تا توضیح دهد چرا تغییر در یکی ممکن است بر دیگری اثر بگذارد. اگر اتصال مستقیمی وجود نداشته باشد، نزدیکترین فراخوان مشترک آنها را نشان میدهد.
عاملها همچنین به یک سرور MCP با ۱۴ ابزار دسترسی دارند. سه ابزار کلیدی عبارتند از:
blast_radius: فراخوانها را به صورت معکوس دنبال میکند (MATCH p = (caller:Function)-[:CALLS*1..3]->(t:Function {qname: $q}) RETURN caller.qname, min(length(p)) AS distance).who_knows: توسعهدهندگان را بر اساس تصاحبها، تلاشها و تصمیماتشان روی یک تابع و همسایگان آن رتبهبندی میکند.why: تصمیم فعلی، تصمیمی که جایگزین شده، تمام تلاشها و افرادی که درگیر بودهاند را برمیگرداند.
تست در دنیای واقعی
در یک تست شامل سه کلون مجزا از یک پروژه، سیستم هماهنگی خودکار را به نمایش گذاشت. ابتدا، کیرا (با استفاده از Kiro) قابلیت لغو توکن (Token Revocation) را اضافه کرد. قلابها وظیفه، اضافه شدن revoke_token ،تغییر در validate_token ،اجرای موفق تست و خلاصه کیرا را ثبت کردند.
سپس، از کارل (با استفاده از Claude Code) خواسته شد تا Scopeهای توکن را اضافه کند. بدون اینکه از او خواسته شود Hivemind را چک کند، عامل کارل متوجه شد: «بررسی لغو توکن از تغییرات اخیر کیرا دستنخورده باقی مانده است.» او تغییرات کیرا را بهطور خودکار از حافظه مشترک دریافت کرده بود.
در نهایت، کودی (با استفاده از Codex) از سرور MCP برای خواندن تخته وظایف مشترک و مشاهده هر دو وظیفه قبلی استفاده کرد و حلقه آگاهی مشترک را کامل کرد.
درسهای آموخته شده و پیادهسازی
ساخت Hivemind چندین بینش کلیدی را آشکار کرد:
- قلابها بر ابزارها ارجحاند: عاملها بیش از حد روی تسک متمرکز هستند و حافظه خود را ثبت نمیکنند؛ بنابراین قلابهای سیستمی ضروری هستند.
- دقت کوئری: کوئریهای اولیه تداخل بیش از حد گسترده بودند و توابع را صرفاً به این دلیل که یک تابع سوم هر دو را فراخوانی میکرد، علامتگذاری میکردند. تقسیم کوئری به «کدی که من فراخوانی میکنم» و «کدی که من را فراخوانی میکند» مثبتهای کاذب را حذف کرد.
- پایداری دادهها: برای جلوگیری از حذف حافظه هنگام ایندکس مجدد در شاخههای (Branches) مختلف، توابع اکنون تنها در صورتی حذف میشوند که هیچ حافظهای به آنها متصل نباشد.
- زیرساخت: مکان استقرار منطقه (Region) حیاتی است؛ استقرار داشبورد در همان منطقهای که نمونه ابری FalkorDB قرار داشت، تأخیر درخواستها را از بین برد.
- دقت دادههای ارسالی: مستندات رسمی تمام Payloadهای قلابها را پوشش نمیدادند. سیستم اکنون از دادههای استخراج شده از جلسات واقعی به عنوان تستهای مرجع استفاده میکند.
طبق مستندات پروژه منتشر شده برای Graph Hacks (WeMakeDevs × FalkorDB، ۱۵-۱۸ اکتبر ۲۰۲۶)، سیستم در حال حاضر از ایندکسگذاری پایتون پشتیبانی میکند و برنامههایی برای گسترش به TypeScript، Go و Rust با استفاده از Tree-sitter دارد. گامهای آینده شامل استفاده از ایندکس برداری FalkorDB برای ادغام شکستها بر اساس «معنا» (به جای شباهت کلمات)، متصل کردن خودکار تصمیمات به Pull Requestها و پیشنهاد بازبینها (Reviewers) از طریق تشخیص جامعه (Community Detection) روی گراف فراخوانی است.
تحلیل: تغییر پارادایم عاملها
این رویکرد، عامل AI را از یک «ابزار بدون وضعیت» (Stateless Tool) به یک «همتیمی دارای وضعیت» (Stateful Teammate) تبدیل میکند. با انتقال حافظه از پنجره کانتکست LLM به یک گراف ساختاریافته، Hivemind نیاز به پرامپتهای حجیم که کارهای قبلی را خلاصه میکنند، از بین میبرد.
برای تیمهای توسعه، این بدان معناست که «هزینه» تعویض عاملها یا توسعهدهندگان بهشدت کاهش مییابد. اثر مرتبه دوم این سیستم، کاهش بدهی فنی (Technical Debt) است؛ وقتی یک عامل میداند چرا یک رویکرد خاص سه روز پیش شکست خورد، دیگر زمان توسعهدهنده و توان پردازشی را روی مسیرهای بنبست تلف نمیکند.
برای بررسی این مدل هماهنگی، میتوانید دموی زنده را در hivemind-live-demo.vercel.app تست کنید یا ابزار را از طریق uv tool install git+https://github.com/Quantapixel/hivemind نصب کرده و دستور hivemind join <dashboard-url> را در پروژه خود اجرا کنید. برای تست محلی، پروژه یک تنظیمات Docker Compose برای اجرای FalkorDB و رابط کاربری Hivemind فراهم کرده است.
گام بعدی شما
- اگر در تیمهای چندنفره از AI Agent استفاده میکنید، مدل «حافظه مشترک» را جایگزین فایلهای استاتیک مثل
CLAUDE.mdکنید. - برای تست این رویکرد، دمو زنده در
hivemind-live-demo.vercel.appرا بررسی کنید. - ابزار را از طریق دستور
uv tool install git+https://github.com/Quantapixel/hivemindنصب کرده و در پروژه خود اجرا کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو