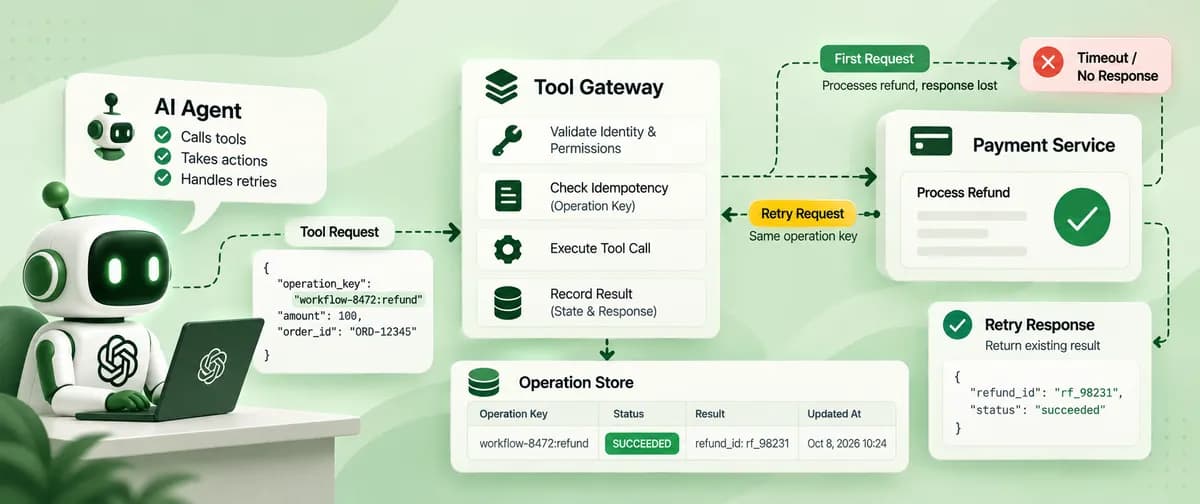
تصور کنید یک عامل هوش مصنوعی برای مشتری شما وجهی را بازگرداند، اما درست پیش از دریافت تاییدیه، اتصال شبکه قطع شود. در این لحظه، عامل با فرض شکست عملیات، درخواست را دوباره ارسال میکند و ناخواسته دو بار وجه را بازمیگرداند. این سناریو نشان میدهد که چگونه یک قطعی ساده در شبکه میتواند منجر به خطای مالی شود.
این شکست رایج در گردشکارهای عاملمحور (Agentic) ثابت میکند که سیاستهای «تلاش مجدد» (Retry) به تنهایی نمیتوانند ایمنی سیستم را تضمین کنند. مشکل اینجا استدلال مدل نیست، بلکه مرز اجرای عملیات بین عامل و سیستمهای خارجی است که مدل میتواند آنها را تغییر دهد. این چالشها اغلب ریشه در تفاوتهای بنیادین محیط تست و عملیات دارند، موضوعی که در بررسی شکاف عیبیابی در عاملهای هوش مصنوعی به تفصیل به آن پرداختیم.
در سیستمهای توزیعشده، تشخیص اینکه یک عملیات شکست خورده یا موفق شده اما پاسخ آن نرسیده، تقریباً غیرممکن است. به نقل از راهنمای فنی منتشر شده در dev.to در ۹ اکتبر ۲۰۲۶، شکاف بین درگاه ابزار (Tool Gateway) و سرویس مقصد، ابهامی خطرناک ایجاد میکند. توالی را در نظر بگیرید که در آن یک عامل درخواستی را از طریق درگاه ارسال میکند، درگاه آن را به سرویس مقصد میفرستد و سرویس تغییر را ثبت میکند، اما پاسخ گم میشود یا پس از ضربالاجل (Deadline) کلاینت میرسد. در این نقطه، فراخواننده نمیداند آیا اثر جانبی (Side Effect) رخ داده است یا خیر. بنابراین، تلقی کردن هر «تایماوت» به عنوان دلیل شکست، اقدامی ناایمن است.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، مدیریت وضعیت در لایههای زیرساختی بسیار حیاتیتر از لایهی مدل است. این ابهام زمانی رخ میدهد که یک Worker پس از ثبت تراکنش در پایگاهداده، اما پیش از تایید پیام در صف، کرش کند. در نتیجه، یک پیام ممکن است دوباره تحویل داده شود در حالی که پردازش اولیه آن با موفقیت به پایان رسیده است. به همین دلیل است که سیاستهای تلاش مجدد و معناشناسی عملیات (Operation Semantics) باید بهطور همزمان و یکپارچه طراحی شوند. برای مقابله با این عدم قطعیت در محیطهای سازمانی، چارچوب RAHSI بر یکپارچگی اجرا تأکید میکند تا از تکرار خطا در اتوماسیون جلوگیری شود.
برای حل این مشکل، توسعهدهندگان باید مفهوم Idempotency — یعنی تضمین اینکه درخواستهای مکرر، اثر یکسان با یک درخواست واحد داشته باشند — را پیاده کنند. این رویکرد، توصیه اصلی AWS در راهنمای معماری (Well-Architected) برای عملیات تغییردهنده (Mutating Operations) است. هدف این نیست که تضمین شود درخواست فقط یکبار اجرا شود، بلکه هدف محافظت از اثر نهایی در برابر تکرار است.
پیادهسازی کلیدهای عملیاتی پایدار
یک عامل ممکن است به دلایل مختلف، ابزاری را چندین بار فراخوانی کند؛ بنابراین سیستم باید تفاوت بین «تلاش مجدد» و «یک اقدام جدید» را بفهمد. یک کلید عملیاتی پایدار (مانند workflow-8472:create-ticket) به سیستم اجازه میدهد یک اقدام منطقی تکراری را شناسایی کند. این کلید باید از یک شناسه بادوام برای اجرای گردشکار (Workflow-run identifier) و یک شناسه پایدار برای گام مربوطه مشتق شود.
تولید یک کلید تصادفی برای هر تلاش، هدف را نابود میکند زیرا سرویس مقصد هر تلاش را یک درخواست منحصربهفرد میبیند و عملیات را تکرار میکند. از سوی دیگر، دو اقدام متفاوت نباید صرفاً به دلیل شباهت ورودیها، کلید مشترک داشته باشند. یک رکورد عملیاتی قدرتمند باید کلید را با موارد زیر مرتبط کند:
- مستاجر (Tenant) یا کاربر احراز هویت شده
- نوع ابزار و عملیات خاص
- هش (Hash) پارامترهای نرمالشده درخواست
- وضعیت اجرای فعلی
- شناسه منبع مقصد (در صورت موجود بودن) و نتیجه نهایی
هش کردن پارامترها حیاتی است؛ زیرا کلید عملیاتی نباید بهطور خاموش اجازه اجرای یک اقدام متفاوت را بدهد. اگر درخواستی با همان کلید اما پارامترهای متفاوت برسد، سیستم باید تضاد (Conflict) را رد کند، به جای اینکه نتیجه قبلی را بازگرداند. Stripe از الگوی مشابهی استفاده میکند که در آن کلیدهای یکسان برای شناسایی تلاشهای مجدد هستند، اما پارامترهای نامنطبق منجر به رد درخواست میشوند. توجه داشته باشید که رفتار دقیق Stripe در مورد نگهداری کلیدها و کش کردن پاسخها مختص پلتفرم آنهاست و نباید فرض شود که برای هر درگاه ابزاری صدق میکند.
مدلسازی اجرا به عنوان ماشین وضعیت
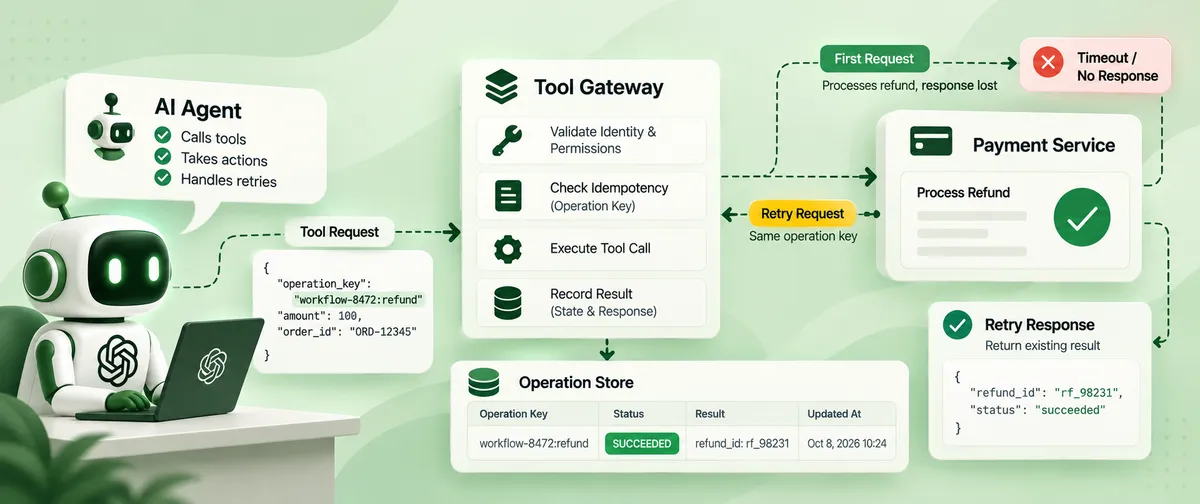
استفاده از یک متغیر سادهی «تکمیلشده» (Boolean) برای اجرای ایمن ابزارها کافی نیست. سیستمها به مدل وضعیت دقیقتری نیاز دارند تا بتوانند عدم قطعیت را مدیریت کنند:
- PENDING: عملیات ثبت شده اما اجرا نشده است.
- RUNNING: یک Worker در حال حاضر مالک یک تلاش برای اجرا است.
- SUCCEEDED: اثر جانبی تایید و نتیجه آن ثبت شده است.
- FAILED_FINAL: عملیات بهگونهای شکست خورده که نباید بهطور خودکار تکرار شود.
- UNKNOWN: نتیجه هنوز قابل تعیین نیست.
وضعیت UNKNOWN برای سرویسهای خارجی حیاتی است؛ جایی که ممکن است عملیات ثبت شده باشد اما تاییدیه ارسال نشده باشد. در یک جریان ساده، سیستم ابتدا درخواست را دریافت، هویت و سیاستها را اعتبارسنجی و سپس کلید عملیات را جستوجو میکند. اگر عملیات تکمیل شده باشد، سیستم نتیجه ثبتشده را برمیگرداند؛ اگر در حال اجرا باشد، وضعیت را نظارت (Poll) یا گزارش میکند؛ و اگر جدید باشد، عملیات را ثبت و اجرا میکند. در نهایت، نتیجه را به یکی از وضعیتهای Succeeded یا Unknown تبدیل میکند.
برای جلوگیری از Race Condition، انتقال وضعیت و ادعای اجرا (Execution Claim) باید از نظر همزمانی ایمن (Concurrency-safe) باشد. استفاده از محدودیتهای یکتایی (Uniqueness Constraints) در پایگاهداده، نوشتنهای شرطی (Conditional Writes) یا مکانیزمهای هماهنگی اتمیک تضمین میکند که دو Worker بهطور مستقل یک اقدام را برای یک کلید اجرا نکنند. با این حال، رزرو کلید در دیتابیس، اثر جانبی خارجی را اتمیک نمیکند. اگر Worker پس از موفقیت عملیات خارجی اما پیش از بهروزرسانی رکورد محلی کرش کند، نتیجه همچنان نامشخص باقی میماند و به یک استراتژی بازیابی صریح نیاز است.
مدیریت مرز تراکنش
Idempotency زمانی سادهترین حالت را دارد که عملیات و رکورد آن در یک مرز تراکنشی واحد باشند. برای مثال، سرویسی که یک تیکت ایجاد میکند و رکورد عملیات را در همان تراکنش دیتابیس ذخیره میکند، میتواند درخواستهای تکراری را از طریق محدودیت یکتایی روی کلید عملیات، به تیکت اصلی متصل کند.
اما اثرات جانبی خارجی — مانند ارسال ایمیل یا پردازش بازگشت وجه — را نمیتوان با تراکنش دیتابیس لغو (Rollback) کرد. برای این اقدامات متقاطع-سیستمی، راهنمای فنی چندین الگو پیشنهاد میکند:
- Transactional Outbox: ثبت تغییر محلی و یک رکورد در صندوق خروجی (Outbox) در یک تراکنش واحد، و سپس تحویل پیام در مرحله بعد. مصرفکنندگان همچنان به پردازش ایمن در برابر تکرار نیاز دارند زیرا تحویل پیام ممکن است بیش از یکبار رخ دهد.
- Downstream Idempotency: ارسال مستقیم کلید پایدار به APIهای خارجی که از کلیدهای Idempotency پشتیبانی میکنند. توسعهدهندگان باید قوانین نگهداری کلید API و رفتار آن در درخواستهای همزمان یا نامنطبق را تایید کنند.
- Reconciliation: پرسوجو از سیستم خارجی با استفاده از یک شناسه عملیاتی بادوام یا مرجع تجاری قابل جستوجو برای بررسی وجود عملیات پس از وقوع تایماوت.
- Compensation: تعریف اقدامات تجاری جدید برای معکوس کردن اثر گامهای تکمیلشده زمانی که گامهای بعدی شکست میخورند. جبران (Compensation) یک اقدام تجاری جدید است، نه یک Rollback واقعی از تاریخچه؛ مثلاً بازگشت وجه، اثر مالی را معکوس میکند بدون اینکه تراکنش اصلی را پاک کند.
هیچیک از این الگوها اجرای «دقیقاً یکبار» (Exactly-once) را در سیستمهای خارجی دلخواه تضمین نمیکند، اما احتمال اثرات تکراری را کاهش داده و آنها را قابل شناسایی یا بازیابی میکند.
تضمین بقای وضعیت
تاریخچه گفتگوهای یک عامل، دفتر کل (Ledger) قابل اعتمادی نیست. اگر پردازش ریاستارت شود، گفتگو کوتاه شود یا Worker تغییر کند، سیستم باید بدون وابستگی به پنجره زمینه (Context Window) — که مثل میز کاری است و فقط جای چند ورق دارد — از وضعیت عملیات آگاه باشد. وضعیت عملیات باید خارج از زمینه گذارای مدل ذخیره شود. در هنگام ازسرگیری، عامل باید وضعیت عملیات موجود خود را از برنامه استعلام کند، به جای اینکه موفقیت یا شکست را از روی آخرین پیام خود استنباط کند. این نیاز به لایههای پاسخگویی دقیقتر منجر به ظهور رویکردهایی مانند سیستم COGEXT در انتقال وضعیت شده است تا از خطاهای عملیاتی در انتقال وضعیت جلوگیری شود.
توسعهدهندگان باید «برنامه عامل» (آنچه قصد انجامش را دارد) را از «رکورد عملیات» (آنچه واقعاً رخ داده) جدا کنند. این جداسازی مانع از آن میشود که تلاشهای مجدد به راهی برای دور زدن احراز هویت تبدیل شوند؛ یک عملیات که قبلاً تایید شده است، نباید بهطور خودکار اجازه یک درخواست تغییریافته، یک مستاجر متفاوت یا اقدامی را بدهد که مجوزهایش از آن زمان تغییر کرده است. معماری باید تمایز روشنی بین برنامه، رکورد عملیات، سیاست احراز هویت و رکورد حسابرسی (Audit Record) حفظ کند.
مشاهده مسیر اجرا
پاسخ موفق مدل به معنای موفقیت ابزار نیست و تایماوت مدل نیز فاش نمیکند که آیا اثر جانبی در مقصد رخ داده است یا خیر. کل مسیر اجرا باید با مکانیزم ردیابی (Trace) یا همبستگی (Correlation) مجهز شود تا ارتباط بین اجرای گردشکار، عملیات منطقی، تلاشهای مجدد و شناسههای درخواست مقصد مشخص باشد.
سیگنالهای عملیاتی مفید عبارتند از:
- تعداد عملیات بر اساس وضعیت نهایی
- تعداد تلاشهای مجدد و نقاط اتمام تلاشها (Retry Exhaustion)
- زمان سپری شده در وضعیتهای RUNNING یا UNKNOWN
- تضادهای کلید تکراری و عدم تطابق پارامترها
- نتایج فرآیند Reconciliation
- تاخیر مقصد، محدودیتهای نرخ (Rate Limits) و خطاها
- اقداماتی که به بررسی انسانی ارجاع داده شدهاند
تلهمتری باید از ذخیره اسرار (Secrets)، پرامپتهای بدون محدودیت یا آرگومانهای حساس ابزار اجتناب کند. مفیدترین هشدار این نیست که «فراخوانی ابزار شکست خورد»، بلکه این است که «عملیات تغییر وضعیت، فراتر از پنجره بازیابی مورد انتظار، حلنشده باقی مانده است»، که نشان میدهد کجا مداخله انسانی مورد نیاز است.
تست مرزهای مبهم
تستهای مسیر موفق (Happy-path) برای ایمنی تلاش مجدد بیفایدهاند. مهندسان باید عمداً شکاف بین «ثبت» و «تایید» را تست کنند. یک مجموعه تست جامع باید شامل موارد زیر باشد:
- دو درخواست همزمان با استفاده از یک کلید عملیاتی یکسان
- تلاش مجدد پس از موفقیت عملیات در مقصد اما گم شدن پاسخ
- کرش کردن Worker پس از وقوع اثر جانبی اما پیش از بهروزرسانی رکورد محلی
- ارسال کلید یکسان با پارامترهای متفاوت
- وقوع تایماوت در مقصد و سپس بازیابی موفق از طریق Reconciliation
- رکورد Idempotency منقضی شده یا در دسترس نبودن آن
- ریاستارتی که عملیاتی را در وضعیت UNKNOWN از سر میگیرد
- درخواست تکراری از سوی یک مستاجر متفاوت یا کاربر غیرمجاز
تایید نهایی باید روی نتیجه تجاری متمرکز باشد، نه فقط پاسخ HTTP. بازگرداندن دو خطای یکسان ثابت نمیکند که از اثر جانبی تکراری جلوگیری شده است. سیستمها همچنین باید مسیر بازیابی را تست کنند؛ سیستمی که یک تلاش مجدد ناایمن را رد میکند اما عملیات را برای همیشه در وضعیت UNKNOWN رها میکند، از نظر عملیاتی کامل نیست.
این تغییر معماری، تصمیم درباره تلاش مجدد را از مدل هوش مصنوعی به کدهای قطعی (Deterministic) برنامه منتقل میکند. یک سیاست عملی برای ابزارهای تغییردهنده این است: استفاده از کلید عملیاتی یکسان، اعمال تلاشهای محدود با فاصله زمانی (Backoff) و نوسان (Jitter) برای شکستهای گذرا، و توقف تلاشهای خودکار زمانی که سیستم نمیتواند ثابت کند تکرار اقدام ایمن است. در حالی که مدل میتواند در تفسیر شکست کمک کند، کد باید اجرا کند که آیا تلاش مجدد مجاز است یا خیر، بهویژه برای اقدامات حساس مانند تغییر مجوزهای حساب، ارسال پیامهای خارجی یا تخصیص زیرساخت.
برای کسانی که عاملهای تولیدی (Production Agents) میسازند، گام بعدی بازبینی فراخوانیهای ابزار موجود و طبقهبندی آنها بر اساس اثر است: فقط خواندنی، ذاتاً Idempotent، یا برگشتناپذیر. تنها پس از این طبقهبندی است که میتوان یک سیاست تلاش مجدد ایمن و قطعی را اعمال کرد. قانون طراحی کلیدی ساده است: عملیات منطقی یکسان را تکرار کنید، نه یک درخواست جدید را که صرفاً شبیه به قبلی است.
گام بعدی شما
- تمام فراخوانیهای ابزار فعلی خود را بازبینی و آنها را به سه دسته «فقط خواندنی»، «ذاتاً Idempotent» و «برگشتناپذیر» تقسیم کنید.
- برای هر ابزار برگشتناپذیر، یک استراتژی تولید کلید پایدار بر اساس شناسه Workflow پیاده کنید.
- مکانیزم Reconciliation را برای سرویسهای خارجی که از کلید Idempotency پشتیبانی نمیکنند، طراحی کنید.
اما مدیریت این وضعیتها در مقیاس میلیونها تراکنش، چالشهای سختافزاری جدیدی ایجاد میکند — به تحلیل ما درباره بهینهسازی استنتاج در لایههای زیرساختی مراجعه کنید.



گفتگو