
استقرار یک مدل یادگیری ماشین، یک اتفاق یکباره نیست، بلکه شروع یک چرخه از زوال مداوم است. اگر امروز مدلی را در محیط تولید رها کنید، دادههای دنیای واقعی بهسرعت تغییر کرده و دقت مدل شما را میکُشند. این پدیده که به عنوان «زوال مدل» شناخته میشود، باعث میشود پیشبینیهایی که در ابتدا دقیق بودند، به مرور زمان غیرقابل اعتماد شوند.
InterSystems IRIS برای حل مشکل «رانش مدل» (Model Drift)، با MLflow ادغام شده است تا یک خط لوله رسمی برای آموزش مداوم (Continuous Training یا CT) ایجاد کند. طبق مستندات فنی منتشر شده در ۳۰ سپتامبر ۲۰۲۶، این سیستم اجازه میدهد مدلها بدون دخالت دستی و بر اساس تغییرات دادهها، دوباره آموزش ببینند و همواره با واقعیتهای جاری دادهها همسو بمانند.
بسیاری از پروژههای علوم داده در دفترچههای Jupyter آغاز میشوند؛ جایی که مدلها روی یک عکس ثابت (Static Snapshot) از دادهها آموزش میبینند. این روش برای مرحله آزمایش و تحقیق عالی است، اما در محیط تولید شکست میخورد چون دادههای واقعی در دنیای بیرون تکامل مییابند و تغییر میکنند. این شکاف ساختاری، نیاز به اتوماسیون سطح ۱ MLOps را ایجاد میکند؛ جایی که انتقال از یک دفترچه کد به یک سرویس تولیدی، به صورت ماژولار و خودکار رخ دهد تا وابستگی به مداخلات دستی حذف شود. این چالش دقیقاً همان نقطهای است که مهندسان طراحی هوش مصنوعی برای تبدیل دموهای آزمایشگاهی به محصولات تجاری بر روی آن تمرکز میکنند تا فاصله میان مدلهای اولیه و محیط عملیاتی پر شود.
زمینه: از آزمایشگاه تا محیط تولید
تئوری پشت این خط لوله CT بر اساس استانداردهای صنعت برای MLOps سطح ۱ است که توسط گوگل تعریف شده است. این رویکرد، مرحله سنتی آزمایش—که معمولاً در Jupyter notebooks انجام میشود—را به یک استقرار در سطح تولید (Production-grade) تبدیل میکند. این تغییر پارادایم اجازه میدهد تا عملکرد مدل در طول زمان به طور مستمر رصد شود و هرگاه عملکرد مدل دچار افت یا تخریب شد، فرآیند بازآموزی به صورت خودکار آغاز گردد. تمام این مراحل در حالی انجام میشود که نسخهبندی دقیق مدلها (Model Versioning) و ثبت وقایع (Logging) برای اهداف حسابرسی و نظارتی به طور کامل حفظ شود.
برای درک بهتر، یک سیستم بهداشتی را تصور کنید که در آن تعریف «تأخیر در رسیدن به appointment» برای هر کلینیک متفاوت است. یک مرکز ممکن است رسیدن با ۵ دقیقه تأخیر را به عنوان «دیر رسیدن» تعریف کند، در حالی که مرکز دیگر از معیار ۱۰ دقیقه استفاده میکند. به همین ترتیب، رصد «بازگشت بیمار به بیمارستان» (Readmission) ممکن است برای یک بخش بعد از ۱۵ روز و برای بخشی دیگر بعد از ۳۰ روز تعریف شود. یک مدل ایستا (Static Model) نمیتواند با این تعاریف متغیر سازگار شود مگر اینکه یک متخصص به صورت دستی مدل را تغییر دهد. با ترکیب یک ذخیرهساز داده پرسرعت و یک رجیستری متنباز، توسعهدهندگان اکنون میتوانند کل محرک (Trigger) بازآموزی را خودکار کنند تا مدل با تعاریف جدید دادهها تطبیق یابد.
معماری خط لوله CT
معماری این سیستم به چندین ماژول حیاتی تقسیم شده است که بار کاری را بین پایگاه داده و پلتفرم مهندسی هوش مصنوعی تقسیم میکند:
- ذخیرهساز ویژگی (Feature Store): جداول SQL در InterSystems IRIS به عنوان «منبع واحد حقیقت» (Single Source of Truth) عمل میکنند. اینجاست که هر پارامتر ثابت یا تعریفی مربوط به دادهها مشخص میشود. متغیرهای چندبعدی (Multidimensional Globals) این سیستم، ذخیرهسازی با سرعت بسیار بالا را ممکن میسازند و ویژگیهای محاسباتی ذخیرهشده (Stored Computed Properties)، تعریف ویژگیهای سفارشی را در کنار دادههای خام تسهیل میکنند.
- خط لوله خودکار: این بخش در واقع نسخه رسمی، ساختاریافته و ماژولار شدهی همان «آزمایشهای سازمانیافته» در دفترچه Jupyter است. این ماژول شامل تمام فرآیندهای پردازش داده و آموزش مدل است که برای دستیابی به بهترین عملکرد کلی مورد نیاز است. در اینجا، ثابتهایی که در طول آزمایش انتخاب شدهاند—مانند Seed، اندازه دادههای تست (Test Size) و تعداد K-folds برای اعتبارسنجی—تعریف میشوند. این بخش از پایتون داخلی (Embedded Python) برای دسترسی مستقیم به کلاسهای IRIS استفاده میکند و در عین حال از کتابخانههای استاندارد مانند Pandas، scikit-learn و MLflow بهره میبرد. این تلاش برای یکپارچهسازی، مشابه رویکردی است که در پلتفرم CoreWeave Forge برای تجمیع چرخه توسعه مدلهای هوش مصنوعی دیده میشود تا پراکندگی ابزارها کاهش یابد.
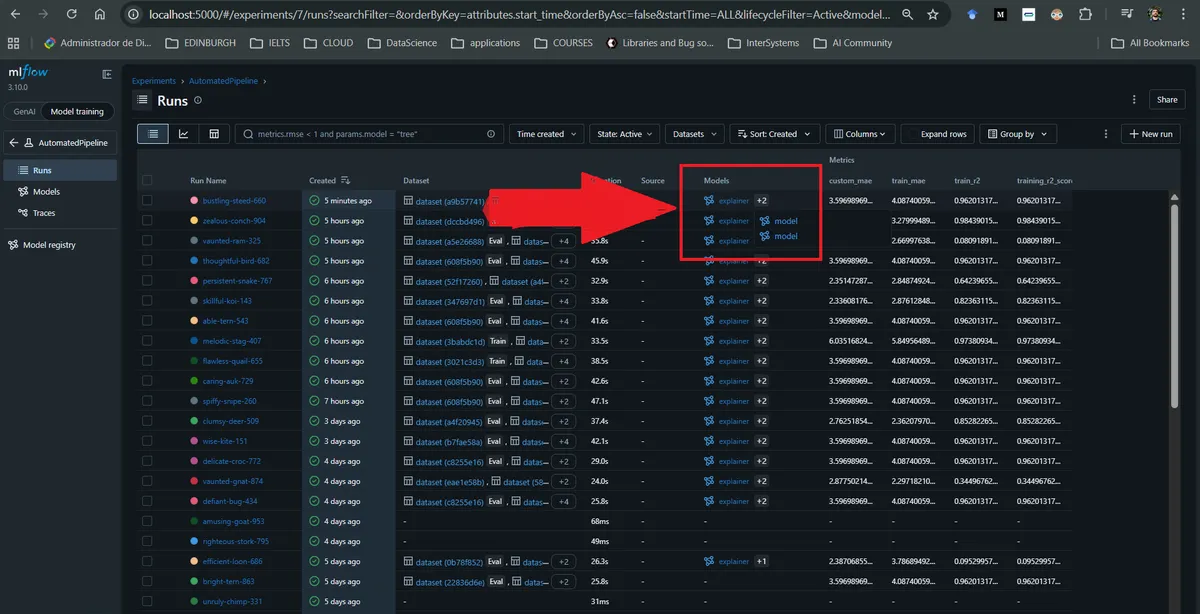
- رجیستری مدل (Model Registry): در اینجا MLflow شکاف موجود را پر میکند. هر مدل آموزشدیده در رجیستری بکاند MLflow ثبت میشود که در طول ساخت پروژه به طور خودکار پیکربندی شده است. این قابلیت به تیمها اجازه میدهد تا عملکرد مدلهای قبلی را کوئری کرده و در هر لحظه، نسخههای خاصی از مدل را مجدداً دانلود کنند.
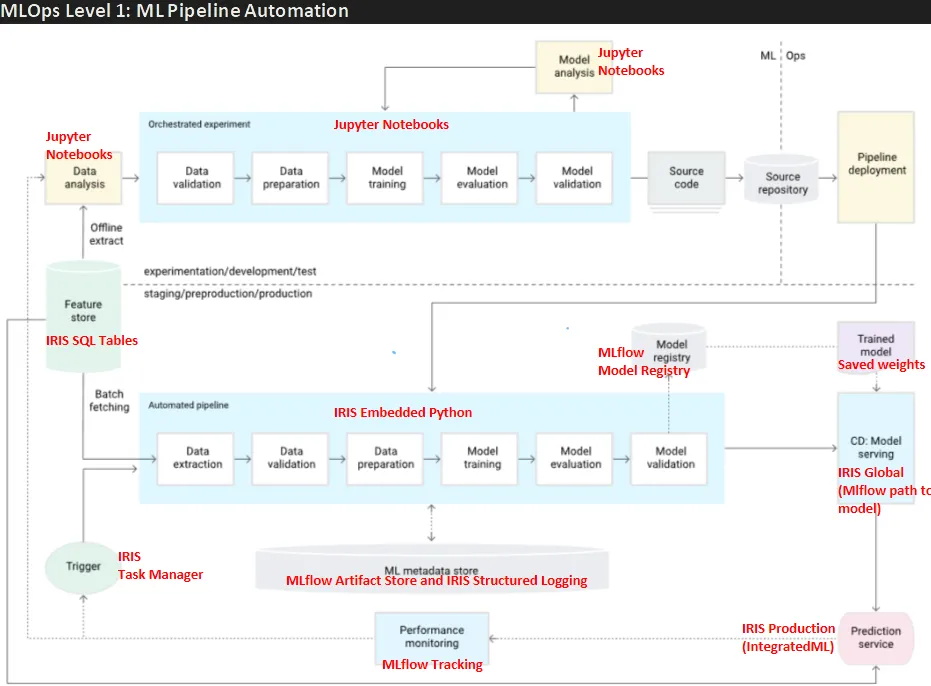
- ذخیرهسازی مدل آموزشدیده: در حالی که بکاند MLflow شامل یک Artifact Store برای ذخیره وزنهای مدل است، این پروژه برای افزایش سرعت بارگذاری، آرتیفکتها را مستقیماً در یک مکان پایدار (Docker volume) ذخیره میکند. اگر این فایلها حذف شوند، سیستم به طور خودکار آنها را از Artifact Store در MLflow بازخوانی و دانلود میکند.
- سرویسدهی مدل (Model Serving): برای جلوگیری از فرآیند کندِ سریالسازی (Serialization) و دسریالسازی اشیاء پایتون، سیستم مسیر فایلهای آرتیفکت مدل را در یک Global در IRIS ذخیره میکند. این کار تضمین میکند که سرویس تولیدی بتواند آخرین مدل را با کمترین تأخیر (Latency) بارگذاری کند. در این پیادهسازی، یک مدل جدید تنها در صورتی ارتقا مییابد (Promote) که عملکردش از مدل قبلی بهتر باشد.
- سرویس پیشبینی: این سرویس که در حال حاضر از طریق پایتون داخلی اجرا میشود، درخواستهای استنتاج (Inference) کلاینتها را مدیریت میکند. نقشه راه آینده شامل انتقال به فرمت PMML است تا سرویس با استفاده از Integrated ML برای مدلهای sklearn قابل اجرا شود، یا استفاده از مدلهای سفارشی IntegratedML در نسخه IRIS 2026.1 برای مدلهایی مانند LightGBM.
نظارت و محرکها (Monitoring and Triggers)
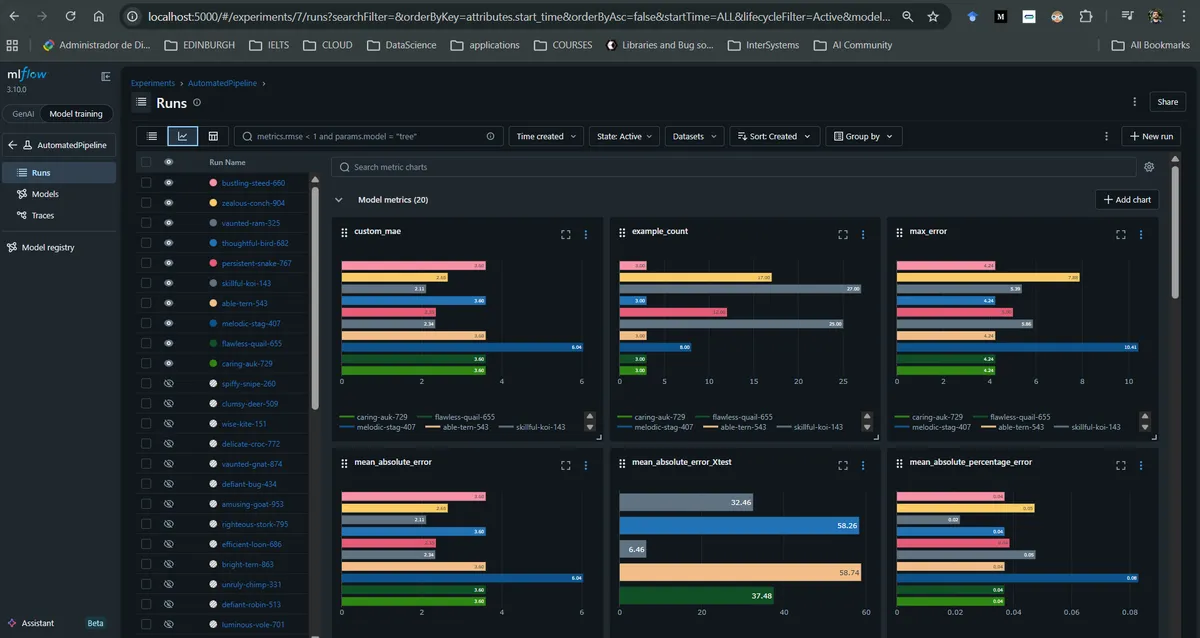
این سیستم صرفاً مدلها را آموزش نمیدهد، بلکه آنها را به طور فعال میپاید. خط لوله از رابط کاربری (UI) MLflow برای رصد عملکرد مدل فعلی در محیط تولید در مقایسه با نسخههای قبلی استفاده میکند. این رابط کاربری اجازه میدهد تا نمودارهای سفارشی با استفاده از هر متغیر ثبتشده، از جمله تاریخ و زمان (Datetime) و معیارهای عملکردی، هم برای تکتک مدلها و هم برای کل مجموعه دادههای تاریخی آموزش رسم شوند.
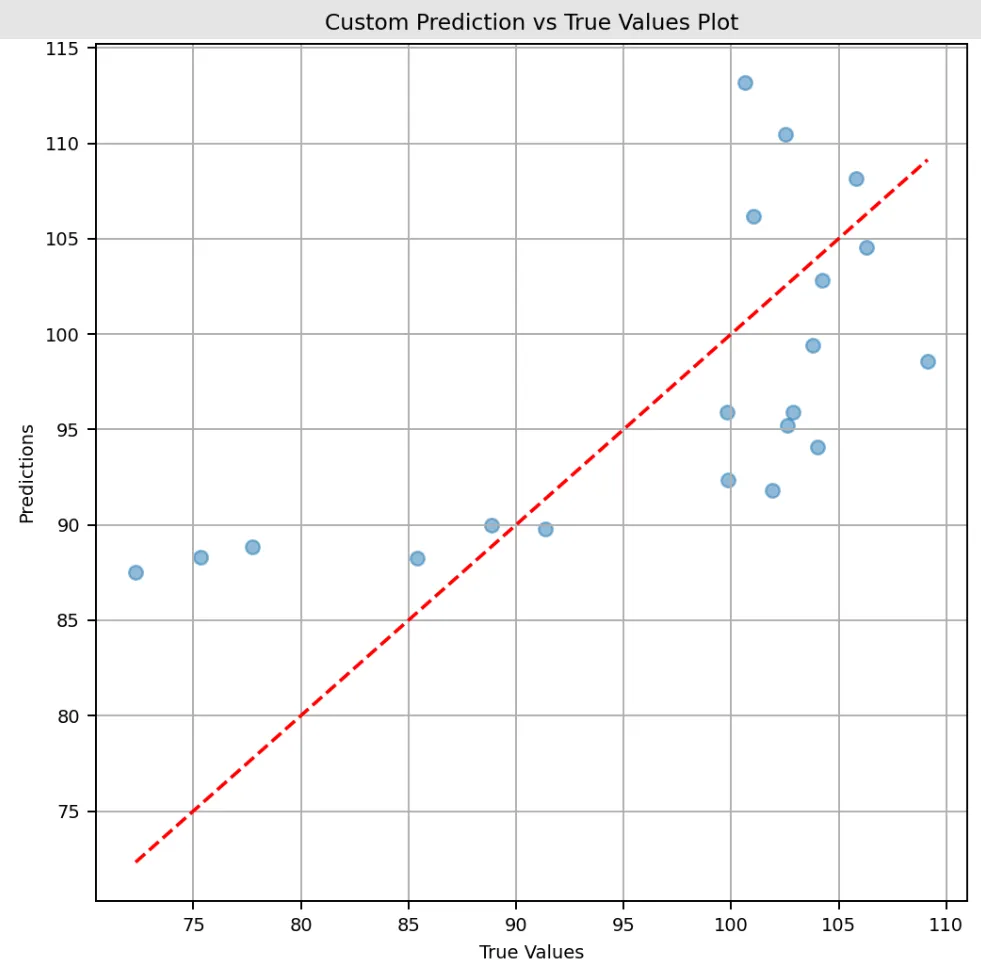
فرآیند بازآموزی بر اساس یک آستانه (Threshold) مشخص به طور خودکار فعال میشود. در این پیادهسازی، سیستم معیار R² را رصد میکند؛ اگر عملکرد مدل از مقدار تعریفشده در MLpipeline.PerformanceMonitoring.R2THRESHOLD پایینتر برود، خط لوله خودکار بلافاصله اجرا میشود. محرکهای معتبر دیگر میتوانند شامل «رانش دادهها» (Data Drift)، در دسترس بودن مقدار مشخصی از دادههای جدید دارای برچسب (Ground Truth)، یا یک زمانبندی دورهای ساده باشد که توسط یک Task Manager مدیریت میشود.
برای تضمین شفافیت کامل، این پیادهسازی از «لاگگذاری ساختاریافته» (Structured Logging) استفاده میکند. این روش، لاگهای مربوط به خط لوله را از لاگهای عمومی سیستم جدا کرده و آنها را در یک مسیر پایدار در داخل Volume کانتینری که IRIS را میزبانی میکند ذخیره میکند؛ امری که برای حسابرسیهای فنی و نظارتی ضروری است.
تفسیرپذیری و مقیاسپذیری آینده
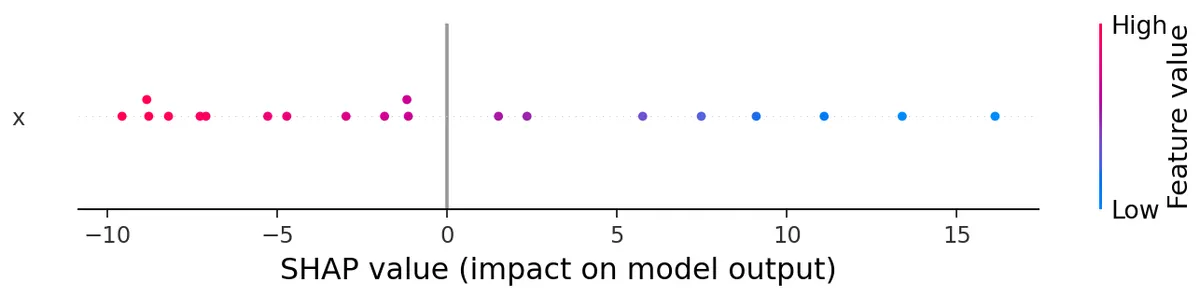
یکی از کاربردیترین افزودنیها به این رویکرد در نسخه v0.1.0، ذخیرهسازی توضیحدهندههای SHAP است. از آنجا که مدلهای پیچیده «جعبه سیاه»—مانند جنگل تصادفی (Random Forest)، XGBoost و شبکههای عصبی—به سختی تفسیر میشوند، خط لوله از پیکربندی داخلی MLflow برای ذخیره SHAP explainers استفاده میکند. این کار دلیل و منطق پشت پیشبینیهای انجام شده توسط مدل در آن لحظه خاص را ارائه میدهد.
در نگاه به آینده، این ادغام از IntegratedML Custom Models در نسخه IRIS 2026.1 بهره خواهد برد. این قابلیت به کاربران اجازه میدهد تا پیشبینیها را از طریق دستورات ساده SQL اجرا کنند، فارغ از اینکه مدل مورد استفاده یک شبکه عصبی باشد، XGBoost باشد یا LightGBM.
توسعهدهندگان همچنین میتوانند این خط لوله را با ادغام Optuna (یک چارچوب متنباز برای بهینهسازی ابرپارامترها) گسترش دهند. در حال حاضر، خط لوله روی دادههای جدید بازآموزی میشود اما ابرپارامترها را ثابت نگه میدارد؛ افزودن Optuna اجازه میدهد مدل در هر چرخه تحریک (Trigger)، دوباره بهینهسازی شود.
برای کاربران سازمانی، تکامل حیاتی بعدی ایجاد یک «دروازه انسانی» (Human-in-the-loop gate) است. در حالی که در حال حاضر مخزن کد مدلها را در صورت عملکرد بهتر به طور خودکار ارتقا میدهد، محیطهای تولید واقعی معمولاً نیازمند تأیید انسانی هستند تا یک مدل جدید جایگزین مدل فعال (Live) شود.
این تغییر به سمت خط لولههای CT یکپارچه، معیار استقرار هوش مصنوعی را تغییر میدهد. این رویکرد صنعت را از استراتژی «استقرار و فراموشی» دور کرده و به سمت یک سیستم زنده میبرد که زوال مدل را به جای یک بحران، به عنوان یک مسئله مهندسی قابل مدیریت میبیند.



گفتگو