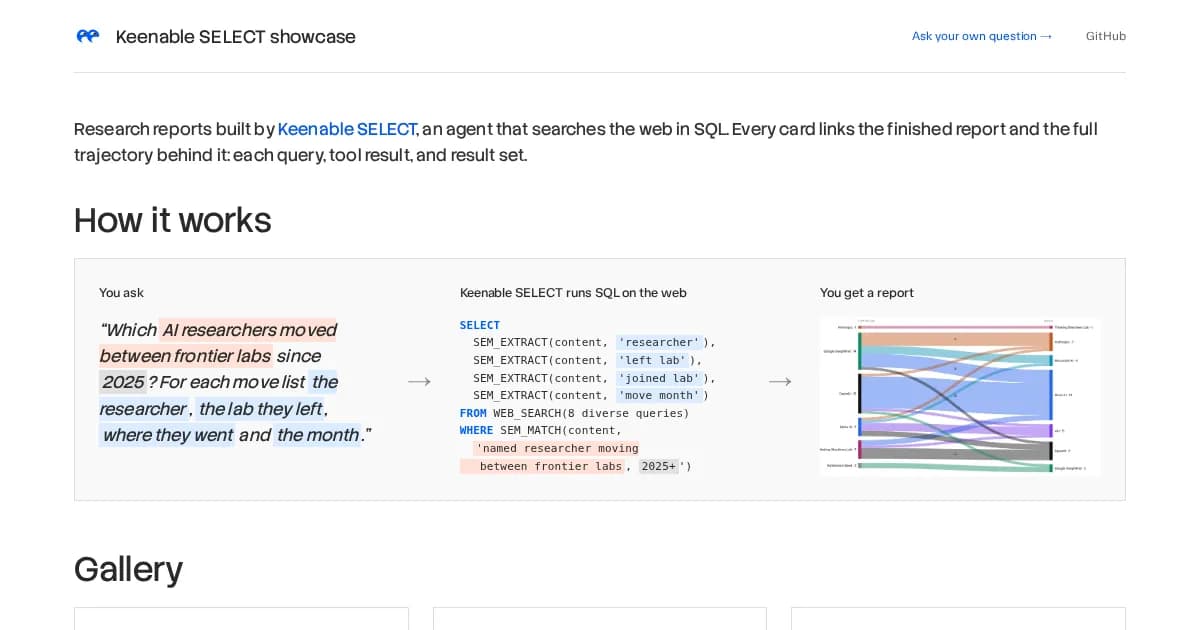
تصور کنید بهجای اینکه یک دستیار دیجیتال ساعتها وقت صرف خواندن تکتک مقالات وب کند، بتواند در یک ثانیه از کل اینترنت بپرسد «کدام پژوهشگران AI از سال ۲۰۲۵ آزمایشگاه خود را تغییر دادهاند؟» و پاسخی دقیق و جدولبندیشده دریافت کند. در حالی که مرور وب سنتی توسط مدلهای زبانی بزرگ (LLM) اغلب هزینههای توکن بسیار بالایی دارد، اکنون یک کوئری واحد SQL میتواند بیش از ۱,۰۰۰ صفحه وب را برای استخراج دادههای ساختاریافته اسکن کند.
این رویای تبدیل وب به یک پایگاهدادهٔ قابل جستوجو، اکنون با معرفی Keenable SELECT در ۱ سپتامبر ۲۰۲۶ به واقعیت تبدیل شده است. این ابزار با پیادهسازی یک رابط DuckDB (یک پایگاهداده تحلیلی سریع) در حالت read-only برای دادههای زنده وب، اجازه میدهد فیلتر کردن و استخراج دادهها بهجای لایه مدل، در لایه کوئری انجام شود و عملاً وب باز را به یک دیتابیس قابل جستوجو تبدیل کند.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی پنجرههای متنی اشاره کردیم، محدودیت اصلی عاملهای فعلی، هزینه بالای توکنها و محدودیت حافظه است. اکثر عاملها (Agents) — شبیه به کارمندی که برای هر جواب باید ده کتاب را ورق بزند — در یک حلقه کند از جستوجوی لینک، خواندن تکتک صفحات و سپس ترکیب آنها گیر کردهاند. این فرآیند گران است و توسط پنجره زمینه (Context Window) مدل محدود میشود.
Keenable SELECT این چرخه را با یک سرور پروتکل زمینهٔ مدل (MCP) جایگزین میکند که عملگرهای معنایی را خارج از پایگاهداده اجرا کرده و نتایج را به صورت یک مجموعه ردیفهای SQL بازمیگرداند. طبق گزارش منتشرشده در keenableai.github.io، این سامانه از دو عامل مجزا استفاده میکند:
- عامل پژوهشگر (Research Agent): یک مدل زبانی بزرگ مبتنی بر حلقه ابزار (tool-loop) که کوئریهای SQL را از طریق ابزار
selectمینویسد و تا رسیدن به دادههای کافی، آنها را اجرا میکند. - عامل گزارشگر (Report Agent): مدلی تخصصی که دیتافریمهای (Dataframes) حاصل را گرفته و در یک جلسه پایتون در محیط ایزوله (Sandboxed)، یک گزارش نهایی HTML میسازد.
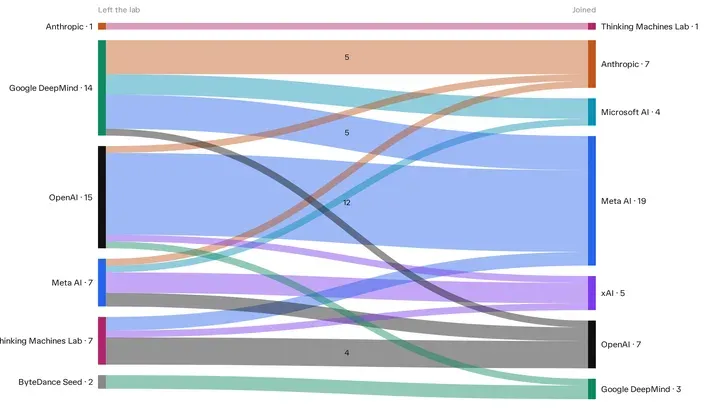
بر اساس مستندات فنی، هسته این سیستم بر عملگرهای معنایی مانند WEB_SEARCH و SEM_EXTRACT استوار است. برای مثال، اگر کاربر به دنبال پژوهشگرانی باشد که از سال ۲۰۲۵ آزمایشگاه خود را تغییر دادهاند، سیستم یک دستور SELECT با یک عبارت WHERE اجرا میکند تا نتایج را بدون هیچ هزینهای برای LLM فیلتر کند. مدل تنها زمانی فراخوانی میشود تا فیلدهای خاصی را برای ردیفهای باقیمانده استخراج کند.
در این معماری، عملیات سنگین از پنجره استدلال مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — به موتور کوئری منتقل میشود. با استفاده از DuckDB برای گروهبندی و فیلتر کردن ردیفها پیش از ترکیب نهایی، عامل از «مالیات توکن» مرتبط با خواندن صفحات نامرتبط رها میشود.
برای کاربر نهایی، این یعنی گزارشهای پژوهشی دیگر صرفاً خلاصهای از چند لینک نیستند، بلکه مجموعهای از دادههای ساختاریافتهاند. سیستم هر نتیجه کوئری را با یک شناسه منحصربهفرد ذخیره میکند، که اجازه میدهد پرسشهای تکمیلی مستقیماً بر روی نسخههای ذخیرهشده (Transcripts) بنا شوند.
این رویکرد نشان میدهد که آینده وب، نه به شکل مجموعهای از اسناد، بلکه به صورت یک API ساختاریافته است. در واقع، عاملهای هوش مصنوعی از حالت «خواندن» به حالت «کوئری زدن» تغییر وضعیت میدهند تا مقیاس دادههای قابل ترکیب در هر جلسه بهشدت افزایش یابد.
گام بعدی شما
- مستندات سرور MCP را برای ادغام جستوجوی مبتنی بر SQL در عاملهای شخصی خود بررسی کنید.
- تفاوت هزینه استنتاج را در پروژههایی که نیاز به اسکن تعداد زیادی صفحه وب دارند، اندازه بگیرید.
- ساختار دادههای خروجی DuckDB را برای تبدیل به داشبوردهای مدیریتی به کار ببرید.
اما داستان سختافزاری این تحول و نحوه مدیریت حافظه در مقیاس کلان حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو