تصور کنید به جای ساعتها کلنجار رفتن با نرمافزارهای پیچیده تدوین برای همراستاسازی صدا و تصویر، تمام این فرآیند را با یک درخواست ساده به سرور بسپارید. اکنون توسعهدهندگان میتوانند انسانهای دیجیتالی سخنگو را نه با برشهای ویدئویی شکننده و متدهای پیچیده دوخت ویدیو (Video Stitching)، بلکه از طریق یک زنجیره بهینه از تولید تصویر به ویدیو توسط مدلهای Kling و یک نقطه اتصال (Endpoint) تخصصی برای همراستاسازی لبها خلق کنند. بر اساس یک راهنمای فنی که در تاریخ ۹ اوت ۲۰۲۶ منتشر شد، توسعهدهندگان اکنون میتوانند کل این خط لوله (Pipeline) را با مدیریت تراز دهان از طریق یک فراخوانی ساده API در پلتفرم Ace Data Cloud خودکار کنند.

خط لوله تولید عکسهای سخنگو
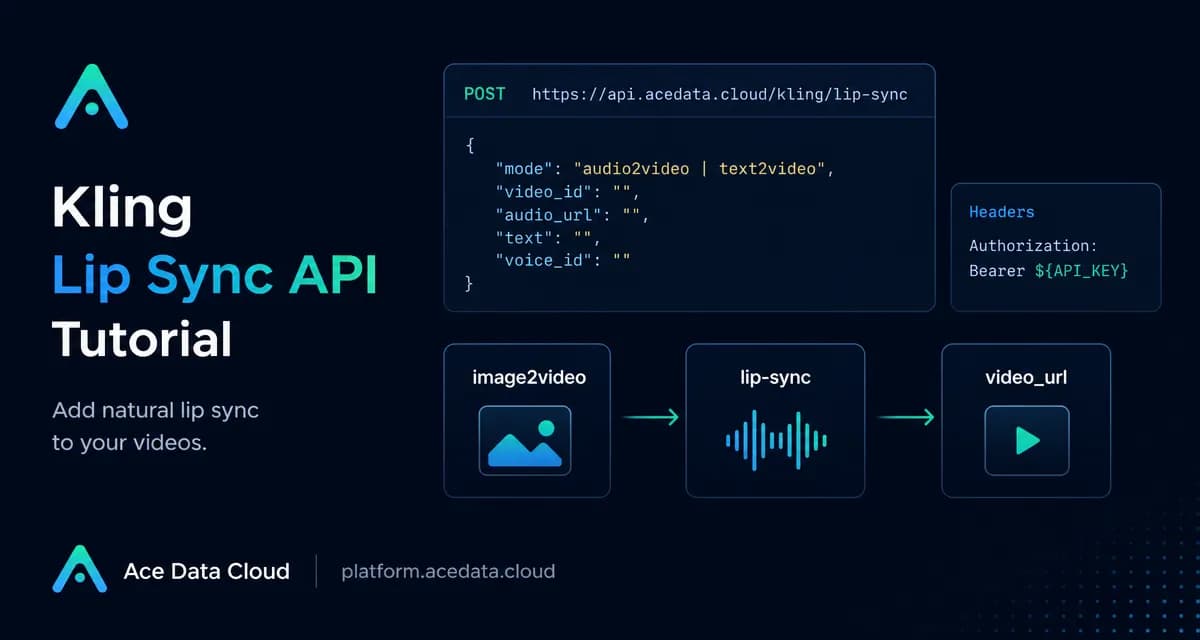
خلق یک عکس سخنگو که باورپذیر باشد، معمولاً نیازمند دو مرحله مجزای پردازش توسط هوش مصنوعی است. بخش دشوار این کار، معمولاً تولید حرکات چهره نیست، بلکه حفظ همراستایی دقیق حرکات دهان با صدای ارائه شده است. جریان کاری در این سیستم به شرح زیر است: تصویر ثابت $\to$ مسیر /kling/videos (تبدیل تصویر به ویدیو) $\to$ دریافت video_id $\to$ مسیر /kling/lip-sync $\to$ دریافت video_url نهایی.
در مرحله اول، یک تصویر ثابت به یک کلیپ ویدئویی کوتاه تبدیل میشود تا حرکات طبیعی سر و بدن شخصیت ایجاد شود و پایه بصری شکل بگیرد. در مرحله دوم، لایه همراستاسازی لبها (Lip-sync layer)، حرکات دهان را بازنویسی میکند تا با یک ترک صوتی خاص یا یک متن (Script) مطابقت داشته باشد. این فرآیند تضمین میکند که شخصیت به جای تکان دادن تصادفی لبها، به گونهای به نظر برسد که واقعاً در حال صحبت کردن است.
مکانیسمهای API و احراز هویت
نقطه اتصال برای اجرای این فرآیند POST https://api.acedata.cloud/kling/lip-sync است. این Endpoint درخواستها را در قالب application/json میپذیرد و پاسخها را نیز در همین قالب بازمیگرداند. توسعهدهندگان برای احراز هویت باید از یک توکن Bearer در هدرهای درخواست استفاده کنند. هدرهای مورد نیاز عبارتند از:
authorization: Bearer ${API_KEY}content-type: application/jsonaccept: application/json
برای کسانی که در حال ساخت ابزارهای تولیدی (Production) هستند، Kling Lip Sync API دو حالت عملیاتی اصلی را ارائه میدهد:
- audio2video: در این حالت، یک فایل صوتی خارجی با فرمتهای MP3، WAV، M4A یا AAC برای هدایت جلوههای بصری استفاده میشود. این روش برای استفاده از گویندگان موجود، فایلهای تبدیل متن به گفتار (TTS) یا روایتهای ضبط شده ایدهآل است. فایل صوتی باید حتماً کمتر از ۵ مگابایت باشد و مدت زمان آن باید به طور دقیق با طول ویدیو مطابقت داشته باشد تا از خطاهای همگامسازی جلوگیری شود. به عنوان مثال، یک روایت ۱۲ ثانیهای برای یک کلیپ ۵ ثانیهای نامناسب است و منجر به خطا میشود.
- text2video: در این حالت، سیستم هم صدا و هم حرکت لب را مستقیماً از یک رشته متنی (تا سقف ۱۲۰ کاراکتر) تولید میکند. برای این کار، نیاز به یک شناسه صوتی یا
voice_idخاص (مانندgenshin_vindi2) است. این حالت از زبانهای انگلیسی (en) و چینی (zh) پشتیبانی میکند و سرعت پخش آن از ۰.۸ تا ۲.۰ قابل تنظیم است. این قابلیت به ویژه برای پیشنمایشهای رابط کاربری (UI)، کلیپهای آموزشی (Onboarding) یا توضیحدهندههای کوتاه محصول که متن آنها به صورت پویا تولید میشود، بسیار کاربردی است.

جزئیات پیادهسازی
برای پیادهسازی این زنجیره، توسعهدهنده ابتدا درخواستی را به نقطه اتصال /kling/videos با اکشن image2video ارسال میکند. یک درخواست استاندارد معمولاً از مدل kling-v2-1-master با پرومپتی مانند "look at camera, natural" (به دوربین نگاه کن، طبیعی) و مدت زمان ۵ ثانیه استفاده میکند. این مرحله یک video_id بازمیگرداند. کلیپی که تولید میشود باید یا ۵ یا ۱۰ ثانیه باشد و در ۳۰ روز گذشته تولید شده باشد. سپس این شناسه به نقطه اتصال /kling/lip-sync ارسال میشود تا روایت صوتی روی آن اعمال گردد.
محدودیتهای ویدیوهای مبدا
این API در مورد ویدیوهای ورودی انعطافپذیری بالایی دارد و اجازه میدهد کاربر یا از video_id (که برای کسانی که از Kling برای انیمیشن استفاده میکنند راحتتر است) یا از یک video_url برای فایلهای عمومی استفاده کند. در صورت استفاده از لینک ویدیو (video_url)، محدودیتهای زیر اعمال میشود:
- فرمت: باید حتماً
.mp4یا.movباشد. - حجم فایل: حداکثر ۱۰۰ مگابایت.
- طول ویدیو: بین ۲ تا ۱۰ ثانیه.
- رزولوشن: ۷۲۰p یا ۱۰۸۰p.
- ابعاد: بین ۷۲۰ تا ۱۹۲۰ پیکسل.
مدیریت پاسخها و وضعیت
یک پاسخ موفق در حالت سنکرون (Synchronous)، یک شیء JSON شامل task_id (شناسه تکلیف)، video_id جدید، video_url (که خروجی نهایی برای اپلیکیشن یا ادیتور است)، duration (مثلاً "۴.۹۶۶") و وضعیت state با مقدار "succeed" است. شناسه ویدیو بازگردانده شده قابل استفاده مجدد برای عملیاتهای بعدی Kling، مانند مراحل گسترش ویدیو (Extension) یا همراستاسازیهای لب تکمیلی است.
حالت ناهمزمان (Async) برای مقیاس صنعتی
برای اپلیکیشنهای سازمانی در مقیاس بزرگ، API از حالت ناهمزمان پشتیبانی میکند تا از باز ماندن درخواستها در حین رندرینگ جلوگیری شود. توسعهدهندگان میتوانند پرچم async را روی true تنظیم کنند یا یک callback_url ارائه دهند. در هر دو حالت، یک task_id بلافاصله بازگردانده میشود. برای پیگیری نتایج، توسعهدهندگان باید نقطه اتصال /kling/tasks را با اکشن retrieve و شناسه تکلیف مربوطه فراخوانی کنند.
یک الگوی پیشنهادی برای محیط تولید این است که درخواست اصلی، task_id و وضعیت فعلی در یک پایگاه داده ذخیره شود و سپس یک Worker (پردازشگر پسزمینه) از طریق Callback یا Polling (پرسوجوی متناوب) وضعیت را بررسی کند تا تکلیف به وضعیت نهایی برسد.
نردههای حفاظتی و بهترین شیوهها
این تغییر رویکرد به سمت همراستاسازی لب مبتنی بر API، شیوه خلق محتوای دیجیتال را تغییر میدهد و آن را از یک وظیفه دستی تدوین به یک عملیات بکانند تبدیل میکند. به جای استخدام یک متخصص موشنگرافیک برای تراز کردن صدا و تصویر، شرکتها اکنون میتوانند محتوا را به صورت پویا و بر اساس دادههای لحظهای کاربران تولید کنند.
برای تضمین پایداری، توسعهدهندگان باید محدودیتهای زیر را در لایه رابط کاربری یا مرز API اعتبارسنجی کنند:
- الزام به ارسال دقیقاً یکی از دو مورد
video_idیاvideo_url. - رد کردن رشتههای
text2videoکه طول آنها بیش از ۱۲۰ کاراکتر است. - بررسی اینکه فایلهای
audio2videoاز ۵ مگابایت تجاوز نکنند. - اولویت دادن به ویدیوهایی که چهره فرد در آنها شفاف، رو به جلو و تنها حضور دارد.
- تطبیق دقیق طول متن یا فایل صوتی با طول کلیپ ویدئویی.
با اعمال این بررسیها، توسعهدهندگان از درخواستهای نادرست رایج جلوگیری کرده و نمونههای اولیه (Prototypes) برای گویندههای انسان دیجیتال را پایدارتر میکنند. برای بررسی کامل محدودیتهای فنی و جداول فیلدها، توسعهدهندگان میتوانند به مستندات رسمی ادغام در پلتفرم Ace Data Cloud مراجعه کنند.
گام بعدی شما
- اگر توسعهدهنده هستید، مستندات Ace Data Cloud را برای تست حالت
text2videoدر پیشنمایشهای رابط کاربری بررسی کنید. - برای ویدیوهای بلندتر از ۱۰ ثانیه، از استراتژی تولید تکهای و سپس اتصال آنها در مرحله تدوین استفاده کنید.
- ترتیب ارسال درخواستها را به گونهای تنظیم کنید که ابتدا ویدیو تولید و سپس Lip Sync اعمال شود تا از اتلاف توکنها جلوگیری کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک فشار محاسباتی این مدلها به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو