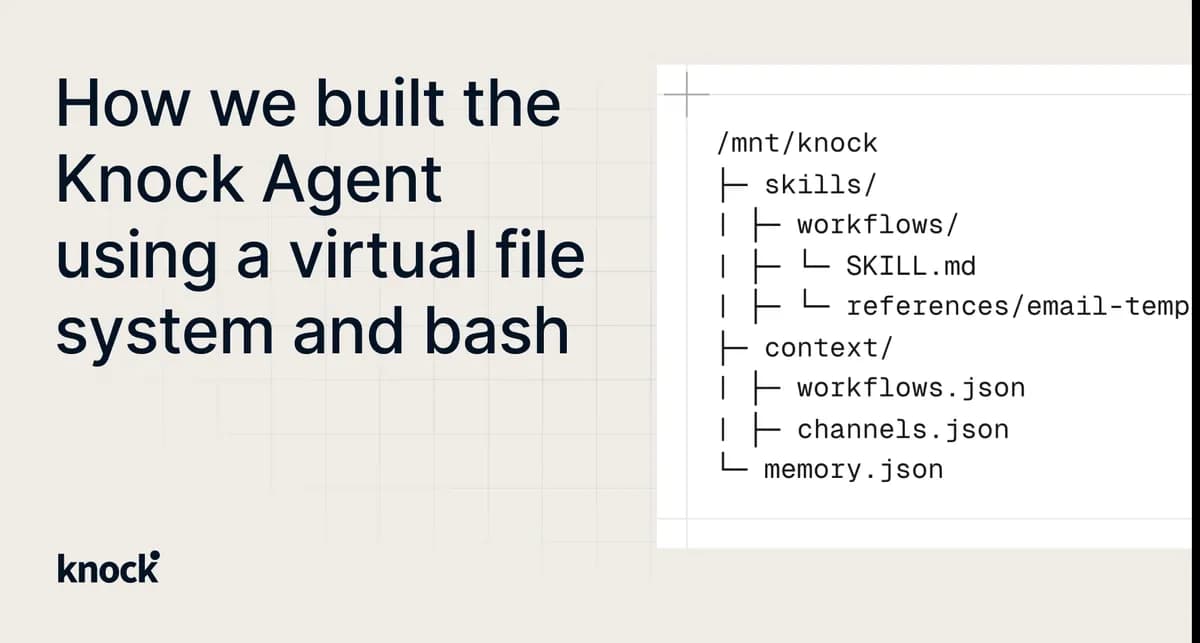
تصور کنید به جای اینکه برای هر تغییر کوچک در تنظیمات یک نرمافزار، دهها فرم مختلف را پر کنید، تمام تنظیمات آن نرمافزار را در قالب چند فایل متنی ساده ببینید و با یک دستور سریع تغییر دهید. این دقیقاً همان تغییری است که Knock در نحوه تعامل عاملهای هوش مصنوعی با دادههای سازمانی ایجاد کرده است.
عامل Knock به کاربران اجازه میدهد تا منابع پیامرسانی مشتریان — شامل جریانهای کاری (Workflows)، قالبها (Templates) و مخاطبان (Audiences) — را از طریق یک رابط گفتگو مدیریت کنند. طبق اعلام knock.app، این سیستم که در مارس ۲۰۲۶ عرضه شد، از یک رویکرد متناقض با استانداردهای فعلی استفاده میکند: بهجای تعریف ابزارهای مجزا برای هر عملیات، کل دادههای حساب کاربر را به عنوان یک دایرکتوری محلی در اختیار عامل (Agent) قرار میدهد. این تغییر، منطق عملکردی عامل را به معماریهای پیشرفتهای نظیر Claude Code نزدیک میکند.
این عامل به گونهای طراحی شده است که دسترسی بسیار بالایی داشته باشد؛ به این معنا که میتوان آن را از طریق داشبورد Knock، یک فضای کاری متصل در Slack، API یا سرور MCP تیم فراخوانی کرد. چشمانداز این سیستم، مدیریت هر آنچه از طریق داشبورد Knock قابل دسترسی است، میباشد تا پیامهایی ایجاد کند که با سیستم طراحی خاص شرکت، لحن بیان (Tone of Voice) و مدلسازی دادههای آن همسو باشد. برای دستیابی به این هدف، Knock یک «هارنس» یا چارچوب اجرایی غنی برای عامل توسعه داد که قادر است به تمام گستره دادههای حساب دسترسی پیدا کند تا هنگام پاسخ به سوالات یا تولید پیامها، بستر (Context) لازم را فراهم آورد.
همانطور که در تحلیلهای پیشین ما دربارهی پروتکلهای ارتباطی مدلها اشاره کردیم، مدیریت حجم زیاد ابزارها همیشه یک چالش بوده است. اکثر دستیارهای هوش مصنوعی بر الگوی «یک ابزار برای هر نوع» (tool-per-type) تکیه میکنند، جایی که هر اکشن API یک ابزار مجزا است. این رویکرد مشابه استراتژیهایی است که سرویسهای مدیریت ایمیل مانند Nylas برای تبدیل API به ابزارهای مستقل به کار میبرند تا دسترسی عاملها به دادهها را تسهیل کنند. Knock در اولین نمونهٔ اولیه خود از همین الگو استفاده میکرد تا منحصراً روی جریانهای کاری (Workflows) عمل کند، زیرا این حوزه بسیار عمیق است و تفاوتهای ظریف زیادی دارد. در آن مدل، هر ابزار یک دستور پایه (Primitive) از API مدیریت را نمایش میداد؛ مثلاً افزودن یک مرحله تأخیر (Delay step) به یک جریان کاری یا ساخت یک قالب ایمیل با استفاده از زبان بلوکی بصری. توصیفات ابزارها، ویژگیهای خاص و مثالها را کدگذاری میکردند و ورودیهای ابزار نیز انواع فیلدهای مورد نیاز را تعریف مینمودند.
در حالی که این روش در ابتدا جواب داد و نتایج خوبی تولید کرد، تیم توسعه متوجه شد که این مدل مقیاسپذیر نیست. نمایش یک ابزار برای هر منبع در API مدیریت، باعث حجیم شدن پنجرهٔ زمینه (Context Window) میشد، مگر اینکه یک لایه پیچیده برای مسیریابی ابزارها یا یک زبان اسکریپتنویسی مجزا پیادهسازی میکردند. این درک باعث شد آنها به دنبال یک معماری مقیاسپذیرتر بگردند.
برای حل این مشکل، تیم Knock به الگویی نگاه کرد که شرکت Vercel برای ابزار داخلی دادههای خود به نام d0 استفاده کرده بود. Vercel در پست وبلاگی با عنوان «چگونه عاملها را با سیستمفایل و Bash بسازیم»، توضیح داد که چگونه یک سیستمفایل به عامل اجازه میدهد بستر را کشف کند و یک دامنه را به سیستمفایل نگاشت کند تا لایه بستر را تقویت نماید. Knock پیش از این یک CLI داشت که به تیمها اجازه میداد منابع را به صورت محلی دریافت کنند؛ بنابراین تصمیم گرفتند به عامل یک سیستمفایل حاوی محتویات حساب و قابلیت استفاده از Bash برای اسکریپتنویسی روی آن بدهند. در این مدل، عامل برای جمعآوری بستر در سیستمفایل جستوجو میکند و برای عملیات بهینه، اسکریپتهای Bash مینویسد. هنگام ویرایش یک جریان کاری یا قالب، عامل فایل را در جای خود تغییر میدهد و سپس برای تثبیت تغییرات، فراخوانی را به Knock بازمیگرداند.
معماری مبتنی بر Elixir
از آنجا که زیرساخت Knock بر پایه اکوسیم Elixir است، آنها نتوانستند از کتابخانههای موجود TypeScript برای Bash مجازی استفاده کنند. در تعطیلات سال ۲۰۲۵، شخصی به نام Malte از Vercel کتابخانه just-bash را منتشر کرد که به عاملها اجازه میدهد بدون نیاز به بوت کردن یک ایمیج لینوکس، دارای یک سیستمفایل یونیکس و محیط Bash باشند. تیم Knock، از جمله Ivar Vong، این کتابخانه را به زبان Elixir پورت کردند. این کار منجر به ایجاد یک مفسر Bash امن و در حافظه (In-memory) شد که از همان مجموعه تستها و دادههای نمونه نسخه اصلی استفاده میکند و از دستورات ضروری مانند jq ،ls و cat پشتیبانی میکند.

تیم توسعه بهطور آگاهانه سیستمفایل مجازی را به محیطهای ایزولهشده (Sandbox) کامل ترجیح داد. آنها به این نتیجه رسیدند که یک سندباکس کامل برای نیازهای آنها «زیادهروی» (Overkill) است و در مقایسه با گزینه مجازی در حافظه، هزینههای پردازشی بیشتری ایجاد میکند. علاوه بر این، یک سندباکس کامل باعث ایجاد مشکلات سختتر در همگامسازی محتوا و تغییراتی میشود که خارج از اپلیکیشن اعمال شدهاند؛ موضوعی که تیم ترجیح داد در حال حاضر از آن چشمپوشی کند.
آنها با پیروی از اصل جداسازی «دستها» (اجراکننده) از «مغز» (مدل زبانی بزرگ یا LLM)، میتوانند در آینده اگر مقیاس پیچیدگی تغییر کرد یا اگر به زبان اسکریپتنویسی قدرتمندتری مانند پایتون نیاز پیدا کردند، به راحتی فراخوانیهای Bash مجازی را با یک سندباکس واقعی جایگزین کنند.
پشته فنی این سیستم به شرح زیر سازمانیافته است:
- حلقه LLM: مستقیماً روی Anthropic API اجرا میشود و بسته به تسک خاص، از مدلهای مختلفی استفاده میکند.
- مدیریت وضعیت: استفاده از کتابخانه Oban در Elixir که توسط Postgres پشتیبانی میشود تا جریانهای کاری بادوام را مدیریت کرده و امکان تکرار ایمن مراحل (Retries) فراهم شود.
- سندباکس: یک پروسه طولانیعمر در Elixir که شامل سیستمفایل مجازی و نمونه Bash است. این پروسهها به صورت «تنبل» (Lazy) استارت میخورند؛ یعنی فقط زمانی که اولین درخواست به سیستمفایل نیاز داشته باشد فعال میشوند تا پاسخها سریع باشند و برای درخواستهای ساده، کمترین اثر (Footprint) را داشته باشند.
جزئیات سیستمفایل و مدیریت منابع
وقتی هیچ سندباکسی در حال اجرا نیست، سیستمفایل با متادیتای آبجکتهای حساب کاربر مقداردهی اولیه (Bootstrap) میشود. این کار یک کاتالوگ کامل از منابع را فراهم میکند و در عین حال اجازه میدهد منابع بزرگتر، دقیقاً پیش از آنکه عامل نیاز به عملیات روی آنها داشته باشد، به صورت تنبل بارگذاری شوند. ساختار سیستمفایل به شرح زیر است:
متادیتا در سطح ریشه:
account.json: بستر کلی حساب را فراهم میکند.channels.json: مجموعهای از کانالهای موجود را لیست میکند.workflows.json: فهرست کامل تمام جریانهای کاری در حساب را ارائه میدهد.- فایلهای اضافی که سایر منابع حساب را نگاشت میکنند.
پوشههای منابع (که از طریق ابزار
load_resourcesبارگذاری میشوند):workflows/[workflow-name]/workflow.json: حاوی پیکربندی کامل جریان کاری، شامل مراحل و تنظیمات است.workflows/[workflow-name]/steps/email_1/template.html: قالب پیام خاص برای یک مرحله ایمیلی.workflows/[workflow-name]/steps/in_app_1/template.md: قالب مارکداون برای یک مرحله پیام دروناپلیکیشنی.
از آنجا که پروسه سندباکس طولانیعمر است، در نوبتهای بعدی گفتگو، این محتوا بارگذاری شده باقی میماند. این حالت برای تعاملات چندمرحلهای (Multi-turn) که در آن کاربر و عامل روی مجموعهای از بهروزرسانیهای یک جریان کاری یا قالب همکاری میکنند، ایدهآل است.
برای تعامل با این محیط، عامل به مجموعه ابزارهای خاصی مجهز شده است:
bash: دستورات Bash را مستقیماً اجرا میکند.read_file: روش ترجیحی برای خواندن فایلها (به جای استفاده ازcat).edit_file: جایگزینیهای هدفمند رشتهها را با تبدیل رشته x به y انجام میدهد.write_file: یک فایل کامل را در سیستم مینویسد.upsert_resource: پل حیاتی است که تغییرات سیستمفایل را به حساب واقعی Knock بازمیگرداند. این کار را با خواندن یک باندل ذخیره شده در سیستمفایل مجازی و فراخوانی همان متدهای داخلی مورد استفاده در API مدیریت انجام میدهد.
مدیریت دانش از طریق «مهارتها»
ارسال تمام دفترچه راهنمای محصول در هر پرامپت سیستمی ناکارآمد است. به جای آن، Knock سیستمی به نام «مهارتها» (Skills) را پیاده کرد. اینها فایلهای Markdown هستند که در سیستمفایل مجازی ذخیره شدهاند و عامل باید پیش از ویرایش یک منبع خاص، آنها را «یاد بگیرد». هر مهارت حاوی اطلاعات لازم برای درک تفاوتهای ظریف یک منبع است و اشتباهات رایگی که باید از آنها اجتناب کرد را برجسته میکند.
مهارتها برای ساختارمند نگه داشتن دانش عامل در دایرکتوریها سازمانیافتهاند:
skills/workflows/SKILL.md: حاوی تعاریف سطح بالای مهارتهاست.skills/workflows/references/template-editing.md: مراجع فنی خاص برای ویرایش قالبها را ارائه میدهد.- دایرکتوریهای دیگر برای
broadcasts/،guides/و موارد بیشتر.
این مهارتها هنگام فراخوانی در پرامپت سیستمی گنجانده میشوند تا عامل از گستره کامل مهارتهای موجود آگاه باشد. با این حال، عامل باید ابزار skill را فراخوانی کند تا متادیتای کامل را بازیابی کرده و آن را در پنجره زمینه بارگذاری کند. این سیستم هم از مهارتهای تعریفشده توسط سیستم و هم از مهارتهای سفارشی تعریفشده توسط مشتری پشتیبانی میکند تا اطمینان حاصل شود که عامل دستورالعملهای خاص هر حساب را دنبال میکند.
پل ارتباطی بین فایلها و APIها
همه دادهها در یک قالب فایل استاتیک نمیگنجند. برای دادههای پویا مانند لاگهای API یا لاگهای اجرای جریان کاری که برای دیباگ استفاده میشوند، تیم یک دستور CLI اختصاصی knock را در محیط Bash ادغام کرد که در نمونه just-bash ثبت شده است. این بدان معناست که عامل میتواند دستور knock api_logs list یا knock messages list را اجرا کند تا صفحهای از لاگهای محدوده (Scoped logs) را در لحظه دریافت کند.

از آنجا که این CLI برای هر منبع یک دستور --help ارائه میدهد، عامل میتواند با کمترین هدایت و به کمک یک مهارت دیباگینگ خاص که در سیستمفایل قرار دارد، یاد بگیرد چگونه با CLI کار کند. این قابلیت به عامل اجازه میدهد تا با کوئری گرفتن از لاگهای زنده API، تسکهای دیباگینگ پیچیده را انجام دهد.
نظارت و ارزیابی
برای حفظ کیفیت در محیط عملیاتی، حلقهٔ عامل یک لاگ رویداد کامل شامل پرامپت، اقدامات انجام شده و پاسخهای ارسال شده تولید میکند. این لاگ در حافظه بافر شده و به صورت نامتقارن در یک ذخیرهگاه Postgres نوشته میشود، سپس برای نوبتهای بعدی فشرده و قالببندی میشود تا بستر حفظ گردد. لاگ نهایی از طریق یک استریم NDJSON به کلاینتهای متصل ارسال میشود.
برای مانیتورینگ و ردیابی عمیقتر، تیم از ابزارهای زیر استفاده میکند:
- OpenTelemetry: حلقهٔ عامل ردپاهایی (Traces) را در این فرمت استاندارد ارسال میکند.
- Honeycomb: ابزار اصلی برای نظارت بر ردپاهای سرویس است.
- Braintrust: برای تحلیل عمیق جلسات خاص عامل استفاده میشود.
در بخش ارزیابیها (Evals)، Knock سیستمی بومی بر اساس تحقیقات Anthropic با عنوان «دمستیکی کردن ارزیابیها برای عاملهای هوش مصنوعی» ساخت. فرآیند ارزیابی آنها شامل موارد زیر است:
- سنجش مسیر (Trajectory Measurement): بررسی مسیری که عامل برای رسیدن به یک نتیجه طی کرده است.
- تأیید نتیجه (Outcome Verification): اطمینان از اینکه نتیجه دارای یک یا چند ویژگی مورد انتظار یا یک شکل (Shape) خاص است.
- LLM-as-Judge: استفاده از یک مدل زبانی بزرگ برای امتیازدهی به خروجی نهایی.
آنها این ارزیابیها را هر شب اجرا میکنند و بر اساس معیار pass^k اندازهگیری میکنند تا دقت عامل در رایجترین وظایف مشتریان تضمین شود.
چشمانداز آینده
این تغییر معماری ثابت کرد که برای دامنههای پیچیده سازمانی، رویکرد «اول-سیستمفایل» مقیاسپذیری بیشتری نسبت به رویکرد «اول-ابزار» دارد. با این حال، تیم به تکرار و بهبود این بنیاد ادامه میدهد. اهداف آینده عبارتند از:
- فشردهسازی بهتر (Better Compaction): اصلاح منطق خلاصهسازی جلسات برای جایگزینی مکانیسمهای ساده فعلی، تا عامل بتواند تسکهای طولانیمدت را بدون رسیدن به محدودیت توکنها مدیریت کند.
- گسترش ارزیابیها: افزایش breadth و عمق موارد تست، بهویژه برای سناریوهای پیچیدهتر ساخت و ویرایش جریانهای کاری.
- عاملهای فرعی (Sub-agents): ارزیابی اینکه چگونه عاملهای تخصصی فرعی میتوانند تسکهای مجزایی مانند جمعآوری بستر، تحلیل و سایر کارهای متمرکز را بر عهده بگیرند و بار را از روی حلقه اصلی عامل بردارند.
با جداسازی «مغز» (LLM) از «دستها» (مفسر Bash)، تیم میتواند قابلیتهای عامل را افزایش دهد در حالی که پنجره زمینه را پاک و اجرا را پیشبینیپذیر نگه دارد. عامل مبتنی بر سیستمفایل، زیربنای محکمی برای تکرار قابلیتها در API، Slack و سرور MCP فراهم میکند.
گام بعدی شما
- اگر در حال توسعه عاملهای پیچیده هستید، بررسی کنید که آیا میتوانید تعاملات API را به یک لایه انتزاعی (مانند فایل یا دیتابیس موقت) تبدیل کنید تا فشار روی پنجره متنی کاهش یابد.
- ساختار «مهارتهای بارگذاریشدنی» (Skills) را برای آموزش لحظهای مدل در تسکهای دامنه-محور بررسی کنید.
- برای ارزیابی عاملها، به جای اکتفا به پاسخ نهایی، مسیر رسیدن به پاسخ (Trajectory) را مانیتور کنید.
اما این تنها بخشی از معماری است؛ نحوه مدیریت حافظه در سطح لایههای پایینتر را در تحلیل ما دربارهی KV Cache بررسی کنید.



گفتگو