تصور کنید حافظه هوش مصنوعی شما شبیه به یک مدار سختافزاری است که تمام قطعاتش با لحیم به هم چسبیدهاند؛ برای تغییر کوچکترین جزئیات در نحوه یادآوری اطلاعات، باید کل برد را دوباره لحیم کنید. با انتشار نسخه ۴.۹.۰ LangBot در ۲۶ اوت ۲۰۲۶ با نام رمز «دانش بدون مرز» (Knowledge Without Borders)، این محدودیت بهطور کامل از بین رفت. در این بهروزرسانی، LangBot قابلیتهای RAG را از هسته سیستم جدا کرده و آنها را به پلاگینهای مستقل سپرده است.
برای اکثر توسعهدهندگان، ساخت یک سیستم تولید بازیابیافزا (RAG) — شبیه به دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — همواره یک موازنه بین سهولت استفاده و کنترل بوده است. شما یا باید از ابزارهای داخلی استفاده میکردید که شما را به یک پایگاهداده برداری خاص زنجیر میکردند، یا یک پشته سفارشی میساختید که هزینهی نگهداری بسیار بالایی داشت. این تلاش برای بهینهسازی بازیابی اطلاعات، در راستای رویکردهای جدیدتری مانند استفاده از گرافهای دانش برای رفع نقاط کور هوش مصنوعی در تحلیل کدها است که دقت پاسخها را افزایش میدهد.
مشکل رویکرد قدیمی
نسخههای قبلی LangBot از این گسستگی رنج میبردند. پیش از نسخه ۴.۹.۰، پایگاه دانش به دو سیستم مجزا تقسیم شده بود:
- پایگاه دانش داخلی: این سیستم از Chroma به عنوان پایگاهداده برداری استفاده میکرد. مدلهای Embedding مستقیماً توسط LangBot مدیریت میشدند و تمام فرآیندهای تجزیه اسناد، تکهبندی (Chunking) و ایندکسگذاری بهصورت سختافزاری (Hardcoded) تعریف شده بودند.
- پایگاه دانش خارجی: این بخش از طریق مؤلفه پلاگین
KnowledgeRetrieverبه سرویسهایی مانند Dify، RAGFlow و FastGPT متصل میشد. با این حال، این سیستم فقط قابلیت «بازیابی» داشت و هیچ پشتیبانی از «وارد کردن اسناد» (Ingestion) نمیکرد.
این دو سیستم در تبهای مختلف رابط کاربری (UI) با مدلهای دادهای و جریانهای مدیریتی کاملاً متفاوت قرار داشتند. این موضوع باعث ایجاد یک منحنی یادگیری تند و هزینههای نگهداری بالا شده بود. به دلیل سختافزاری بودن منطق سیستم، تغییر پایگاهداده برداری یا استفاده از یک استراتژی تکهبندی سفارشی تقریباً غیرممکن بود، مگر اینکه کد هسته تغییر میکرد. در واقع، هر بهبود در RAG مستلزم یک انتشار کامل و جدید از کل LangBot بود.
معماری جدید پلاگینها
نسخه ۴.۹.۰ این تفکیک را با یک مدل یکپارچه جایگزین کرده است. دیگر تمایزی بین سیستم داخلی و خارجی وجود ندارد. تمام پایگاههای دانش اکنون از طریق یک رابط واحد مدیریت میشوند و تنها با یک شناسه rag_engine_plugin_id از هم متمایز میگردند. اکنون شما با یک لیست واحد و یک جریان ایجاد یکسان روبرو هستید و صرفاً موتور مورد نظر خود را انتخاب میکنید.
هسته این تغییر، مؤلفه KnowledgeEngine است که جایگزین KnowledgeRetriever منسوخ شده و مالکیت کامل چرخه حیات پایگاه دانش را بر عهده میگیرد.
بر اساس اعلام تیم توسعه، این مؤلفه چهار عملیات حیاتی را مدیریت میکند:
- وارد کردن سند (Document Ingestion): مدیریت کامل مسیر از تجزیه فایلهای خام تا ایندکسگذاری برداری.
- بازیابی دانش (Knowledge Retrieval): بازگرداندن تکههای متنی مرتبط در زمان پرسوجو.
- حذف سند (Document Deletion): پاکسازی اسناد و دادههای برداری مرتبط با آنها.
- قلابهای چرخه حیات (Lifecycle Hooks): ارائه کالبکها (Callbacks) هنگام ایجاد یا حذف پایگاههای دانش.
جداسازی تجزیهکننده (Parser)
فرآیند تجزیه (Parsing) نیز به یک نوع پلاگین مجزا استخراج شده است. یک پلاگین Parser فایلهای باینری — مانند PDF، اسناد Word یا Markdown — را پیش از آنکه به موتور RAG برسند، به متن ساختاریافته تبدیل میکند.
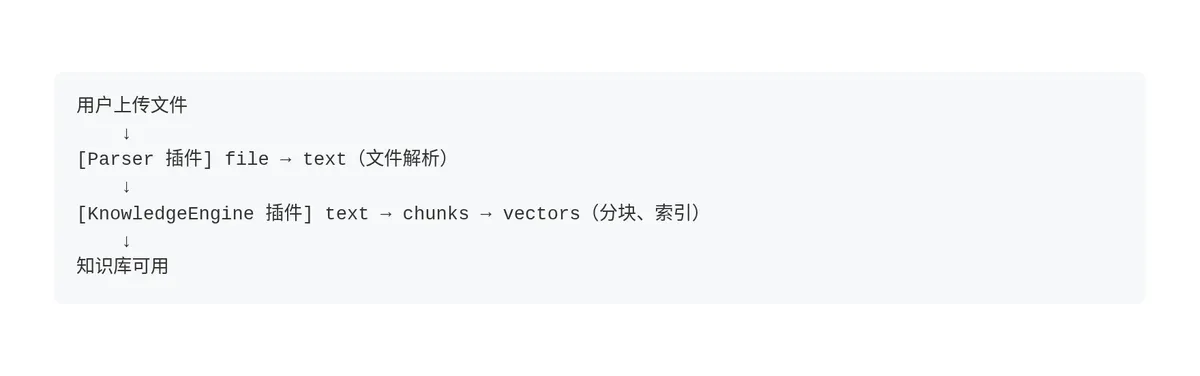
اگر یک موتور RAG قابلیت DOC_PARSING را اعلام کند، میتواند تجزیه را بهصورت داخلی انجام دهد و از پارسر خارجی صرفنظر کند. در غیر این صورت، جریان داده از پارسر به موتور RAG منتقل میشود تا تکهبندی و ایندکسگذاری انجام شود. این رویکرد به تبدیل دادههای متنوع شباهت دارد، مشابه آنچه در سازوکار mcp-retrieval برای تبدیل دادههای وب به فرمت Markdown برای تسهیل دسترسی LLMها مشاهده میکنیم. این یعنی شما میتوانید منطق تجزیه PDFهای خود را بهروز کنید بدون اینکه نیاز باشد استراتژی بازیابی را تغییر دهید.
API میزبان RAG
برای جلوگیری از حجیم شدن پلاگینها، هسته LangBot دیگر عملیات RAG را مستقیماً اجرا نمیکند. در عوض، زیرساختهای ضروری را از طریق RAGRuntimeService فراهم میکند که پلاگینها از طریق RPC به آن دسترسی دارند. این ساختار به پلاگینها اجازه میدهد تا فقط روی استراتژی (مانند الگوریتمهای بازرتبهبندی یا تکهبندی) تمرکز کنند، در حالی که میزبان کارهای سنگین را بر عهده میگیرد:
invoke_embedding(): پلاگینها نیازی به مدیریت اتصالات مدل ندارند؛ میزبان فراخوانی Embedding را مدیریت میکند.vector_upsert()/vector_search()/vector_delete(): این متدها عملیات واقعی پایگاهداده برداری را انجام میدهند.get_knowledge_file_stream(): این قابلیت به پلاگینها اجازه میدهد فایلهای خام را مستقیماً از حافظه ذخیرهسازی بخوانند.
ساخت موتورهای سفارشی
توسعهدهندگان اکنون میتوانند با دستور lbp comp KnowledgeEngine یک موتور جدید بسازند. سیستم از مانیفستهای YAML برای تعریف دو طرح پیکربندی (Schema) خاص استفاده میکند که LangBot از آنها برای رندر کردن پویا فرمهای UI استفاده میکند:
۱. creation_schema: پارامترهایی که هنگام ایجاد پر میشوند، مانند chunk_size (پیشفرض ۵۰۰) و chunk_overlap (پیشفرض ۵۰).
۲. retrieval_schema: پارامترهایی که در زمان بازیابی قابل تنظیم هستند، مانند score_threshold (پیشفرض ۰.۵) و top-K.
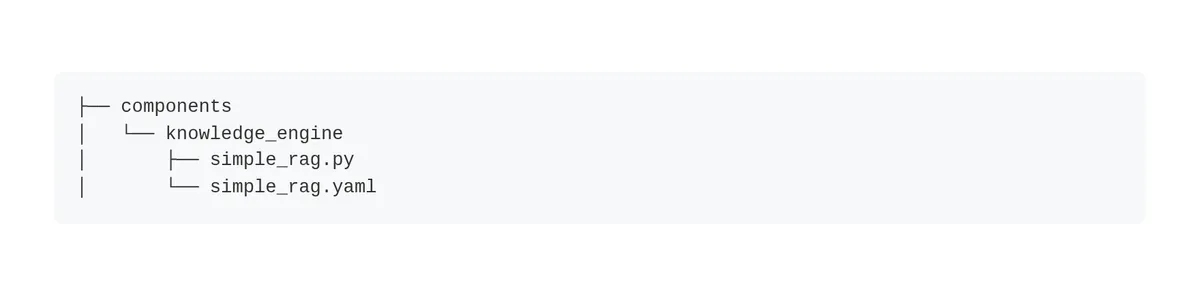
پلاگینها همچنین باید قابلیتهای خود را اعلام کنند. برای مثال، یک پلاگین میتواند KnowledgeEngineCapability.DOC_INGESTION را برگرداند تا تب «اسناد» در UI فعال شود، و اگر از تجزیه داخلی پشتیبانی میکند، KnowledgeEngineCapability.DOC_PARSING را اعلام کند.
برای کسانی که سرویسهای خارجی مانند RAGFlow، Dify یا FastGPT را متصل میکنند، فرآیند حتی سادهتر است. با حذف قابلیت DOC_INGESTION و تنها پیادهسازی متد retrieve، پلاگین به LangBot میگوید که مدیریت اسناد در خارج از سیستم انجام میشود. در این حالت، تب «اسناد» بهطور کامل از رابط کاربری حذف میشود، زیرا تمام مدیریت محتوا در سرویس خارجی صورت میگیرد.
ساخت پلاگینهای پارسر
توسعه پارسرها بسیار مختصر است و با دستور lbp comp Parser آغاز میشود. توسعهدهندگان انواع MIME پشتیبانیشده را در مانیفست تعریف میکنند (مثلاً application/pdf یا application/vnd.openxmlformats-officedocument.wordprocessingml.document). سپس متد parse بایتهای خام فایل را به یک ParseResult تبدیل میکند که شامل متن ساختاریافته و اشیاء TextSection (شامل عناوین و شماره صفحات) است.
پارسرها همچنین از فراخوانی متقاطع (Cross-plugin invocation) پشتیبانی میکنند. یک پلاگین موتور RAG میتواند پارسرِ یک پلاگین دیگر را با استفاده از self.plugin.invoke_parser() فراخوانی کند و نام نویسنده، نام پلاگین و متادیتای فایل را به آن ارسال نماید.
ارتقا و مهاجرت
پایگاههای دانش ایجاد شده در نسخههای قبلی بهطور خودکار منتقل میشوند. پس از بهروزرسانی به نسخه ۴.۹.۰، کاربران باید به صفحه پایگاه دانش مراجعه کنند تا صحت دادههای خود را تأیید نمایند. به دلیل منسوخ شدن مؤلفه KnowledgeRetriever تمام پلاگینهای پایگاه دانش خارجی موجود باید به API جدید KnowledgeEngine مهاجرت کنند.
این چرخش معماری به این معناست که هرگونه بهبود در RAG — خواه یک الگوریتم تکهبندی جدید باشد یا یک ذخیرهساز برداری تخصصی — دیگر نیازی به انتشار نسخه جدید هسته LangBot ندارد و تنها با یک بهروزرسانی ساده پلاگین امکانپذیر است.
از منظر فنی، این تغییر LangBot را از یک «پلتفرم دارای ویژگی» به یک «هماهنگکننده قابلیتها» تبدیل میکند. با تبدیل دانش به یک سرویس قابل تعویض، وابستگی به ارائهدهنده (Vendor Lock-in) که معمولاً با چارچوبهای AI یکپارچه همراه است، از بین میرود. این امر بار نوآوری را از دوش نگهدارندگان هسته به جامعه پلاگینها منتقل میکند. این تحول در مدیریت حافظه و دانش، در کنار تلاشهایی مانند EverMind و Letta برای پایان دادن به فراموشی عاملهای هوش مصنوعی، گامی بلند به سوی سیستمهای هوشمند پایدارتر است.
برای کاربر نهایی، این به معنای جایگزینی یک تجربه کاربری (UX) تکهتکه با یک جریان واحد و سازگار است. شما صرفاً موتور خود را از بازارچه انتخاب میکنید و رابط کاربری بهطور پویا فیلدهای پیکربندی صحیح را بر اساس طرح (Schema) آن موتور رندر میکند.
برای شروع، توسعهدهندگان باید هرگونه پلاگین موجود را به API جدید KnowledgeEngine منتقل کنند. راهنمای توسعه بهروز شده و موتورهای موجود در بازارچه پلاگینهای LangBot در دسترس هستند.
گام بعدی شما
- اگر پلاگین RAG دارید، سریعاً آن را به API جدید
KnowledgeEngineمنتقل کنید. - در بازارچه پلاگینهای LangBot به دنبال موتورهای جدید برای بهینهسازی هزینه استنتاج باشید.
- استراتژی تکهبندی (Chunking) خود را با استفاده از
creation_schemaشخصیسازی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو