اگر امروز یک عامل هوش مصنوعی را برای مدیریت تراکنشهای مالی یا بهروزرسانی CRM شرکتتان به کار بگیرید، احتمالاً با توهمات خطرناک یا رفتارهای غیرقابلپیشبینی مواجه خواهید شد. تفاوت میان یک دمو جذاب و یک محصول صنعتی، در جایگزینی «امید به هوشمندی مدل» با «مهندسی سختگیرانه جریان کار» است.
به نقل از راهنمای معماری منتشر شده در dev.to در تاریخ ۴ سپتامبر ۲۰۲۶، سیستمهای عاملمحور (Agentic) برخلاف چتباتهای ساده که صرفاً متن تولید میکنند، به عنوان یک لایه استدلالی عمل میکنند که منطق کسبوکار و ابزارهای خارجی را برای تکمیل گردشهای کاری چندمرحلهای سازماندهی میکند. این تغییر رویکرد به سمت سیستمهایی که قادر به بهروزرسانی CRMها یا اجرای تراکنشهای مالی هستند، در این راهنمای معماری به تفصیل شرح داده شده است. همانطور که در تحلیل قبلی ما دربارهی مدلهای قیمتگذاری Oxlo.ai برای تثبیت هزینههای خط لوله اشاره کردیم، تمرکز صنعت اکنون از «توانایی مدل» به «پایداری ساختاری» خودِ عامل تغییر کرده است. یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در حالت عادی فقط حرف میزند؛ اما یک عامل، همان کتابدار است که حالا به کامپیوتر، دفترچه راهنمای شرکت و مجموعهای از کلیدهای تاییدشده برای ورود به بخشهای مختلف دفتر دسترسی دارد.
درک چرخش به سمت سیستمهای عاملمحور
یک برنامه ساده مبتنی بر LLM مسیری خطی دارد: کاربر $
ightarrow$ مدل $
ightarrow$ پاسخ. اما در یک برنامه عاملمحور، یک حلقه استدلالی پیچیده شکل میگیرد: کاربر $
ightarrow$ عامل $
ightarrow$ استدلال $
ightarrow$ بازیابی دانش $
ightarrow$ ابزار/API $
ightarrow$ سیستم کسبوکار $
ightarrow$ پاسخ.
این ساختار اجازه میدهد سیستم از تولید متن فراتر رفته و اقدامات واقعی انجام دهد. بسته به طراحی، یک عامل میتواند درخواستهای پیچیده را بفهمد، پایگاههای داده را جستوجو کند، گردشهای کاری چندمرحلهای را اجرا کند، خروجیهای ساختاریافته تولید کند و در صورت رسیدن به محدودیت استدلالی، موضوع را به اپراتور انسانی ارجاع دهد.
معماری ششلایه برای پایداری
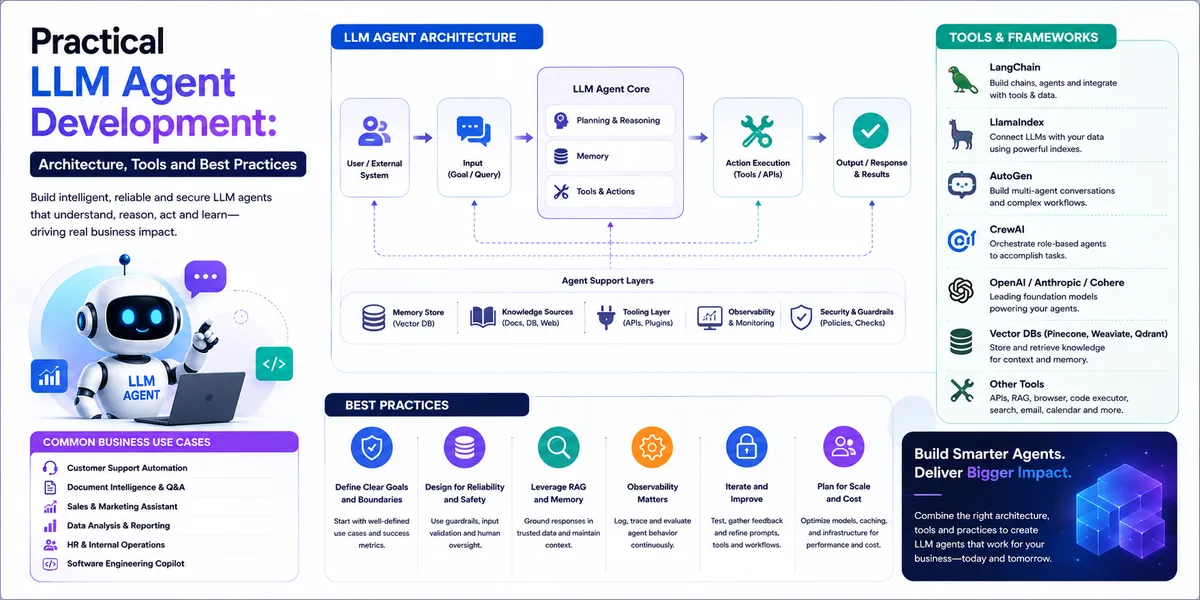
بر اساس گزارش dev.to، یک عامل قابلاتکا باید مسئولیتها را در شش لایه مجزا توزیع کند تا قابلیت نگهداری داشته باشد:
- لایه اپلیکیشن: رابط کاربری که تعاملات در آن رخ میدهد. این لایه شامل اپلیکیشنهای وب و موبایل، داشبوردهای داخلی، رابطهای پشتیبانی مشتری، پلتفرمهای پیامرسان و نرمافزارهای یکپارچه کسبوکار است.
- لایه ارکستراسیون عامل: «مغز» سیستم که پردازش درخواست را کنترل میکند. این لایه تعیین میکند کدام دستورالعملها اعمال شوند، آیا نیاز به بازیابی دانش است، کدام ابزار فراخوانی شود، چه زمانی مراحل اضافی لازم است و چه زمانی باید پاسخ داده شود یا موضوع به انسان ارجاع یابد.
- لایه LLM: موتور استدلال که درک زبان طبیعی، انتخاب ابزار و تولید خروجیهای ساختاریافته را بر عهده دارد. این راهنما اشاره میکند که توسعهدهندگان باید مدلها را بر اساس نیازهای خاص هر وظیفه انتخاب کنند، نه اینکه صرفاً بزرگترین مدل موجود را برگزینند.
- لایه دانش: از تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — برای تامین دادههای خصوصی استفاده میکند. این لایه عامل را به مستندات، FAQها، اطلاعات محصول، سیاستهای داخلی و پایگاههای دانش شرکت متصل میکند.
- لایه ابزار و یکپارچهسازی: توابع کنترلشدهای که تعامل با سیستمهای خارجی را ممکن میسازند. این لایه شامل APIهای CRM، سیستمهای ERP، ایمیل، تقویمها، موتورهای جستوجو، سیستمهای پرداخت و پلتفرمهای اتوماسیون جریان کار است.
- لایه امنیت و مشاهدهپذیری: زیرساخت حیاتی برای احراز هویت، مجوزدهی، کنترل دسترسیها، ثبت وقایع (Logging)، مانیتورینگ، ردیابی (Tracing) و مدیریت خطاها.
پیادهسازی RAG و فراخوانی ابزارها
تولید بازیابیافزا (RAG) مشکل «دانش قدیمی» مدلهای پیشآموزشدیده را حل میکند. با بازیابی مستندات مرتبط پیش از تولید پاسخ توسط LLM، عاملها میتوانند اطلاعات متغیر کسبوکار را مدیریت کنند. برای عاملهای سازمانی، RAG برای مدیریت دفترچههای راهنمای فنی، مستندات کارکنان و دانش پشتیبانی مشتری ضروری است.
با این حال، این راهنما هشدار میدهد که ساختار ضعیف مستندات یا دادههای قدیمی، مستقیماً کیفیت خروجی نهایی را کاهش میدهد. جریان کار در اینجا یک مسیر سختگیرانه را دنبال میکند: پرسوجوی کاربر $
ightarrow$ جستوجو/بازیابی $
ightarrow$ مستندات مرتبط $
ightarrow$ مدل LLM $
ightarrow$ پاسخ.
فراخوانی تابع (Function Calling) نقطهای است که عامل از «حرف زدن» به «عمل کردن» میرسد. توسعهدهندگان نباید اجازه دهند LLM بهصورت خودمختار عمل کند، بلکه باید توابع خاص و تاییدشدهای را در اختیار آن قرار دهند. مثالهایی از این توابع عبارتند از:
get_customer()create_support_ticket()check_inventory()schedule_meeting()update_crm()
این رویکرد مانع از خارج شدن عامل از کنترل میشود. برای مثال، یک عامل نباید دسترسی نامحدود به دیتابیس داشته باشد، بلکه باید از تابع خاص check_inventory() با ورودیهای اعتبارسنجی شده استفاده کند. توسعهدهندگان باید تنها توابعی را ارائه دهند که برای آن جریان کار خاص ضروری هستند.
حافظه و قابلیت اطمینان جریان کار
مدیریت حافظه موازنهای میان «بستر متن» (Context) و «هزینه» است. یک معماری کاربردی دقیقاً تعریف میکند چه اطلاعاتی باید باقی بمانند — مانند بستر گفتگوی فعلی، تعاملات قبلی کاربر، ترجیحات مشتری، وضعیت جریان کار و اطلاعات تاریخی مرتبط — و چه زمانی برای کاهش تأخیر (Latency) باید حذف شوند.
پایداری زمانی حاصل میشود که با عامل مانند یک توالی کنترلشده برخورد شود: درخواست $
ightarrow$ اعتبارسنجی $
ightarrow$ بازیابی $
ightarrow$ استدلال $
ightarrow$ فراخوانی ابزار $
ightarrow$ تایید $
ightarrow$ پاسخ. این زنجیره مانع از آن میشود که سیستم در صورت قطع شدن یک API، نبود اطلاعات لازم یا تولید خروجی نامعتبر توسط مدل، به اشتباه به مسیر خود ادامه دهد.
امنیت و نردههای ایمنی
امنیت باید در تار و پود معماری باشد. این راهنما بر «حداقل دسترسی» (Least-Privilege) تاکید میکند؛ یعنی عامل فقط به حداقل دسترسی لازم برای وظیفهاش دسترسی داشته باشد. کنترلهای کلیدی عبارتند از:
- کنترل دسترسی مبتنی بر نقش (RBAC) و مدیریت امن اعتبارنامهها.
- اعتبارسنجی ورودیها و خروجیها.
- محدودیت نرخ API (Rate Limits) و ثبت دقیق تغییرات (Audit Logging).
- تایید انسانی برای عملیاتهای حساس با تاثیر بالا.
همچنین باید در برابر ریسکهای تزریق پرامپت (Prompt Injection) — بهویژه هنگام بازیابی محتوای خارجی نامعتبر — حفاظ ایجاد کرد. عملیاتهای پرریسک، مانند انتقال وجه مالی، برای حفظ ایمنی باید حتماً نیازمند تایید انسانی باشند.
مدیریت خطا و استراتژیهای جایگزین
از آنجا که سیستمهای LLM احتمالی (Probabilistic) هستند، به استراتژیهای جایگزین (Fallback) صریح نیاز دارند. یک عامل صنعتی باید مسیری داشته باشد که در صورت شکست یک ابزار، یک بررسی اعتبارسنجی را فعال کند؛ اگر این بررسی شکست خورد، سیستم بهجای ادامه کورکورانه، به یک راهکار جایگزین یا ارجاع انسانی منتقل شود.
استراتژیهای مفید شامل موارد زیر است:
- تلاش مجدد (Retry) برای فراخوانیها با محدودیتهای تعیینشده.
- استفاده از ابزارهای جایگزین برای انجام همان وظیفه.
- ارائه پاسخهای پیشفرض ایمن.
- تولید پیامهای خطای ساختاریافته.
- ثبت اجراهای شکستخورده برای عیبیابی (Debugging).
ارزیابی و مشاهدهپذیری
تستهای نرمافزاری سنتی برای هوش مصنوعی احتمالی کافی نیستند. چارچوب dev.to پیشنهاد میکند مجموعهای از دادههای آزمون شامل درخواستهای نماینده کاربران و نتایج مورد انتظار ایجاد شود تا با هر تغییر در مدل، پرامپتها، ابزارها یا تنظیمات RAG، سیستم ارزیابی شود.
معیارهای کلیدی عبارتند از:
- نرخ تکمیل وظیفه و دقت پاسخها.
- دقت در انتخاب ابزار (آیا عامل تابع درست را فراخوانی کرد؟).
- کیفیت بازیابی و میزان تأخیر.
- هزینه به ازای هر وظیفه و نرخ شکست.
- نرخ ارجاع به انسان.
مشاهدهپذیری نیازمند «ردیابی» (Tracing) است. چون عاملها مراحل متعددی را طی میکنند، ثبت تنها پاسخ نهایی بیفایده است. توسعهدهندگان باید ببینند کدام مدل پاسخ را تولید کرده، کدام ابزارها فراخوانی شدهاند، چه بازیابیهایی رخ داده و دقیقاً کجا شکست اتفاق افتاده است تا بتوانند هزینه و عملکرد را بهینه کنند.
کاربردهای تجاری و سطح خودمختاری
نقشهای مختلف کسبوکار، سطوح متفاوتی از خودمختاری را میطلبند. یک سیستم کاربردی به عامل تنها میزان خودمختاری لازم برای وظیفهاش را میدهد. برای مثال، پاسخ به FAQهای محصول ریسک پایینی دارد (خودکار)، آمادهسازی بهروزرسانی CRM ریسک متوسط (نیاز به بازبینی) و اجرای یک تراکنش مالی ریسک بالایی دارد (نیاز به تایید).
- عاملهای فروش: ارزیابی لیدها، خلاصهسازی تعاملات مشتری، بازیابی اطلاعات CRM و آمادهسازی پیگیریها.
- عاملهای HR: کمک به کارکنان برای یافتن سیاستها، پشتیبانی از فرآیند Onboarding و مدیریت درخواستهای روتین داخلی.
- عاملهای مالی: کمک در پردازش مستندات، گزارشدهی، بازیابی اطلاعات و جریانهای کاری تایید.
- عاملهای IT: کمک در عیبیابی، بازیابی دانش، ایجاد تیکت و پشتیبانی فنی روتین.
- عاملهای پشتیبانی: بازیابی دانش، پاسخ به سوالات متداول، ایجاد تیکت و مسیریابی پروندههای پیچیده.
- عاملهای عملیاتی: هماهنگی جریانهای کاری، بازیابی دادههای عملیاتی و اتوماسیون فرآیندهای تکراری.
اشتباهات رایج در پیادهسازی
این راهنما چندین اشتباه بحرانی را شناس میکند. بسیاری از تیمها پیش از تعریف یک مسئله قابلاندازهگیری، شروع به ساخت میکنند و در نهایت نمیتوانند بفهمند عامل واقعاً مفید است یا خیر. اشتباهات دیگر شامل دادن دسترسی نامحدود به ابزارها یا نادیده گرفتن کیفیت دادههای زیربنایی است که منجر به نتایج غیرقابلاتکا در RAG میشود.
استفاده بیش از حد از سیستمهای چندعاملی (Multi-agent) یکی دیگر از خطاهای رایج است. اگرچه عاملهای تخصصی میتوانند کمک کنند، اما اغلب پیچیدگیهای غیرضروری ایجاد میکنند. سایر اشتباهات شامل نادیده گرفتن ارزیابی پس از یک دموی موفق و بیتوجهی به هزینههای تجمعی فراخوانیهای LLM، بازیابی و زیرساخت است.
یک جریان کار صنعتی ساده
برای جمعبندی، یک جریان کار عملیاتی به این شکل است:
درخواست کاربر $
ightarrow$ اعتبارسنجی ورودی $
ightarrow$ ارکستراتور عامل $
ightarrow$ بازیابی دانش $
ightarrow$ استدلال LLM $
ightarrow$ انتخاب ابزار $
ightarrow$ اقدام در API / سیستم کسبوکار $
ightarrow$ اعتبارسنجی خروجی $
ightarrow$ تایید انسانی (در صورت نیاز) $
ightarrow$ پاسخ نهایی $
ightarrow$ ثبت و ارزیابی.
این چرخش به سمت ارکستراسیون ساختاریافته، پیشفرضهای این حوزه را تغییر میدهد. ما از ذهنیت «جعبه جادویی» به سمت یک رویکرد مهندسی منضبط حرکت میکنیم که در آن LLM تنها یکی از اجزای یک سیستم بزرگتر و قطعی (Deterministic) است. برای توسعهدهنده، این یعنی ارزش دیگر در «پرامپت» نیست، بلکه در معماری ابزارها و کیفیت خط لوله بازیابی است.
برای پیشروی، توسعهدهندگان باید پیادهسازیهای فعلی هوش مصنوعی خود را بازبینی کنند تا ببینند کجا «خودمختاری کنترلنشده» در حال ایجاد ریسک است. گام بعدی، پیادهسازی یک لایه ردیابی برای تجسم دقیق نحوه استدلال عاملها پیش از استقرار در محیط عملیاتی است.
گام بعدی شما
- پیادهسازی یک لایه ردیابی (Tracing) برای مشاهده دقیق مسیر استدلال عاملها پیش از استقرار در محیط عملیاتی.
- بازبینی دسترسیهای ابزارهای فعلی و اعمال اصل «حداقل دسترسی» برای کاهش ریسکهای امنیتی.
- ایجاد یک مجموعه داده ارزیابی (Evaluation Set) برای سنجش دقت انتخاب ابزارها در سناریوهای مختلف.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو