
تصور کنید با صحنهای روبهرو هستید که ۱۸.۹ میلیارد مثلث دارد؛ مقیاسی که معمولاً ابزارهای استاندارد سهبعدی را کرش میکند یا نیمی از ساعت شما را میبلعد. Zeux، نگهدارنده کتابخانه meshoptimizer، بهتازگی مجموعهای از بهینهسازیها را به نمایش گذاشت که این زمان پردازش را در یک سیستم لینوکسی از ۳۰ دقیقه به کمتر از ۳ دقیقه کاهش داد.
این پیشرفت در حالی رخ میدهد که هندسههای با جزئیات بالا (High-fidelity geometry) به گلوگاه اصلی ردیابی پرتو (Raytracing) تبدیل شدهاند. NVIDIA در اوایل سال ۲۰۲۵ دموی Zorah را به عنوان یک صحنه ۱۰۰ گیگابایتی در Unreal Engine منتشر کرد، اما این دمو در ابتدا تنها در شاخه خاصی از موتور به نام NvRTX در دسترس بود. این نمایش، ترکیب ردیابی پرتوی خوشهای (Clustered Raytracing) را با خط لوله Nanite برای مدیریت سطوح جزئیات (LOD) به کار گرفت تا صحنههایی بسیار دقیق را بدون نیاز به مشهای جایگزین (Proxy meshes) رندر کند؛ مشهایی که Unreal Engine بهطور معمول برای ردیابی پرتو تولید میکند. طبق گزارشهای منتشر شده، انتشار نسخه glTF این صحنه در سپتامبر ۲۰۲۵ به عنوان بخشی از نمونه متنباز vk_lod_clusters به توسعهدهندگان مستقل اجازه داد تا خارج از اکوسیستمهای انحصاری، روی خط لولههای سلسلهمراتبی LOD آزمایش کنند.
اگر سعی کنید یک فایل glTF با حجم ۳۶ گیگابایت را در Blender باز کنید، احتمالاً در کمتر از ۱۰ دقیقه با خطای کمبود حافظه مواجه میشوید. حتی Unreal Engine هنگام وارد کردن همین فایل در کمتر از ۵ دقیقه کرش میکند. چالش اصلی تنها حجم فایل نیست، بلکه تراکم وحشتناک هندسه است: ۱.۶۴ میلیارد مثلث خام که با استفاده از نمونهسازی (Instancing) به ۱۸.۹ میلیارد مثلث تبدیل میشوند. این حجم از داده بهقدری زیاد است که حتی ۱۹۲ گیگابایت رم هم برای تمام مراحل پردازش در هر گردشکار (Workflow) کافی نیست.
همانطور که در تحلیلهای پیشین ما درباره بهینهسازیهای سطح پایین گرافیک اشاره کردیم، مدیریت حافظه در مقیاس میلیاردها مثلث، تعیینکننده پیروزی یا شکست یک موتور رندر است.
تکنولوژی: LOD خوشهای
برای درک این بهینهسازیها، باید جریان یک سیستم LOD خوشهای مثل Nanite را بشناسیم. هدف این است که یک مش عظیم از طریق ساختاری سلسلهمراتبی — شبیه به یک نمودار جهتدار بدون دور (DAG) — از خوشهها نمایش داده شود.
- تعریف خوشه: هر خوشه مجموعهای کوچک از مثلثها (معمولاً تا ۱۲۸ عدد) است که بخشی از مش را در یک سطح جزئیات خاص نمایش میدهد.
- استریم و رندر: سیستم در زمان اجرا، این خوشهها را استریم میکند تا خطای بصری به حداقل برسد. یک خوشه تنها زمانی با نسخهای سادهتر جایگزین میشود که خطای بصری زیر یک پیکسل باشد و این جابجایی توسط TAA یا فیلترهای زمانی (Temporal filters) پنهان شود.
- خط لوله: این فرآیند شامل تقسیم مش به خوشهها، ادغام خوشههای همسایه در گروهها، سادهسازی مستقل گروهها با حفظ لبههای مرزی و تکرار این مراحل بهصورت بازگشتی است تا زمانی که هیچ خوشه قابل پذیرشی باقی نماند.
جزئیات پیادهسازی
ساخت این ساختار به سه عملیات اصلی در meshoptimizer نیاز دارد:
- خوشهبندی (Clusterization): تقسیم مشها به خوشهها. نسخه ۰.۲۵ این کتابخانه دو مدل ارائه میدهد: یکی برای رسترایزیشن و مش-شیدرها (که با بستهبندی فشرده، تعداد مشلتها را به حداقل میرساند) و یکی جدیدتر برای ردیابی پرتو بر اساس کارهای RTX Mega Geometry انویدیا. نسخه ردیابی پرتو به شدت به مرزهای خوشه حساس است تا اجازه دهد درختهای micro-BVH برای هر خوشه ایجاد شوند.
- افراز (Partitioning): گروهبندی خوشهها در کنار هم.
- سادهسازی (Simplification): کاهش تعداد مثلثهای یک گروه از خوشهها به تعداد کمتری.
Zeux برای کاربردیتر کردن کد، دموی اصلی را به یک رابط تمیز تبدیل کرد که در آن ویژگیهای رأس (Vertex attributes) بهطور جداگانه منتقل میشوند. این موضوع برای صحنه Zorah حیاتی است، زیرا اکثر مشها فقط شامل موقعیت (Position) هستند و سیستم وقت خود را برای پردازش نرمالها یا ویژگیهای دیگر تلف نمیکند. این رابط جدید همچنین قابلیتهای اخیر سادهسازی، مانند «حالت سهلگیرانه» (Permissive mode) را ادغام کرده است.
دیوار حافظه
برای مدیریت صحنه Zorah، Zeux ابتدا نگاشت حافظه (Memory mapping) را از طریق cgltf پیاده کرد. این کار مانع از بارگذاری همزمان کل فایل ۳۶ گیگابایتی در رم میشود، زیرا بارگذاری سنکرون باعث ایجاد سربار حافظه عظیمی پیش از شروع پردازش میشد. او حتی یک PR اختصاصی برای cgltf ارسال کرد تا کار با این بافرهای نگاشتشده آسانتر شود.
اصلاح حیاتی دیگر، بازسازی شاخصهای (Reindexing) مشها بود. فایل glTF منبع دارای شاخصگذاری ناکارآمدی بود؛ برخی مشها برای تنها ۳۰ میلیون مثلث، ۹۰ میلیون رأس داشتند. این ناکارآمدی، سادهسازی باکیفیت را دشوار کرده و زمان پردازش را افزایش میداد، زیرا تعداد رأسها اغلب تعیینکننده حجم کار است.
با این تغییرات، برنامهای که روی لینوکس با ۱۶ رشته (Thread) اجرا شد، فرآیند را در حدود ۹ دقیقه و ۲۰ ثانیه (برای رسترایزیشن) یا ۷ دقیقه و ۱۰ ثانیه (برای ردیابی پرتو) به پایان رساند و حدود ۵۴ تا ۵۷ گیگابایت رم مصرف کرد. این یک جهش بزرگ نسبت به کد نمونه انویدیا بود که هنگام استفاده از ۱۶ رشته با کمبود حافظه مواجه میشد. در آزمایشها، آن کد تنها با ۸ رشته (--processingthreadpct 0.25) بهطور پایدار اجرا میشد، بیش از ۱۸۰ گیگابایت رم مصرف میکرد و تقریباً ۳۰ دقیقه زمان میبرد.
حل مشکل پراکندگی (Sparsity)
بررسیها با ابزار Superluminal یک گلوگاه غافلگیرکننده را فاش کرد: تابع memset. خوشهبندها از آرایههایی استفاده میکردند که با شاخص رأس مقداردهی میشدند تا از جستوجوی مداوم در ۶۴ تا ۱۲۸ رأس هنگام افزودن هر مثلث به یک مشلت جلوگیری شود. اما دستور memset(used, -1, vertex_count * sizeof(short)) تنها برای مشهای کوچک سریع است و وقتی برای زیرمجموعههای یک مش ۳۰ میلیون مثلثی تکرار شود، به یک نقطه داغ (Hotspot) تبدیل میشود.
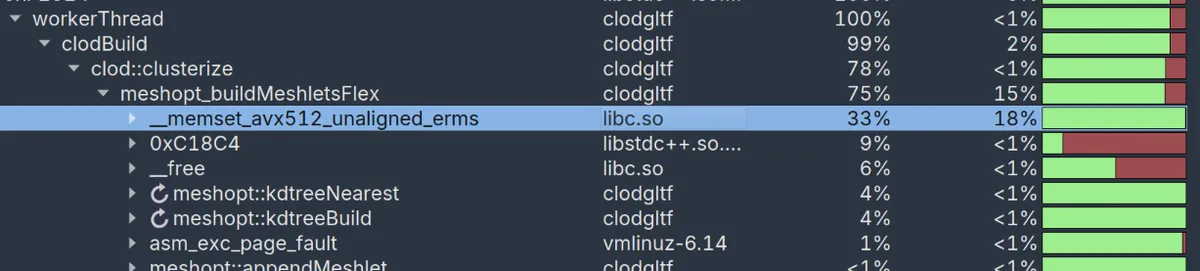
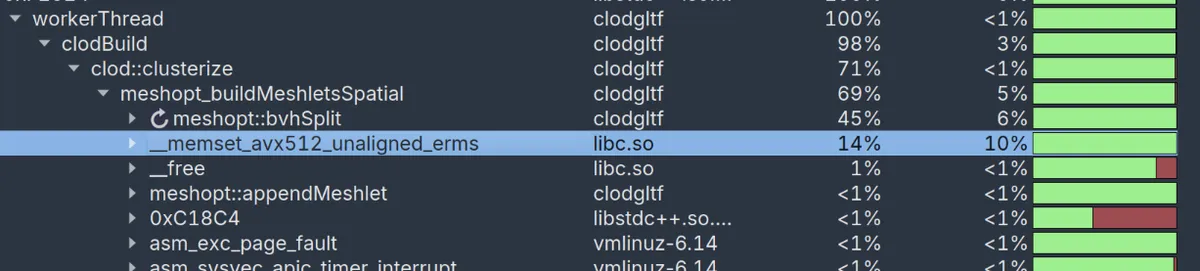
Zeux متوجه مشکل مشابهی در سادهساز (Simplifier) شد. پرچم meshopt_SimplifySparse در سال ۲۰۲۴ برای جلوگیری از کارهای O(vertex_count) اضافه شده بود، اما هنوز یک آرایه بیتی را با memset(filter, 0, (vertex_count + 7) / 8) مقداردهی میکرد. در حالی که ۱ بیت برای هر رأس ارزانتر از ۱۶ بیت است، اما وقتی تعداد مثلثها به ۱۰۰ میلیون میرسد، این مقدار قابل توجه میشود. پیش از این، بزرگترین مشهای تست شده تنها ۶ میلیون مثلث (۳ میلیون رأس) داشتند که یک مرتبه کوچکتر از Zorah بود.
او حالت «دسترسی پراکنده» (Sparse access) را معرفی کرد. اکنون بهجای پاکسازی کل آرایه، کد تنها ورودیهای خاصی را که توسط بافر شاخص استفاده میشوند مقداردهی میکند (زمانی که index_count < vertex_count تشخیص داده شود). این تغییر ساده، زمان پردازش نسخه رستر را از ۹ دقیقه به ۳ دقیقه و ۳۱ ثانیه و نسخه ردیابی پرتو را به ۳ دقیقه و ۵۷ ثانیه کاهش داد.
توازن بار محاسباتی
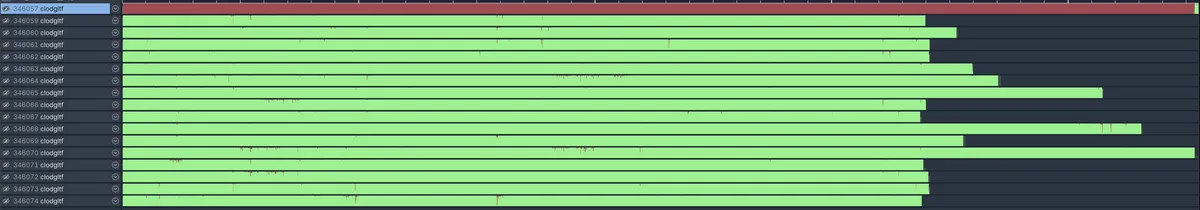
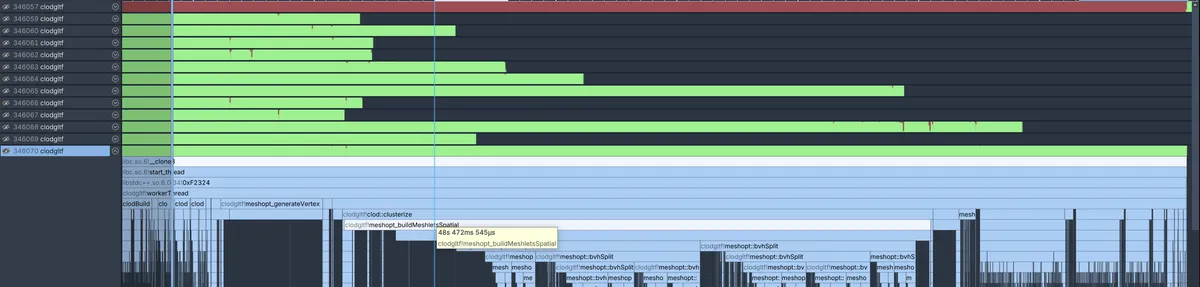
موازیسازی زمانی شکست میخورد که چند وظیفه عظیم، مسیر وظایف کوچک را مسدود کنند. در صحنه Zorah، عدم توازن شدیدی وجود دارد: چند مش دهها میلیون مثلث دارند، در حالی که اکثر آنها کوچک هستند. اگر یک مش بزرگ در آخرین صف قرار بگیرد، ۱۵ رشته بیکار میمانند تا یک رشته تنها با یک مش عظیم بجنگد. در یک مورد، یک مش بزرگ تنها برای ساخت خوشهها در اولین سطح DAG حدود ۴۸ ثانیه زمان برد.
Zeux با مرتبسازی مشها بر اساس تعداد مثلث (به صورت نزولی)، تضمین کرد که گرانترین وظایف ابتدا شروع شوند. این استراتژی «بارگذاری پیشرو»، بهرهوری CPU را در ۱۶ رشته به ۱۵۷۴٪ رساند و زمان کل را برای رسترایزیشن به ۲ دقیقه و ۵۶ ثانیه و برای ردیابی پرتو به ۳ دقیقه و ۷ ثانیه کاهش داد. جالب اینجاست که اوج مصرف حافظه برای نسخه ردیابی پرتو به حدود ۴۵ گیگابایت کاهش یافت که احتمالاً به دلیل جزئیات تخصیصدهنده سیستم (System Allocator) بود.
برای مدیریت سیستمهایی با رم محدود (مثلاً ۴۰ گیگابایت)، Zeux استفاده از یک محدودکننده (Limiter) با std::atomic یا یک سمافور شمارشی را پیشنهاد میکند تا تضمین شود تنها تعداد مشخصی از مثلثها بهطور همزمان پردازش میشوند. برای تست Zorah روی سیستم ۱۹۲ گیگابایتی، این حد روی ۶۰+ گیگابایت تنظیم شد تا از کاهش سرعت (Throttling) جلوگیری شود.
SIMD و مرتبسازی فضایی
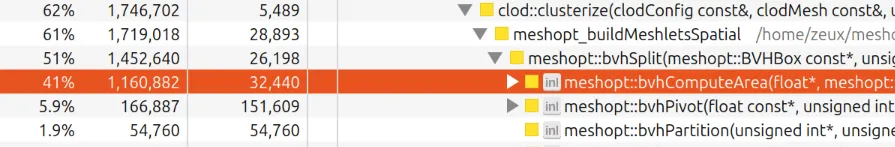
برای بهینهسازی بیشتر، Zeux تابع bvhComputeArea را هدف قرار داد. این تابع با تحلیل جعبههای محاطی (Bounding boxes)، بهترین صفحه برش را برای درخت هندسی تعیین میکند. این تابع جعبههای محاطی را شش بار (سه محور، دو جهت) تجمیع کرده و مساحت AABBهای حاصل را محاسبه میکند.
او منطق اصلی (بهویژه تابع boxMerge) را به SSE2 برای x86 و NEON برای ARM تبدیل کرد. این کار از دستورات اختصاصی MINPS/MAXPS برای تجمیع کمینه/بیشینه و عملیات shuffle برای محاسبه مساحت جعبه استفاده میکند. اگرچه سختافزار میتوانست از بردارهای عریضتر استفاده کند، اما چیدمان دادهها بازآرایی آنها را بدون تغییر مکرر ترتیب جعبهها دشوار میکرد. با این حال، این شتابدهی SIMD باعث افزایش ۹ درصدی سرعت شد و زمان را به ۲ دقیقه و ۵۱ ثانیه رساند.
برای حل محدودیتهای زیرسیستم حافظه، او یک مرتبسازی فضایی با استفاده از ترتیب مورتون (Morton order) از طریق meshopt_spatialSortTriangles اضافه کرد. در سطوح بالای بازگشت، الگوریتم جعبههای محاطی را از نقاط پراکنده حافظه فراخوانی میکند که باعث کاهش شدید بهرهوری حافظه پنهان (Cache locality) میشود. مرتبسازی فضایی مثلثها، انسجام ترتیب جعبهها در حافظه را تضمین کرد و ۵ درصد دیگر به سرعت افزود تا زمان به ۲ دقیقه و ۴۴ ثانیه برسد.
غول نهایی: تخصیص حافظه
در ویندوز، سیاست بلوکهای بزرگِ تخصیصدهنده پیشفرض باعث تداخل شدید بین رشتهها میشد. بلوکهای بزرگ از Heap عبور کرده و از VirtualAlloc استفاده میکنند که مقداردهی آن گران است. چون چندین رشته بر سر یک Mutex حافظه رقابت میکنند، توان عملیاتی بهشدت افت میکند و در نمودارهای بهرهوری، «نقاط قرمز» زمان بیکاری ایجاد میشود.
Zeux یک «آرنای هر-رشته» (Per-thread arena) پیاده کرد؛ تکهای ۱۲۸ مگابایتی از حافظه که پیشتخصیص شده و از یک Bump allocator استفاده میکند. این کار باعث شد اکثر عملیاتها از Heap جهانی عبور کنند. اگر تخصیصی بزرگتر از آرنا باشد، سیستم به malloc بازمیگردد. در هنگام آزادسازی حافظه، سیستم بررسی میکند که آیا اشارهگر متعلق به آرنای محلی رشته است یا خیر؛ در غیر این صورت به free بازمیگردد.
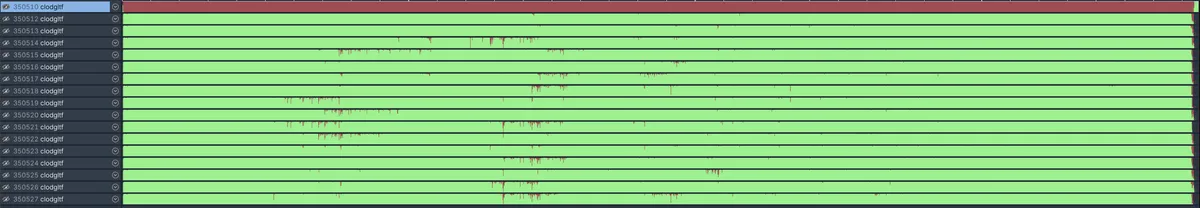
در ویندوز، این تغییر زمان اجرا را از ۴ دقیقه و ۲۰ ثانیه به ۲ دقیقه و ۳۸ ثانیه رساند و عملکرد را با لینوکس برابر کرد. در لینوکس نیز بهبودهای اندکی حاصل شد و زمان نهایی به حدود ۲ دقیقه و ۳۵ ثانیه رسید که در مجموع ۳.۵ برابر سریعتر از خط پایه اولیه است.
نتایج واقعی
این بهینهسازیها اکنون در میکرو-کتابخانه clusterlod.h در مخزن meshoptimizer در دسترس هستند. نتایج ملموس است: دارایی Zorah اکنون میتواند در ۲۶ میلیثانیه (ردیابی پرتو) یا ۱۶ میلیثانیه (رسترایزیشن) روی یک کارت گرافیک NVIDIA GeForce 3050 با استفاده از یک استخر هندسه ۲ گیگابایتی رندر شود.
حتی با احتساب سریالسازی دادهها، کل خط لوله اکنون یک فایل کش ۶۲ گیگابایتی را در حدود ۳ دقیقه و ۲۰ ثانیه تولید میکند. این زمان شامل زمانی است که لینوکس برای fopen() فایل و پاکسازی محتویات موجود از کش سیستم فایل صرف میکند (که میتواند تقریباً ۱۰ ثانیه طول بکشد). این تستها روی یک پردازنده 7950X در حالت eco mode انجام شده است.
در حالی که سیستم بسیار کارآمد است، هنوز فرصتهایی برای بهبود وجود دارد. بهروزرسانیهای آینده ممکن است شامل یک ساختار شتابدهنده سلسلهمراتبی مجزا برای تعیین سریعتر خوشههای رندر و بهبودهای در الگوریتم meshopt_partitionClusters برای ادغام تهاجمیتر خوشهها و کاهش تعداد ریشههای DAG باشد. (لازم به ذکر است که meshopt_partitionClusters مدت کوتاهی پس از انتشار برای رفع مشکل ادغام ریشهها بهروزرسانی شد).
این تحول ثابت میکند که گلوگاه هندسههای عظیم همیشه قدرت پردازش خام نیست، بلکه نحوه چیدمان دادهها در حافظه و نحوه دسترسی رشتهها به Heap است. با اولویت دادن به تخصیص حافظه و محلیسازی کش، توسعهدهندگان اکنون میتوانند هندسههای با کیفیت سینمایی را روی سختافزارهای مصرفکننده پردازش کنند.
گام بعدی شما
- اگر روی پروژههای گرافیکی با حجم داده بالا کار میکنید، کتابخانه meshoptimizer و بهویژه بخش
clusterlod.hرا برای پیادهسازی LODهای سلسلهمراتبی بررسی کنید. - برای کاهش زمان پردازش در ویندوز، از تخصیصدهندههای محلی (Thread-local allocators) بهجای Heap جهانی استفاده کنید تا تداخل رشتهها کاهش یابد.
- در مواجهه با دادههای حجیم، بهجای بارگذاری کامل در رم، از تکنیک Memory Mapping برای کاهش سربار اولیه استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell و مدیریت حافظه در نسل جدید GPUها مراجعه کنید.



گفتگو