تصور کنید هزاران ساعت جلسه ضبطشده، تماسهای پشتیبانی، جلسات آموزشی، سخنرانیهای کنفرانس و ضبطهای صفحه نمایش در فضای ذخیرهسازی شما قرار دارند. این حجم عظیم احتمالاً بزرگترین مجموعه دانش سازمان شماست، اما برای عاملهای هوش مصنوعی عملاً نامرئی است چون ساختاری برای بازیابی (Retrievable Structure) ندارد. وقتی کسی میپرسد «درباره مهاجرت تامینکننده چه تصمیمی گرفتیم؟»، پاسخ احتمالاً وجود دارد، اما در یک ضبط ۴۷ دقیقهای دفن شده است که هیچکس حاضر نیست برای یافتن آن، کل ویدیو را اسکراب کند.
مایکروسافت برای پر کردن این شکاف، قابلیت Azure Content Understanding را در حالت استاندارد Foundry IQ ادغام کرد. این یکپارچگی به توسعهدهندگان اجازه میدهد رسانههای خام را به دادههای مبنیسازی (Grounding) تبدیل کنند که عامل میتواند با دقت ثانیهبهثانیه به آن استناد کند. این سیستم، هوش مصنوعی سنتی استخراج اسناد (Document Intelligence) را با استدلال محتوایی مبتنی بر مدلهای زبانی بزرگ (LLM) ترکیب میکند تا اطلاعات حیاتی را از اسناد، صوت، تصویر و ویدیو بیرون بکشد.
با تکیه بر پوششهای قبلی ما درباره اینکه چگونه نقصهای امنیتی در یکپارچگیهای AI ظاهر میشوند — مانند باگهای «متا-هکینگ» که در Copilot یافت شدند — این بهروزرسانی بر بخش ورود دادهها (Ingestion) در خط لوله تولید بازیابیافزا (RAG) تمرکز دارد. به گزارش مایکروسافت، اکثر تیمها پیش از این به سرویسهای ساده تبدیل گفتار مثل Whisper متکی بودند که گوینده، برچسب زمانی و بستر تصویری را حذف میکردند. این «راهکار سریع» باعث میشد عامل نتواند به کاربر بگوید یک تصمیم «چه زمانی» گرفته شده یا «چه کسی» آن را گفته است، زیرا توده متنی حاصل، فاقد لنگرهای لازم برای ناوبری بود. این چالشها در واقع بخشی از پیچیدگیهای مدیریت نویز در خطلولههای تبدیل گفتار به متن است که پیشتر بررسی کرده بودیم.
دو مسیر برای ورود دادهها
توسعهدهندگان برای انتقال رسانهها به پایگاه دانش دو راه متمایز پیش رو دارند. این دو مسیر معادل یکدیگر نیستند و توسعهدهندگان باید پیش از برنامهریزی برای هر اسپرینت، بررسی کنند که کدامیک برای انواع رسانههای خاص آنها مناسب است.
مسیر الف: مسیر بومی (Native). این روش در واقع یک فلگ (Flag) روی منبع دانش است. با تنظیم ویژگی contentExtractionMode روی مقدار standard در منابع دانش ایندکسشده مبتنی بر فایل (مانند Azure Blob، SharePoint یا OneLake)، قابلیت درک محتوا مستقیماً در خط لوله ورود داده فعال میشود. این روش نیازی به کدنویسی برای ارکستراسیون ندارد و در نسخه پیشنمایش ۱ مه ۲۰۲۶ Foundry IQ عرضه شد که تمرکز آن بر استخراج غنیتر و سرویسدهی تصاویر برای بازیابی چندوجهی (Multimodal) بود.
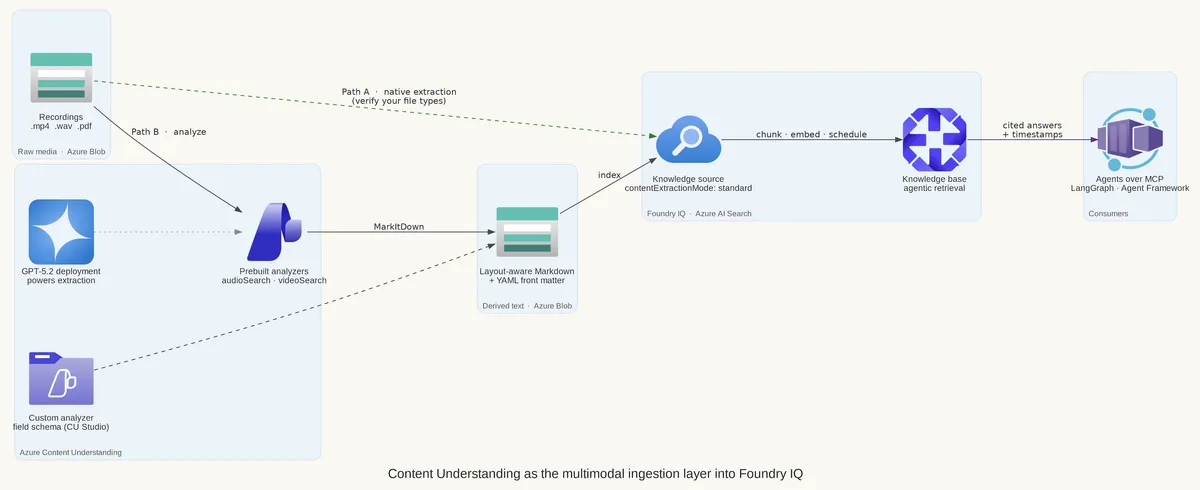
مسیر ب: مسیر صریح (Explicit). در این گردشکار، توسعهدهندگان تحلیلگرهای درک محتوا را بهصورت دستی اجرا میکنند، خروجی Markdown و فیلدهای استخراجشده را در فضای ذخیرهسازی Blob مینویسند و سپس یک منبع دانش معمولی را به آن متن متصل میکنند. اگرچه این مسیر شامل قطعات متحرک بیشتری است، اما کنترل کاملی را فراهم میکند. این روش به عنوان جایگزین (Fallback) توصیه میشود زیرا اعلانهای Foundry IQ مایکروسافت بیشتر بر درک اسناد (چیدمان، جداول، اشکال) تأکید دارند تا صوت و ویدیو. اینکه آیا یک منبع دانش Blob امروز در یک منطقه خاص یا نسخه API خاص، فایل .mp4 را میپذیرد یا خیر، باید با یک تست ۵ دقیقهای تأیید شود.
تحلیلگرهای تخصصی هر رسانه
مایکروسافت تحلیلگرهای پیشساختهای را ارائه داده است که برای انواع مختلف رسانهها بهینه شدهاند. ابزار MarkItDown بر اساس پسوند فایل، بهطور خودکار یکی از اینها را انتخاب میکند. هر تحلیلگر یک «لنگر استناد» (Citation Anchor) متفاوت تولید میکند که از توهم (Hallucination) عامل درباره منبع جلوگیری میکند:
- اسناد (
prebuilt-documentSearch): تولید Markdown با آگاهی از چیدمان (Layout-aware). این ابزار سرتیترها، جداول و توصیف اشکال را حفظ میکند. استنادها به شماره صفحه و شناسههای شکل (Figure IDs) خاص لینک میشوند. این بالغترین مسیر است که در آن سلولهای جدول در ساختار جدول خود باقی میمانند و برای قراردادها، گزارشها و فرمها ایدهآل است. - صوت (
prebuilt-audioSearch): تولید متنهای پیادهشده با مرزهای دقیق هر utterance (واحد گفتاری). این قابلیت اجازه میدهد استنادها به برچسبهای زمانی دقیق لینک شوند و شناسایی کند چه کسی و چه زمانی صحبت کرده است. بدون این ابزار، صوت به متن ساده تبدیل شده و تنها لنگری که یک ضبط را قابل ناوبری میکند، نابود میشود. این روش برای تماسهای پشتیبانی و مصاحبهها بهترین است. - ویدیو (
prebuilt-videoSearch): استخراج همزمان متن و بستر تصویری. این ابزار مرزهای صحنه و قطعات ویدیو را شناسایی میکند و استنادهایی ایجاد میکند که به فریمهای خاصی ارجاع میدهند. این تحلیلگر ثبت میکند که چه چیزی روی صفحه بوده است، نه فقط چه چیزی گفته شده است، هرچند ممکن است برخی جزئیات ریز در اسلایدهای متراکم از دست برود. این روش برای جلسات، دموها و آموزشها بهترین است.
نقش MarkItDown و GPT-5.2
برای سادهسازی این فرآیند، مایکروسافت از MarkItDown با بکاِند درک محتوا استفاده میکند. این ابزار فایلها را به Markdown با سرتیترها و جداول درونخطی تبدیل میکند؛ یعنی دقیقاً همان فرماتی که تکهبندها (Chunkers) و مدلهای بردار معنایی (Embedding) در مراحل بعدی ترجیح میدهند.
در صورت استفاده از یک تحلیلگر سفارشی، MarkItDown فیلدهای استخراجشده را بهصورت YAML Front Matter در بالای بدنه متن قرار میدهد. برای مثال، یک ضبط جلسه ممکن است شامل فیلدهایی برای MeetingTitle (عنوان جلسه)، Decision (تصمیم) و Owner (مسئول) باشد. این Front Matter به عنوان فیلتر متاداده و محموله استناد عمل میکند و یک جستوجوی کلی را به یک پاسخ دقیق تبدیل میکند: «عامل به من گفت که تصمیم به پیشروی گرفته شده و این هم برچسب زمانی آن است».
این تحلیلگرها توسط مدلهای مستقر در Foundry، از جمله GPT-5.2، قدرت گرفتهاند. این مدل استخراج فیلدهای سفارشی را بهطور قابلتوجهی بهبود بخشیده و نیاز به مهندسی پرامپت (Prompt Engineering) پیچیده در مواجهه با زبانهای تخصصی دامنه، چیدمانهای ترکیبی یا محتوای چندزبانه را کاهش داده است. برای کسانی که از خط لولههای قدیمیتر استفاده میکنند، تحلیلگرهای ساخته شده بر پایه GPT-4.1 همچنان سازگار هستند و بدون تغییر اجرا میشوند.
طراحی برای بازیابی بهینه
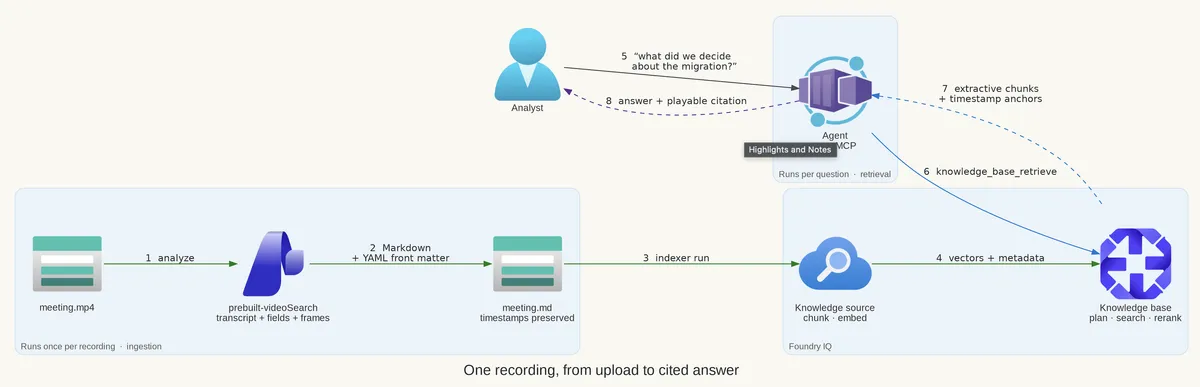
بازیابی مؤثر نیازمند یک طرحواره (Schema) خاص است که در Content Understanding Studio (و نه در پورتال Foundry) طراحی شود. چون یکپارچگی Foundry IQ با حالت استاندارد است، استخراج دقیقاً بهصورت «فایل به فایل» انجام میشود. این سیستم نمیتواند تحلیلهای متقاطع بین فایلها یا استدلالهای چندمرحلهای انجام دهد؛ این وظایف به موتور بازیابی عاملمحور (Agentic Retrieval Engine) در زمان پرسش واگذار شده است. این رویکرد در واقع پاسخی به شکافهای زنجیره تأمین دانش در سازمانها است که اغلب منجر به شکست عاملهای هوش مصنوعی میشود.
طرحواره پیشنهادی برای ضبط جلسات:
- Decision (تصمیم): متداولترین پرسش در هر مجموعه داده جلسات.
- Owner (مسئول): تبدیل بازیابی به پاسخگویی و مسئولیتپذیری.
- DueDate (تاریخ سررسید): فعالسازی فیلترهای تازگی و ضربالاجل.
- SystemsMentioned (سیستمهای ذکرشده): اجازه میدهد عامل پرسوجوها را به سرویسهای خاص (مثلاً «سرویس صورتحساب») محدود کند.
- UnresolvedQuestions (سوالات بیپاسخ): شناسایی شکافهای بحرانی که یک خلاصه معمولی احتمالاً آنها را نادیده میگیرد.
توسعهدهندگان باید در برابر استخراج فیلد «خلاصه» (Summary) مقاومت کنند. موتور بازیابی پاسخها را در زمان پرسش ترکیب و سنتز میکند؛ یک خلاصه پیشساخته، در واقع یک پارافراز ناقص است که مدل ممکن است بهجای منبع اصلی به آن استناد کند.
موفقیت عملیاتی به سه قانون سختگیرانه برای استنادها بستگی دارد:
۱. حفظ Front Matter: اگر تکهبند (Chunker) بخش YAML را به عنوان نویز در نظر بگیرد، فیلدهای استخراجشده هرگز به ایندکس نمیرسند و فیلترهای متاداده بهطور خاموش هیچ نتیجهای را پیدا نخواهند کرد.
۲. تعبیه برچسبهای زمانی در متن: برچسبهای زمانی باید داخل متن تکه (Chunk text) وجود داشته باشند، نه فقط به عنوان متادادههای جانبی. اگر آنها فقط در یک فیلد باشند، مدل چیزی برای نقلقول در پاسخ نهایی نخواهد داشت.
۳. لینکهای قطعی (Deterministic): ذخیره یک URL از Blob به همراه یک قطعه زمانی (Timestamp fragment). این کار هر استناد را به یک لینک قابل پخش تبدیل میکند و به کاربر اجازه میدهد با یک کلیک به لحظه دقیق یک تصمیم برسد.
محدودیتهای فنی و نسخهها
توسعهدهندگان باید در مورد نسخههای API محتاط باشند تا از شکست خط لولهها جلوگیری کنند. نسخه نهایی (GA) برای درک محتوا ۲۰۲۵-۱۱-۰۱ است. نسخههای پیشنمایش قبلی (۲۰۲۴-۱۲-۰۱-preview و ۲۰۲۵-۰۵-۰۱-preview) در ۱۵ ژوئیه ۲۰۲۶ بازنشسته شدند. هر کد قدیمی که این نسخهها را هدف قرار داده باشد، اکنون از کار افتاده است.
به این عدم تقارن دقت کنید: در حالی که سرویس محتوا در حالت GA است، قابلیتهای بازیابی در Foundry IQ در نسخه پیشنمایش ۲۰۲۶-۰۵-۰۱ هستند. این بدان معنای است که شما یک سرویس محتوای نهایی را در مقابل یک سرویس بازیابی پیشنمایش اجرا میکنید و انتظارات پشتیبانی باید بر این اساس برنامهریزی شود.
پیادهسازی و عیبیابی
برای پیادهسازی مسیر صریح، توسعهدهندگان باید Markdownها را در فضای ذخیرهسازی Blob بنویسند (یک فایل برای هر ضبط) در حالی که رسانههای اصلی را در یک ظرف (Container) مجزا نگه دارند. این کار از ایندکس شدن فایلهای باینری توسط منبع دانش جلوگیری کرده و تضمین میکند که رسانه اصلی برای پخش در دسترس باقی بماند.
هنگام ایجاد منبع دانش، بخش توضیحات (Description) نقش حیاتی و تعیینکنندهای دارد. موتور بازیابی عاملمحور از آن برای برنامهریزی پرسوجوها استفاده میکند. بهجای عبارت «متون جلسات»، از یک شرح مفصل استفاده کنید: «ضبطهای پیادهشده و ساختاریافته جلسات: شامل تصمیمات، مسئولین، تاریخهای سررسید و سوالات بیپاسخ، همراه با برچسبهای زمانی. برای پاسخ به سوالات درباره اینکه چه چیزی، توسط چه کسی و چه زمانی تصمیم گرفته شده است استفاده شود».
سناریوهای رایج عیبیابی:
- عدم تولید تکه (Chunk) از فایلهای رسانهای: منبع دانش نتوانسته است آن نوع فایل را بهصورت بومی جذب کند. به مسیر ب (تحلیل با CU و ایندکس Markdown) بازگردید.
- خطاهای ۴۰۴ یا نسخه: کد احتمالاً به یک API پیشنمایش بازنشسته ارجاع میدهد؛ به نسخه ۲۰۲۵-۱۱-۰۱ مهاجرت کنید.
- افت کیفیت استخراج: نمرات اطمینان (Confidence scores) و دقت بین مدلها تغییر میکند. قبل از انتقال ترافیک تولید، مجموعه ارزیابی (Eval set) خود را بهصورت موازی اجرا کنید.
- پاسخهای ضعیف به سوالات متقاطع بین فایلها: حالت استاندارد بهطور پیشفرض تکفایلی است. اجازه دهید موتور بازیابی عاملمحور استدلال را در زمان پرسش انجام دهد.
- عدم بازیابی اشکال فایلهای Office: اشکال باید با استفاده از شناسه (ID) و از طریق نقطه اتصال
/contentunderstanding/analyzerResults/{operationId}/files/figures/{figureId}فراخوانی شوند.
قابلیتهای پیشرفته و نقشه راه
فراتر از تبدیل متن ساده، نسخه پیشنمایش ۲۰۲۶-۰۵-۰۱ قابلیت سرویسدهی تصاویر (Image serving) را معرفی کرد. این قابلیت به عامل اجازه میدهد تصاویر جاسازی شده در اسناد را در زمان بازیابی نمایش دهد. برای ارائههایی که اسلایدهای زیادی دارند یا ضبطهای دمو، این تفاوت بین این است که عامل بگوید «ارائهدهنده یک نمودار را نشان داد» یا اینکه واقعاً آن فریم را برگرداند. در ترکیب با استخراج اشکال از فایلهای Office، استنادها میتوانند بهجای یک پارافراز متنی، به یک تصویر ارجاع دهند.
چندین بهروزرسانی برنامهریزی شده برای جولای ۲۰۲۶، محاسبات RAG رسانهای را تغییر میدهند:
- APIهای همگام (Synchronous): نقاط اتصال جدید برای عملیات Read و Layout.
- حالت درک عاملمحور (Agentic Understanding Mode): طراحیشده برای اسناد پیچیدهای که نیاز به استدلال عمیقتر دارند.
- اقامت دادهها و انطباق (Residency and Compliance): پردازش در مناطق دادهای (Data zone) و مناطق جهانی برای رعایت قوانین اقامت داده. نکته حیاتی این است که دادههای آموزشی برچسبدار دیگر در Content Understanding ذخیره نمیشوند، به این معنی که ورودیهای آموزشی در فضای ذخیرهسازی خود سازمان باقی میمانند.
- آموزش سفارشی: بهبود آموزش تحلیلگرهای سفارشی با استفاده از مثالهای خود سازمان.
برای مجموعههای داده با حجم بالا، بهینهترین معماری استفاده از یک لایه مسیریابی (Routing layer) است. ضبطهای کوتاه تماس میتوانند از طریق prebuilt-audioSearch ارسال شوند، جلسات اسلایدمحور برای حفظ کانال بصری از طریق prebuilt-videoSearch هدایت شوند و تحلیلگرهای سفارشی برای انواع ضبطهای خاصی که هفتگی پرسوجو میشوند، رزرو گردند. این کار هم کیفیت استخراج و هم هزینه را بهینه میکند.
این تغییر، فرض بنیادی در RAG رسانهای را دگرگون میکند. بهجای اینکه با یک ویدیو به عنوان یک فایل باینری برای تبدیل به متن برخورد شود، اکنون به عنوان یک سند ساختاریافته تلقی میشود که اتفاقاً بُعد زمانی دارد. نتیجه سیستمی است که در آن عامل فقط نمیگوید «تیم تصمیم گرفت مهاجرت کند»، بلکه لینکی به ۱۲ ثانیه دقیق از یک ضبط ۴۷ دقیقهای میدهد که در آن لحظه، آن تصمیم اتخاذ شده است.



گفتگو