تصور کنید یک عامل هوش مصنوعی برای پرداخت ۱۲۰۰ دلار هزینه سفر درخواست میدهد، اما بهجای حدس زدن یا تکرار اشتباه، دقیقاً در همان لحظه متوقف میشود تا شما دکمه تأیید را بزنید. این یعنی پایان عصر «حدس زدن» در عملیات حساس مالی و زیرساختی سازمانها.
بسیاری از سیستمهای فعلی با مشکل «قطع ارتباط» (Interruption Problem) دستوپنجه نرم میکنند، اما مایکروسافت فاندری (Microsoft Foundry) تأییدات انسانی را نه به عنوان یک ویژگی الحاقی (Bolted-on feature)، بلکه به عنوان یک وضعیت طبیعی در زنجیرههای وظایف بادوام تعریف کرده است. این رویکرد تضمین میکند که یک عامل مالی هنگام درخواست بازپرداخت ۱۲۰۰ دلاری، به جای حدس زدن یا تلاش مجدد، متوقف شده و منتظر پاسخ «بله» از سوی انسان بماند.
همانطور که در تحلیل قبلی ما دربارهی آسیبپذیریهای سرورهای MCP اشاره کردیم، تمرکز معماریهای جدید از «اتصال ساده» به «پایداری وضعیت» (Durability) تغییر کرده است. در اکثر محیطهای اجرای عاملها، باز نگه داشتن یک اتصال برای چندین روز غیرممکن است و تلاش برای شبیهسازی آن با پایگاههای داده خارجی، منجر به ایجاد کابوسی از «کدهای چسبنده» (Glue Code) میشود؛ جایی که وضعیت گفتگو و وضعیت تأیید در دو دنیای متفاوت زندگی میکنند. تطبیق دادن این دو وضعیت پس از یک کرش (Crash)، دقیقاً همان نوع کدی است که توسعهدهندگان میخواهند از آن اجتناب کنند. این چالشها یادآور نقصهای مدیریت اجرا در LoopArena است که منجر به کاهش نرخ موفقیت عاملهای کدنویس شد.
به نقل از راهنمای فنی منتشر شده در ۲۹ سپتامبر ۲۰۲۶، رویکرد فاندری گیتهای تأیید را مستقیماً در همان بستری ادغام میکند که برای بازیابی پس از خرابی (Crash Recovery) استفاده میشود. این یعنی یک عامل میتواند برای ۹۰ ثانیه یا سه هفته متوقف شود، بدون اینکه کد برنامه تغییر کند؛ زیرا وضعیت مدل در یک ذخیرهساز بادوام (Durable Store) ثبت میشود، نه در حافظه فعال (Active Memory). این قابلیت برای پذیرش هوش مصنوعی در سازمانها حیاتی است؛ جایی که سازمانها با اجازه دادن به عامل برای «تنظیم پیشنویس» یک اقدام راحت هستند، اما اجازه «اجرای بدون نظارت» آن را نمیدهند — بهویژه زمانی که موضوع مربوط به پول، زیرساخت یا ارتباطات با مشتری باشد.
مکانیسم تعلیق
این سیستم بر پایه دکوراتور @multi_turn_task عمل میکند که یک هندلر استاندارد async را به یک زنجیره گفتگوی بادوام تبدیل میکند. برخلاف وظایف تکمرحلهای (One-shot) — که ورودی میگیرند، خروجی میدهند و تمام میشوند — این وظایف پس از بازگشت (Return) خاتمه نمییابند، بلکه تحت یک شناسه مشخص (task_id) به وضعیت «تعلیق شده» (Suspended) میروند تا زمانی که نوبت جدیدی برسد یا وظیفه بهطور صریح حذف شود.
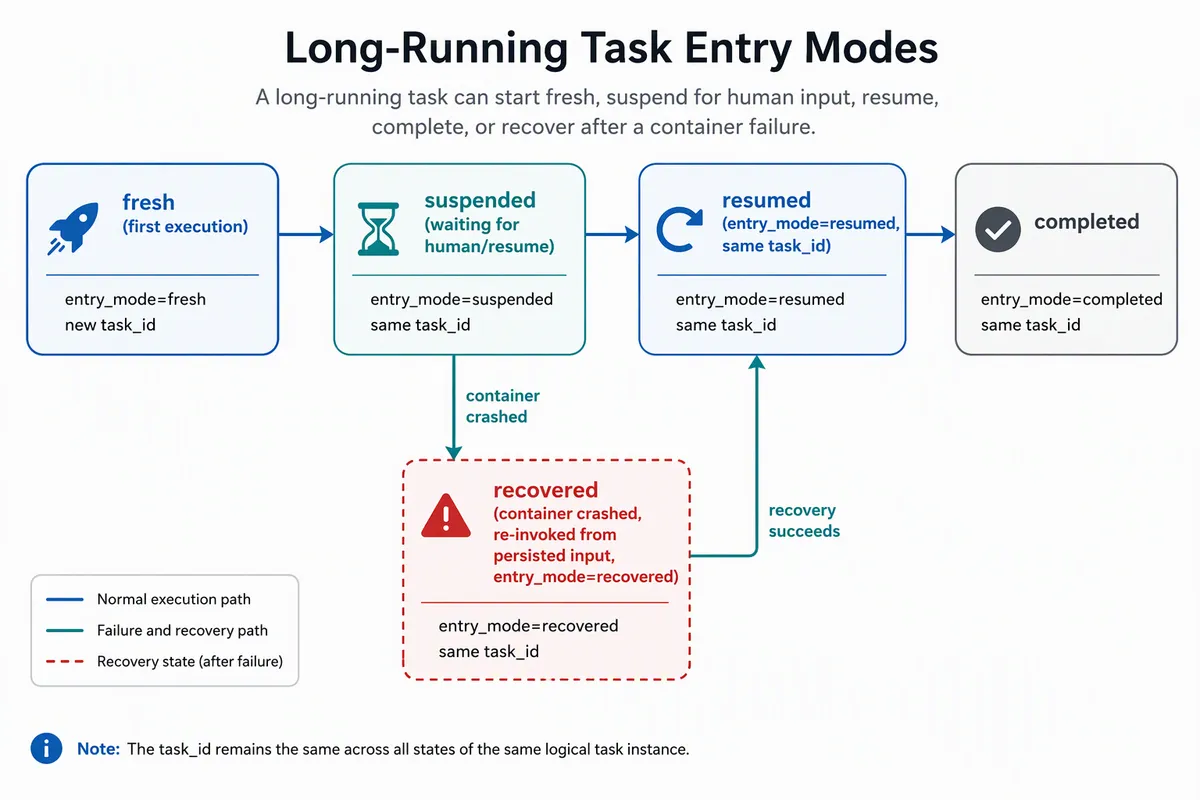
بر اساس مستندات، توسعهدهندگان این انتقالها را از طریق سه حالت ورودی متمایز در TaskContext مدیریت میکنند (این قابلیت در نسخههای azure-ai-agentserver-core ≥ 2.0.0 برای پایتون و Azure.AI.AgentServer.Core ≥ 1.0.0-beta.28 برای .NET در دسترس است):
- Fresh: نخستین اجرای یک جفت (task_id, input_id) خاص.
- Resumed: نوبتهای بعدی در یک زنجیره موجود، مثلاً زمانی که تصمیم یک انسان میرسد یا یک بررسی زمانبندی شده فعال میشود.
- Recovered: فراخوانی خودکار پس از یک خرابی زیرساختی، جایی که فریمورک از توسعهدهنده در برابر شکستی که پیش از اتمام یک نوبت Fresh یا Resumed رخ داده، محافظت میکند.
نکته کلیدی این است که task_id توسط فراخوان (Caller) انتخاب میشود، نه سرور. این به اپلیکیشن اجازه میدهد هویت را از پیش تعیین کند — مثلاً «exp-42» برای یک گزارش هزینه، یک شناسه رشته گفتگو (Thread ID)، یا یک شماره تیکت — تا تضمین شود پاسخی که روزها بعد از یک پروسه متفاوت میرسد، بتواند دقیقاً به همان زنجیره بازگردد.
مدیریت وضعیت و معماری
وقتی یک هندلر بدون ایجاد خطا بازمیگردد، مدیریتکننده وظایف (TaskManager) — که یک مؤلفه سمت سرور است و از طریق set_resilient_tasks_enabled(True) پیش از استارت هاست فعال میشود — وضعیت فعلی را در ذخیرهساز وضعیت فاندری (FoundryStateStore) مینویسد. این یک توقف ساده در حافظه نیست؛ کانتینری که نوبت اول را پردازش کرده میتواند کشته شود، به صفر مقیاس شود (Scale to zero)، یا بهطور کامل با یک نسخه جدید جایگزین شود، بدون اینکه بر روند کار اثر بگذارد.
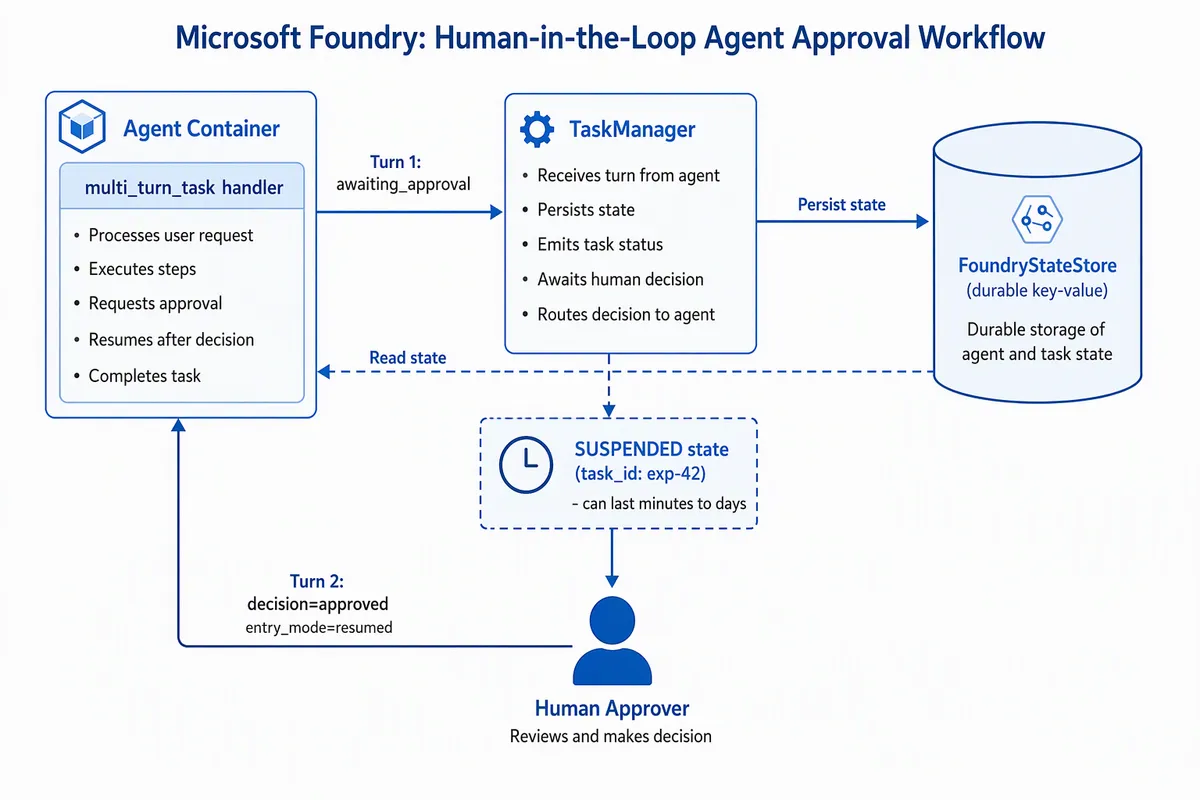
از آنجا که تعلیق در واقع یک ردیف در پایگاه داده است و نه یک رشته (Thread) مسدود شده، هیچ هزینه «ساعت-کانتینری» برای زمان انتظار پرداخت نمیشود. یک multi_turn_task تعلیق شده، نه رشتهای است که روی input() مسدود شده باشد و نه کانتینری که برای یک Callback گرم نگه داشته شده باشد. سیستم تنها زمانی منابع محاسباتی مصرف میکند که یک نوبت واقعاً پردازش شود. چرخه حیات این فرآیند بهطور صریح از طریق Enum وضعیت وظیفه ردیابی میشود: Pending $ \rightarrow $ InProgress $ \rightarrow $ Suspended $ \rightarrow $ Completed.
با این حال، چون فریمورک زنجیرههای تعلیق شده را بهطور خودکار (مانند وظایف One-shot) پاک نمیکند، توسعهدهندگان باید یک «کارگر پاکساز» (Reaper Job) طراحی کنند. بدون فراخوانی صریح .delete()، رکوردهای رها شده (جایی که تأییدکننده هرگز پاسخ نمیدهد یا تیکت در جای دیگری بسته شده است) بهطور نامحدود در ذخیرهساز وضعیت انباشته خواهند شد.
پیادهسازی تأییدات در سطح تولید
در یک گردش کار واقعی برای تأیید هزینه، فرآیند از یک توالی سختگیرانه پیروی میکند. در نوبت Fresh، عامل درخواست را میسازد، شناسه هزینه، مبلغ و برچسب زمانی ایجاد را در ctx.metadata ذخیره کرده و به تأییدکننده اطلاع میدهد. سپس وظیفه به حالت تعلیق میرود. دکوراتور @multi_turn_task اجازه میدهد پارامتر timeout (مثلاً timedelta(days=7)) تعریف شود تا طول عمر کل زنجیره با توافقنامههای سطح خدمات (SLA) واقعی مطابقت داشته باشد، نه زمان اجرای کد.
زمانی که انسان پاسخ میدهد، سیستم یک نوبت Resumed را فعال میکند. هندلر باید ورودی را با همان سختگیری و تردیدی که با هر API خارجی برخورد میکند، اعتبارسنجی کند تا مطمئن شود تصمیم معتبر است (مثلاً بررسی کند که تصمیم دقیقاً «تأیید» یا «رد» باشد) پیش از آنکه اقدام نهایی را اجرا کند. اگر expense_id در هنگام Resume از متادیتا گم شده باشد، هندلر باید بهجای ارسال یک هزینه نامعلوم، خطای صریح و شدیدی صادر کند.
برای نظارت عملیاتی، توصیه میشود توسعهدهندگان یک Projection جداگانه و قابل کوئری برای «تأییدات در انتظار» خارج از زیرسیستم وظایف ایجاد کنند. وضعیت Suspended بادوام است اما به عنوان یک ذخیرهساز برای رابط کاربری لیست کارهای جاری (Worklist UI) طراحی نشده است؛ شما نمیتوانید بهراحتی از زیرسیستم وظایف بپرسید «تمام تأییداتی که قدیمیتر از ۴۸ ساعت هستند و یادآوری ارسال نشدهاند کدامند». یک جدول مجزا با کلید task_id باید مدیریت یادآورها، ارتقای SLA و داشبوردها را بر عهده بگیرد.
الگوهای پیشرفته و فریمورکها
فاندری اجازه «بازگشتهای زمانبندی شده» (Scheduled Resumes) را میدهد. برای مثال، یک کرونجاب (Cron Job)، تایمر Logic App یا یک عامل دیگر میتواند پس از ۴۸ ساعت یک نوبت را به task_id ارسال کند تا در صورت عدم پاسخ انسان، یک ارتقای وضعیت (Escalation) را فعال کند. با استفاده از یک فیلد kind در ورودی (مثلاً kind: "escalation_check")، هندلر میتواند تفاوت بین تصمیم انسانی و بررسی سیستمی را تشخیص دهد. این به عامل اجازه میدهد موضوع را به مدیر ارشد ارجاع دهد و سپس زنجیره را بدون حل کردن نهایی، دوباره تعلیق کند.
برای کسانی که از ارکستراتورهای سطح بالا استفاده میکنند، فاندری از طریق پروتکل Responses با ابزارهای زیر یکپارچه است:
- LangGraph: از
interrupt()در داخل یک گره استفاده کرده و چکپوینتر گراف را برای سریالسازی در ذخیرهساز وضعیت فاندری پیکربندی میکند. وقتیresilient_background=Trueتنظیم شود، بازیابی داخلی LangGraph در صورتی کهcontext.is_recoveryدرست باشد، گراف را از آخرین چکپوینت بازسازی میکند. - Microsoft Agent Framework: از
ApprovalRequiredAIFunctionوRequestInfoEventبرای مدیریت تأییدات در یک گراف ارکستراسیون کد-محور (SequentialBuilder/HandoffBuilder) استفاده میکند. این روش، ابزار سطح بالای ترجیحی است، در حالی که@multi_turn_taskابزار سطح پایینتری است که این قابلیتها بر روی آن ساخته شدهاند. استفاده مستقیم از@multi_turn_taskبرای معناشناسیهای سفارشی مانند حد نصاب تأیید چند نفره (Quorums) یا آستانههای تأیید خودکار شرطی توصیه میشود. این لایهی مدیریتی در واقع همان سیستمهای مدیریت عامل است که نقش سیستمعامل را برای نرمافزارهای خودگردان ایفا میکنند.
حفاظهای امنیتی و عملیاتی
امنیت بر عهده لایه اپلیکیشن است، نه زیرسیستم وظایف. از آنجا که هر کسی با داشتن task_id تئوریکاً میتواند تصمیمی ارسال کند، اپلیکیشن باید پیش از فراخوانی approve.run()، هویت و مجوزهای فراخوان را تأیید کند. این بررسی باید قبل از وقوع Resume رخ دهد، نه در داخل هندلر، زیرا در آن مرحله فریمورک نوبت را پذیرفته است.
توسعهدهندگان هشدار یافتهاند که از شناسههای قابل حدس (مانند "exp-42") استفاده نکنند. بهجای آن، استفاده از UUIDها یا HMACهای شناسههای داخلی رکوردها، مانع از آن میشود که بازیگران مخرب با شمارش شناسهها، درخواستهای خودشان را تأیید کنند. علاوه بر این، ctx.metadata فقط باید مراجع کوچک (فیلدهای اسکالر) را نگه دارد زیرا یک گاوصندوق اسرار (Secrets Vault) نیست؛ بنابراین باید از ذخیره دادههای حساس (PII) و کلیدهای API در آن پرهیز کرد.
یک سطح خطرناک دیگر، تزریق پرامپت (Prompt Injection) است. اگر کارت تأییدی که به انسان نشان داده میشود، از ورودیهای غیرقابل اعتماد (مثلاً شرح هزینه ارسال شده توسط کاربر یا یک صفحه وب استخراج شده) ساخته شده باشد، باید پاکسازی شود. حالتی که یک تأییدکننده روی دکمه «تأیید» در کارتی کلیک کند که توسط محتوای تزریق شده دستکاری شده است، یک مدل شکست واقعی است. در این راستا، برخی شرکتها مانند Cognous انتقال حفاظها به لایهی سختافزار را برای مهار دقیقتر عاملهای خودمختار پیشنهاد دادهاند.
پیامدهای هزینه و عملکرد
مقیاسپذیری توسط محدودیتهای توان عملیاتی ذخیرهساز وضعیت مدیریت میشود. هر آیتم در ذخیرهساز حداکثر ۱ مگابایت ظرفیت JSON سریالسازی شده دارد و نامهای ذخیرهساز میتوانند ۱ تا ۱۲۸ کاراکتر باشند و تا ۱۶ تگ برای هر آیتم پشتیبانی شود. زنجیرههای تعلیق شده هیچ هزینهای برای محاسبات ندارند، به این معنی که این الگو بدون نیاز به برنامهریزی ظرفیت (به جز فضای ذخیرهسازی)، تا دهها هزار تأیید در انتظار مقیاس میپذیرد.
یک خطای خاص که باید مراقب آن بود TaskConflictError است؛ این خطا زمانی رخ میدهد که دو پروسه بهطور همزمان برای Resume کردن یک تأیید رقابت کنند (مثلاً یک دوبار-کلیک کاربر به همراه یک Retry از سمت Webhook). این وضعیت باید به عنوان یک شرط قابل تکرار (Retryable) با مکانیزم Backoff مدیریت شود.
ریسک اصلی هزینه «غیرمستقیم» است: اگر یک هندلر حالت ورودی (Entry Mode) را بررسی نکند و در هر بار ارسال یادآور (Escalation Ping)، فراخوانیهای گرانقیمت LLM (مانند تولید خلاصه) را دوباره اجرا کند، هزینهها به شدت افزایش مییابد. تفکیک درست entry_mode تضمین میکند که کارهای سنگین فقط در نوبت Fresh انجام شوند و از هزینههای تکراری توکن برای یک درخواست تأیید واحد جلوگیری شود.
توصیههای نهایی برای استقرار
برای جلوگیری از شکستهای رایج در استقرار، توسعهدهندگان باید این دستورالعملهای خاص را دنبال کنند:
- مقداردهی: همیشه
set_resilient_tasks_enabled(True)را پیش از استارت هاست فراخوانی کنید. فراموش کردن این مورد، رایجترین علت خطاهایTaskManagerNotInitializedاست. - اعتبارسنجی ورودی: هرگز فرض نکنید نوبت Resumed حتماً یک تصمیم است. این نوبت میتواند یک یادآور یا بررسی ارتقای وضعیت باشد. همیشه شکل (Shape) Payload را اعتبارسنجی کنید.
- محدودیت متادیتا: از ذخیره کل بدنه درخواست در
ctx.metadataپرهیز کنید. برای تاریخچههای حجیم از چکپوینتهایFoundryStateStoreاستفاده کنید تا از سقف ۱ مگابایتی و وابستگی به طرح (Schema Coupling) جلوگیری شود. - تکرارناپذیری (Idempotency): مطمئن شوید اکشن نهایی (مثلاً
submit_expense()) تکرارناپذیر است. رابطهای کاربری تأیید مستعد ارسالهای دوگانه هستند و باید تا حد امکان ازif_last_input_idاستفاده شود. - ردپای حسابرسی: وضعیت وظیفه یک لاگ حسابرسی (Audit Log) مطابق با استانداردها نیست. هویت تأییدکننده و برچسب زمانی را بهطور صریح در یک سیستم لاگ مجزا با درجه انطباق (Compliance-grade) در لحظه ساخت ورودی Resume ثبت کنید.
این معماری بار اعتماد به هوش مصنوعی را جابهجا میکند. با ایجاد نقاط توقف بادوام و قابل بازبینی، سازمانها میتوانند عاملها را از حالت «پیشنهاددهنده» (Read-only) به «اجراکننده» اقدامات تعیینکننده در حوزههای مالی و زیرساختی تبدیل کنند.
گام بعدی شما
- اگر از LangGraph استفاده میکنید، بررسی کنید که آیا چکپوینتر شما با ذخیرهسازهای بادوام (Durable Stores) یکپارچه است یا خیر.
- در طراحی عاملهای خود، برای هر عملیات حساس یک
task_idمنحصربهفرد بر اساس UUID تعریف کنید. - یک Job برای پاکسازی (Reaper) رکوردهای تعلیق شده در دیتابیس خود پیادهسازی کنید تا از تورم حافظه جلوگیری شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو