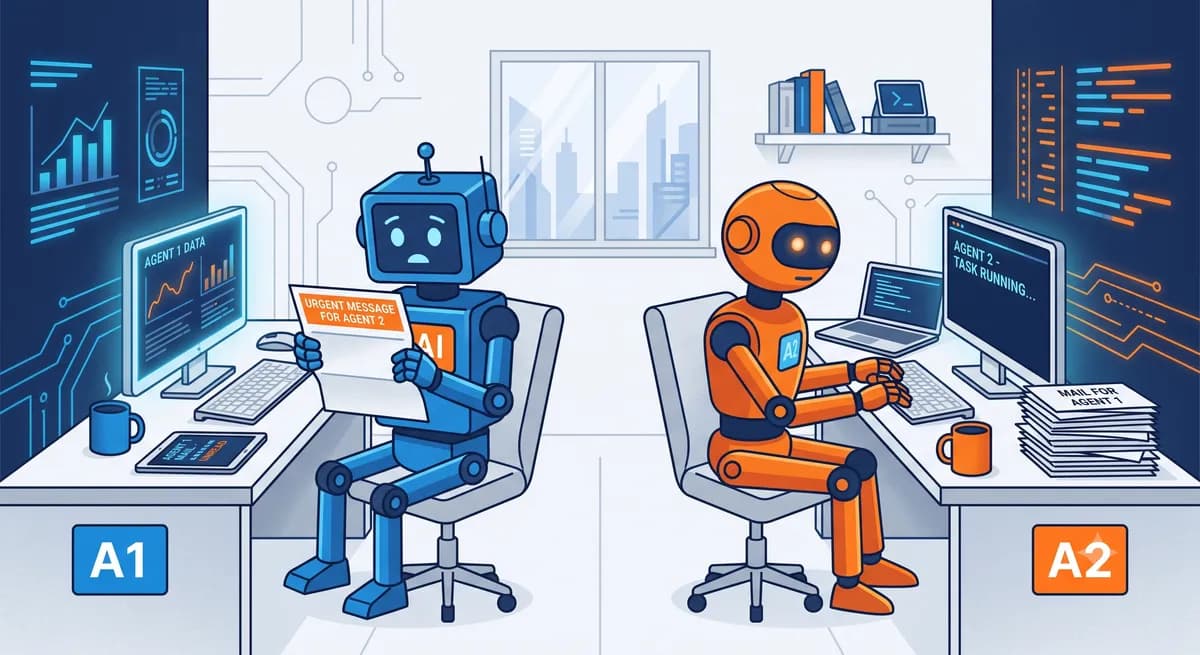
تصور کنید یک مدل هوش مصنوعی در حال پاسخ به درخواست شماست، اما ناگهان تصمیماتش را بر اساس دادههای خصوصی کاربر دیگری میگیرد. این کابوس امنیتی واقعیتِ یک باگ بحرانی بود که در ژوئیه ۲۰۲۶ در گره عاملهای هوش مصنوعی n8n کشف شد و اجازه میداد گفتگوهای کاربران مختلف در حین پردازش دستهای (Batch Processing) به یکدیگر نشت کنند.
این وضعیت شبیه به یک نامهرسان دیجیتال است که بهاشتباه نامههای چندین نفر مختلف را در یک پاکت میگذارد و به دست گیرنده میرساند. برای توسعهدهندگانی که از n8n — یک پلتفرم اتوماسیون گردشکار متنباز و گره-محور که برای توسعهدهندگان طراحی شده (مشابه یک نسخه قابل میزبانی شخصی از Zapier) — استفاده میکنند، این اتفاق صرفاً یک اختلال ساده نبود؛ بلکه یک تخریب خاموش در همان سیستم حافظهای بود که باید مسیر حرکت عاملها (Agents) را تضمین میکرد. این چالش در مدیریت وضعیت، یادآور موانعی است که بسیاری از سازمانها در استقرار مدلهای عملیاتی با آن دست و پنجه نرم میکنند؛ چنانکه ۸۰٪ پروژههای سازمانی هوش مصنوعی بهدلیل شکافهای هماهنگی مشابه در مقیاس تولید شکست میخورند.
مکانیسم نشت دادهها
این مشکل دقیقاً در قابلیت پردازش دستهای (Batch Processing) گره Agent جای داشت. این ویژگی طراحی شده است تا یک مدل زبانی بزرگ (LLM) را در یک حلقه فراخوانی ابزار (Tool-calling loop) قرار دهد. این ساختار به مدل اجازه میدهد تا گرههای دیگر در یک گردشکار را به عنوان «ابزار» فراخوانی کند، نتایج را ببیند و بر اساس آنها تصمیم بگیرد که در مراحل بعدی برای چندین آیتم مختلف چه مسیری را طی کند.
برای کاهش هزینهها و رعایت محدودیتهای نرخ درخواست (Rate Limits)، گره Agent از پردازش دستهای پشتیبانی میکند تا چندین آیتم ورودی را بهطور همزمان از این حلقه عبور دهد. اما نقص زمانی رخ میدهد که پردازش دستهای با اندازه ۲ یا بیشتر فعال باشد و دو آیتم در یک دسته، هر دو نیاز داشته باشند در یک دور (Round) ابزاری را فراخوانی کنند؛ در این حالت، سیستم نمیتواند تاریخچه آنها را مجزا نگه دارد. این عدم تفکیک دقیق در مسیر استدلال، اهمیت پیادهسازی سیستمهای ردیابی پیشرفته را دوچندان میکند، مشابه آنچه در فرآیند تحلیل تصمیمگیری در سیستمهای چندمرحلهای Maxim AI برای شفافسازی گامهای مدل بررسی شده است.
سناریوی شکست در دنیای واقعی
برای درک بهتر، یک سناریوی همزمانی (Concurrency) خاص را در نظر بگیرید:
- آیتم ۰ ابزار
get_weatherرا برای شهر برلین فراخوانی میکند. - آیتم ۱ ابزار
get_stock_priceرا برای شرکت ACME فراخوانی میکند.
در دور سوم، زمانی که سیستم میخواهد بافت گفتگو (Conversation Context) برای آیتم ۱ را بازسازی کند، بهاشتباه فراخوانی آبوهوای برلین مربوط به آیتم ۰ را به جای فراخوانی قیمت سهام خودش در تاریخچه قرار میدهد. در نتیجه، مدل زبانی که در حال پردازش آیتم ۱ است، اکنون بر اساس تاریخچه یک آیتم کاملاً متفاوت استدلال میکند.

این یک شکست خاموش است. هیچ استثنایی (Exception) پرتاب نمیشود و هیچ خطایی در رابط کاربری (UI) نمایش داده نمیشود. سیستم صرفاً پاسخی غلط تولید میکند که بر اساس دادههای شخص دیگری ساخته شده است، و همین موضوع آن را به نوعی خطرناک از تخریب بافت (Context Corruption) تبدیل میکند.
ریشه فنی مشکل
این فروپاشی در طول چرخه رفت و برگشت موتور (Engine Round-trip)، بهطور خاص بین دو فایل رخ میداد:
۱. executeBatch.ts: این جزء موتور، تمام درخواستهای خروجی برای یک دور را در یک شیء مشترک ادغام میکند. در طی این فرآیند، سیستم فقط متادیتای اولین آیتم (که شامل previousRequests یا همان تاریخچه فراخوانی ابزار خود آیتم است) را نگه میدارد و متادیتای تمام آیتمهای دیگر در آن دسته را بهطور خاموش دور میریزد.
۲. buildSteps.ts: هنگام بازسازی گفتگوی یک آیتم برای دور بعدی، این فایل هر آنچه از previousRequests از مرحله ادغام باقی مانده باشد را به گامهای هر آیتم میچسباند (Splice). چون هیچ فیلتری برای بررسی اینکه این تاریخچه واقعاً متعلق به کدام آیتم است وجود ندارد، این اتصال بهطور بیقید و شرط انجام میشود.

در مجموع: هر آیتمی که تصادفاً اولِ دسته قرار بگیرد، «برنده» جایگاه تاریخچه مشترک میشود و هر آیتم دیگر در آن دسته، بهجای دادههای خودش، دادههای آن برنده را به ارث میبرد.
جراحی سهمرحلهای برای رفع نقص
برای حل این مشکل در ۱۶ ژوئیه ۲۰۲۶، توسعهدهنده سه تغییر کد مشخص را بر اساس اصل «برچسبگذاری به جای حدس زدن» پیاده کرد:
- برچسبگذاری (Tagging): یک فیلد اختیاری به نام
itemIndexبهToolCallData(نوع دادهای که نماینده یک گام فراخوانی ابزار است) اضافه شد. اکنون هر گام در لحظه ایجاد در فایلbuildSteps.tsبا ایندکس مربوط به خود برچسب میخورد. - ادغام (Merging): در فایل
executeBatch.tsمنطق بهروزرسانی شد تا بهجای دور ریختن همه به جز اولین مورد، آرایهpreviousRequestsتمام آیتمهای مشارکتکننده را به هم متصل (Concatenate) کند. - فیلتر کردن (Filtering): منطق فایل
buildSteps.tsاکنونpreviousRequestsادغام شده را فیلتر میکند تا فقط ورودیهایی که باitemIndexخاص آن آیتم مطابقت دارند را پیش از اتصال، جدا کند.

جزئیات پیادهسازی کد:
- منطق فیلتر:
steps.push(...response.metadata.previousRequests.filter((step) => step.itemIndex === itemIndex)); - منطق ادغام:
request.metadata = { ...request.metadata, previousRequests: [...(request.metadata?.previousRequests ?? []), ...otherPreviousRequests] };
تحلیل ریشه با کمک هوش مصنوعی
فرآیند حل این مشکل قدرت تحلیل ریشه (Root-Cause Analysis) با کمک AI را برجسته کرد. برای به دست آوردن شواهدی فراتر از خواندن دستی کد، توسعهدهنده یک محیط دمو ساخت که کد واقعی پروژه (و نه یک بازسازی ساده) را اجرا میکرد و با Sentry ابزارگذاری شده بود.
پیش از اعمال اصلاحات، این سیستم دو رویداد هشدار در Sentry تولید کرد: «تاریخچه گفتگوی آیتم ۱ شامل دادههای فراخوانی ابزار آیتم ۰ است» و «تاریخچه فراخوانی ابزارهای خودِ آیتم ۱ در حین ادغام دستهای حذف شد»، که با یک Trace Span با برچسب cross_item_leak_detected: true همراه بود.
با استفاده از ابزار AI شرکت Sentry به نام Seer، توسعهدهنده متوجه شد که AI بهطور مستقل فایلها و شماره خطوط دقیق ایجاد نشت را شناسایی کرده است. Seer فایلهای executeBatch.ts و buildSteps.ts (خطوط ۳۱۶ تا ۳۹۵)، prepareItemContext.ts و runAgent.ts را به عنوان شواهد ذکر کرد.

Seer نه تنها مشکل را تشخیص داد، بلکه یک برنامه اصلاحی ۴ مرحلهای و یک Diff کد تولید کرد که تقریباً با اصلاح نهایی تایید شده توسط انسان یکسان بود. این برنامه گام به گام منطبق بود: برچسبگذاری ToolCallData با itemIndex، فیلتر کردن در buildSteps و ادغام در executeBatch.


یک تفاوت طراحی قابل توجه ظاهر شد: فیلتر تولید شده توسط Seer اجازه میداد ورودیهای بدون برچسب (itemIndex === undefined) برای سازگاری با نسخههای قدیمی (Backward Compatibility) به تمام آیتمها منتقل شوند. اما توسعهدهنده انسانی پیادهسازی سختگیرانهتری را انتخاب کرد، زیرا از این پس هر گامی بهطور غیرمشروط برچسبگذاری میشود.
اعتبارسنجی از طریق Google Gemini
اعتبارسنجی بیشتر توسط Google Gemini در یک جلسه عیبیابی سه-پیامی انجام شد، جایی که کد اصلاحنشده بدون هیچ نتیجهگیری قبلی به AI داده شد. Gemini بهدرستی مکانیسم «ربودن مرجع» (Reference-hijacking) در ادغام و اتصال بیقید و شرط را به عنوان عامل اصلی شناسایی کرد.
همچنین Gemini بررسیهای منطقی حیاتی ارائه داد:
- تله «اصلاح ناقص»: Gemini توضیح داد که اگر فقط
buildSteps.tsاصلاح شود وexecuteBatch.tsنادیده گرفته شود، تداخل دادهها با «از دست رفتن کامل دادهها» جایگزین میشود. اگر دادهها در مرحله ادغام دور ریخته شوند، چیزی برای فیلتر کردن در مرحله بازسازی باقی نمیماند و احتمالاً باعث میشود عامل ابزارها را دوباره فراخوانی کند چون فراموش کرده است که قبلاً آنها را صدا زده است. - نکته مورد متادیتا: در حالی که توسعهدهنده ابتدا روی
iterationCount(که برای قطعکننده حداکثر تکرار استفاده میشد) تمرکز کرده بود، Gemini اشاره کرد که هر فیلد متادیتای مربوط به آیتم (بهجزpreviousRequests) همچنان بهطور خاموش فقط مقدار اولین آیتم را منعکس میکند، زیرا ادغامrequest.metadataاز آیتم ۰ انجام میشود. این چارچوب دقیقتر به شرح نهایی PR (درخواست ادغام) اضافه شد.

شکاف میان انسان و AI و مرحله تایید
علیرغم دقت AI در تولید کد، یک شکاف حیاتی باقی مانده بود: تست. در حالی که Seer یک Diff تقریباً کامل تولید کرد و حتی یک PR خودکار (PR شماره ۲ در فورک توسعهدهنده) نوشت، اما این کد بدون هیچ تستی ارسال شده بود.
با پیروی از دستورالعملهای مشارکت در n8n — که برای تمام PRها تست میخواهد و در غیر این صورت ریسک بسته شدن خودکار بعد از ۱۴ روز را دارد — توسعهدهنده انسانی یک مجموعه اعتبارسنجی دقیق ارائه کرد:
- تستهای رگرسیون قطعی (Deterministic Regression Tests): دو تست جدید ایجاد شد تا آیتمهای دستهای را که دادههای فراخوانی ابزار متمایزی باز میگردانند شبیهسازی کند و موفقیت سیستم را پس از اصلاح تایید کند.
- تست مجموعه کامل: تمام ۳۳۸ تست موجود در مجموعه Agent/agent-execution سبز باقی ماندند تا اطمینان حاصل شود هیچ رگرسشنی رخ نداده است.
این موضوع نشاندهنده تغییری در توسعه AI است: ارزش دیگر در تولید خام کد نیست، بلکه در اعتبارسنجی و تعیین محدوده (Scoping) است تا اطمینان حاصل شود که یک وصله (Patch) در محیط عملیاتی قابل ادغام است. ارسال نهایی (PR #34360) نسخه تست شده و تایید شده توسط انسان است.
برای کسانی که عاملهای هوش مصنوعی خود را مقیاس میکنند، این پرونده هشدار میدهد که «دستهبندی» (Batching) یک بهبود عملکرد خنثی نیست؛ بلکه لایهای از مدیریت وضعیت ایجاد میکند که در آن یک خطای ایندکسگذاری ساده میتواند حریم خصوصی کل کاربران را به مخاطره بیندازد. اگر در حال حاضر دستهبندی را در گردشکارهای عاملمحور خود پیاده میکنید، منطق ادغام وضعیت خود را بازبینی کنید تا مطمئن شوید متادیتای سطح آیتم هرگز در یک شیء مشترک واحد جمع نمیشود.
گام بعدی شما
- اگر در گردشکارهای عاملمحور خود از پردازش دستهای استفاده میکنید، منطق ادغام متادیتا (Metadata Merge) را فوراً بازبینی کنید.
- برای شناسایی نشتهای مشابه، از ابزارهای مانیتورینگ با قابلیت Trace مانند Sentry استفاده کنید تا تداخل دادهها را ردیابی کنید.
- در پیادهسازی حافظه عامل، هرگز به ترتیب ورود دادهها اعتماد نکنید و برای هر آیتم یک شناسه یکتا (Unique ID) تعریف کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.





گفتگو