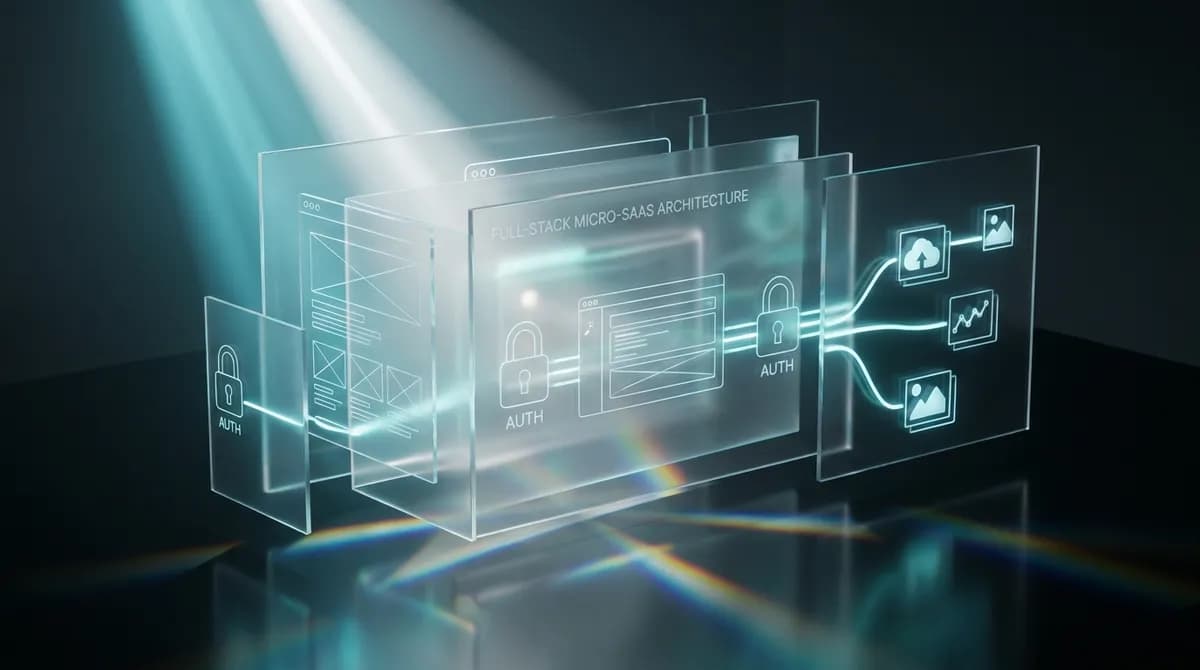
تصور کنید به جای صرف ۴۰ ساعت زمان برای ساخت زیرساختهای تکراری، در یک بعدازظهر یک اپلیکیشن هوش مصنوعی کاملاً کاربردی را روی شبکه منتشر کنید. این همان تغییری است که n8n با تبدیل شدن به یک موتور بکاند بدون سر (Headless Backend)، در چرخه توسعه ایجاد کرده است. در حالت عادی، توسعهدهندگان هفتهها وقت خود را صرف نوشتن کدهایی میکنند که هیچ ارزش رقابتی ایجاد نمیکند؛ کدهایی مانند نوشتن میانافزارهای احراز هویت (Authentication Middleware)، پیادهسازی هشینگ رمز عبور، پیکربندی مهاجرتهای پایگاهداده (Database Migrations)، ایجاد نقاط اتصال REST برای عملیاتهای پایه CRUD، سیمکشی محدودکنندههای نرخ درخواست (Rate Limiters) و اتصال صفهای پردازشی هوش مصنوعی. اکنون با n8n، سازندگان میتوانند این وظایف را برونسپاری کنند. n8n مدیریت احراز هویت JWT، ذخیرهسازی داخلی دادهها و خط لولههای تولید ناهمگام هوش مصنوعی را بر عهده میگیرد تا بتوان تناسب محصول با بازار (Product-Market Fit) را بدون افتادن در تله زیرساختی تست کرد.
گلوگاه زیرساختی
بسیاری از سازندگان اپلیکیشنها در تلهای به نام «زیرساختهای کالا شده» میافتند. در حال حاضر، اکثر توسعهدهندگان بین دو دسته ناامیدکننده از تنظیمات بکاند انتخاب میکنند. فریمورکهای Full-stack مانند NestJS، FastAPI یا Django قدرت بالایی ارائه میدهند اما سربار راهاندازی آنها بسیار زیاد است. توسعهدهندگان باید به صورت دستی ORMها را پیکربندی کنند، مهاجرتها را تنظیم نمایند، تایید JWT را پیادهسازی کنند، اعتبارسنجیهای طرحواره (Schema Validations) بنویسند و Workerهای سفارشی برای مدیریت محدودیتهای نرخ (Rate Limits) و زمانهای انتظار (Timeouts) مدلهای زبانی بزرگ (LLM) بسازند. این چالشها در واقع همان گلوگاههای توزیع و احراز هویت هستند که مسیر توسعه ابزارهای خودمختار را دشوار میکنند.
از سوی دیگر، گزینههای مدیریتشده BaaS مانند Firebase و Supabase دادههای رابطهای پایه را به خوبی مدیریت میکنند. با این حال، آنها اغلب در ارکستراسیون پیچیده هوش مصنوعی دچار مشکل میشوند. زمانی که یک پروژه به زنجیرهای از فراخوانیهای LLM، سنتز تصاویر در پسزمینه، کسر دینامیک اعتبار کاربر و ارسال وبهوکها نیاز دارد، توسعهدهندگان مجبور میشوند توابع Edge پراکندهای بنویسند که عیبیابی و ردیابی آنها بسیار دشوار است. استفاده از n8n یک صفحه کنترل بصری واحد فراهم میکند که مدیریت وضعیت (State Management) بومی، مدیریت داخلی اسرار (Secret Handling) و بازتلاشهای خودکار (Automated Retries) برای APIهای ناپایدار شخص ثالث در حوزه هوش مصنوعی را بهصورت پیشفرض دارد. برای مقایسه، میتوان به یکپارچهسازی Next.js 14 و FastAPI اشاره کرد که رویکردی متفاوت برای حذف خطاهای عملیاتی در محیطهای تولیدی ارائه میدهد.
معماری بدون سر (Headless Architecture)
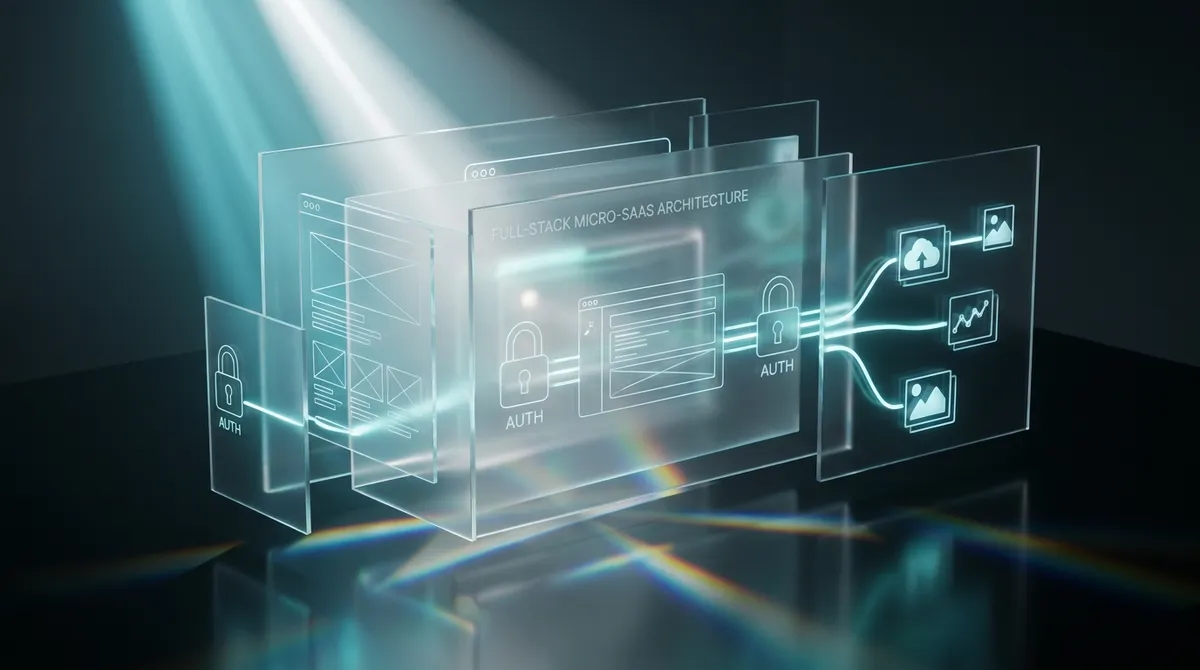
این سیستم بر پایه یک مدل جداساز عمل میکند که در آن فرانتاِند — ساخته شده با Next.js، Tailwind، Svelte یا Vue — از طریق توکنهای Bearer JWT با یک وبهوک درگاه n8n (در مسیر POST /api/v1/*) ارتباط برقرار میکند. این درگاه درخواستها را از طریق یک توپولوژی خاص مسیریابی میکند:
- زیر-گردشکار تایید JWT: یک خط لوله ایزوله که بررسیهای امضای رمزنگاری را روی JWTهای ورودی اجرا میکند تا
userIdو سطح دسترسی (tier) را استخراج کند. اگر توکن نامعتبر باشد، پاسخ 401 Unauthorized را برمیگرداند. - مسیریاب (Router): ترافیک را به اقدامات خاص هدایت میکند. برای مثال، مسیر
/user/creditsیک عملیات Read در DataTables را فعال میکند، در حالی که/items/crudذخیرهسازی موجودیتها را مدیریت میکند. - خط لوله موتور هوش مصنوعی: یک توالی اختصاصی برای پاکسازی پرامپت (Prompt Sanitization)، بودجهبندی توکنها، اجرای API مدلهای خارجی (با استفاده از OpenAI، Stable Diffusion، Flux یا Anthropic) و ارسال دادهها به ذخیرهساز S3.
پیادهسازی منطق آماده تولید (Production-Ready)
برای تبدیل این ساختار به یک سیستم آماده تولید، معماری از یک گره کد JavaScript بومی برای تایید JWT استفاده میکند. به جای فراخوانی ارائهدهندگان خارجی برای هر اقدام داخلی، این سیستم از APIهای WebCrypto بومی برای رمزگشایی توکنها و تایید امضاهای HMAC-SHA256 در برابر متغیرهای محیطی (مانند $env.JWT_SECRET) استفاده میکند. این منطق ساختار توکن را بررسی کرده (که نیازمند سه بخش است) و زمان انقضا (exp) را بر حسب ثانیه در برابر زمان فعلی اعتبارسنجی میکند. اگر توکن منقضی شده باشد یا امضا تطبیق نداشته باشد، گردشکار بلافاصله پاسخ 401 Unauthorized را برمیگرداند.
قبل از اینکه یک مدل هوش مصنوعی فعال شود، سیستم یک لایه سختگیرانه برای پاکسازی و بررسی اعتبار اجرا میکند. این کار از تزریق پرامپت (Prompt Injection) با حذف کاراکترهایی مانند < یا \0 جلوگیری کرده و اطمینان حاصل میکند که کاربر موجودی کافی دارد.
مکانیزمهای اعتبارسنجی ورودی
- پاکسازی پرامپت: سیستم متن خام پرامپت را میبرد (Trim) و یک محدودیت طول (بین ۵ تا ۱۰۰۰ کاراکتر) را اعمال میکند. اگر پرامپت خارج از این محدوده باشد، سیستم خطا صادر میکند.
- کسر اعتبار: سیستم موجودی کاربر را در لایه DataTables بررسی میکند. برای مثال، اگر
COST_PER_GENERATIONروی ۲ اعتبار تنظیم شده باشد و کاربر کمتر از آن را داشته باشد، سیستم کد وضعیت 402 را با پیام «موجودی اعتبار ناکافی. شارژ مجدد لازم است» برمیگرداند. - متادیتای اجرا: پس از اعتبارسنجی موفق، گره مربوطه مقادیر
sanitizedPrompt(پرامپت پاکسازی شده)،newCreditBalance(موجودی جدید) و یک برچسب زمانی (Timestamp) را برمیگرداند.
مدیریت دادهها و پایداری
به جای اختصاص یک نمونه PostgreSQL یا MongoDB مجزا در مرحله نمونهسازی، این ساختار از n8n DataTables بهره میبرد. این امر اجازه میدهد تا کل لایه پایداری (Persistence Layer) مستقیماً درون بکآپهای گردشکار گنجانده شود. یک مسیر وبهوک واحد میتواند تمام عملیاتهای استاندارد CRUD را بر اساس متد HTTP ($input.item.json.method) مدیریت کند:
- GET: رکوردهایی را برمیگرداند که محدود به
userIdاستخراج شده از JWT هستند. - POST: ردیفهای جدید را با تولید خودکار UUID درج میکند.
- PATCH: متاداتا یا فیلدهای وضعیت را برای رکوردهای موجود بهروزرسانی میکند.
- DELETE: ردیفها را به عنوان حذف شده علامتگذاری کرده یا آنها را بهطور کامل از جدول حذف میکند.
حل مشکل تأخیر و مقیاسپذیری هوش مصنوعی
تولیدکنندههای تصویر هوش مصنوعی مانند Flux، APIهای Midjourney یا SDXL اغلب ۵ تا ۳۰ ثانیه زمان میبرند تا نتایج را برگردانند، که معمولاً باعث Timeout شدن مرورگر در سمت کلاینت میشود. برای حل این مشکل، معماری از الگوی «دستدادن وبهوک» (Webhook Handshake Pattern) استفاده میکند:
۱. وبهوک دادهها را دریافت کرده و بلافاصله پاسخ 202 Accepted را به همراه یک execution_id صادر میکند.
۲. گردشکار اصلی، دادهها را از طریق گره Execute Sub-Workflow به یک زیر-گردشکار منتقل میکند، در حالی که گزینه «Wait for Sub-Workflow Completion» روی False تنظیم شده است.
۳. زیر-گردشکار Worker، عملیات تولید را اجرا کرده، دارایی حاصل را در یک باکت سازگار با S3 آپلود میکند و وضعیت رکورد DataTable را از «در حال پردازش» به «تکمیل شده» تغییر میدهد.
۴. فرانتاِند یک نقطه اتصال سبک /api/v1/status?jobId=... را نظارت (Poll) میکند یا از طریق SSE / WebSockets گوش میدهد.
همزمانی و قابلیت اطمینان
برای جلوگیری از اشباع حافظه سرور در زمان پیک ترافیک، توصیه میشود n8n در حالت Queue Mode و با استفاده از Redis اجرا شود. این کار به توسعهدهندگان اجازه میدهد تا Webhook Workerها را بهطور مستقل از Execution Workerها مستقر کنند. علاوه بر این، از یک پروکسی معکوس بالادستی مانند NGINX، Traefik یا Caddy برای اعمال هدرهای محدودکننده نرخ (Rate-limiting) استفاده میشود تا IPهای کلاینت قبل از رسیدن درخواستها به شنوندههای n8n، محدود شوند.
این تغییر در فلسفه بکاند به این معناست که یک محصول هوش مصنوعی کاربردی میتواند در یک بعدازظهر به جای هفتهها مستقر شود. با متمرکز کردن وضعیت و اجرا در یک ارکستراتور بصری، بدهی فنی مربوط به نگهداری میانافزارهای سفارشی تقریباً حذف میشود.
برای کسانی که به دنبال پیادهسازی این سیستم هستند، این معماری به عنوان یک Boilerplate شامل گرههای تایید توکن پیشساخته و خط لولههای تصویر هوش مصنوعی در دسترس است. این بسته شامل معماری کامل JSON قابل وارد کردن، مشخصات API و نمونههای تست است. اکنون میتوانید روی ارزش اصلی هوش مصنوعی تمرکز کنید، نه لولهکشیهای خستهکننده هش کردن رمز عبور و مهاجرتهای پایگاهداده.
توسعهدهندگان در گام بعدی باید نحوه ادغام OpenTelemetry برای ایجاد نردههای حفاظتی هزینه LLM و پروکسیهای کش معنایی (Semantic Cache) را بررسی کنند تا اطمینان حاصل شود که این خط لولههای خودکار منجر به صورتحسابهای غیرمنتظره API نمیشوند. در همین راستا، راهکارهای بهینهسازی هزینه مانند سیستم T-Zero V3 توانستهاند هزینههای توکنها را تا ۹۵٪ کاهش دهند که مکمل مناسبی برای این معماری است.
گام بعدی شما
- معماری مذکور را به عنوان یک Boilerplate برای تست سریع ایدههای Micro-SaaS به کار ببرید.
- برای جلوگیری از هزینههای پیشبینینشده API، ادغام OpenTelemetry را برای نظارت بر هزینههای مدلهای زبانی بررسی کنید.
- از پروکسیهای کش معنایی (Semantic Cache) برای کاهش تعداد فراخوانیهای تکراری مدل استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو