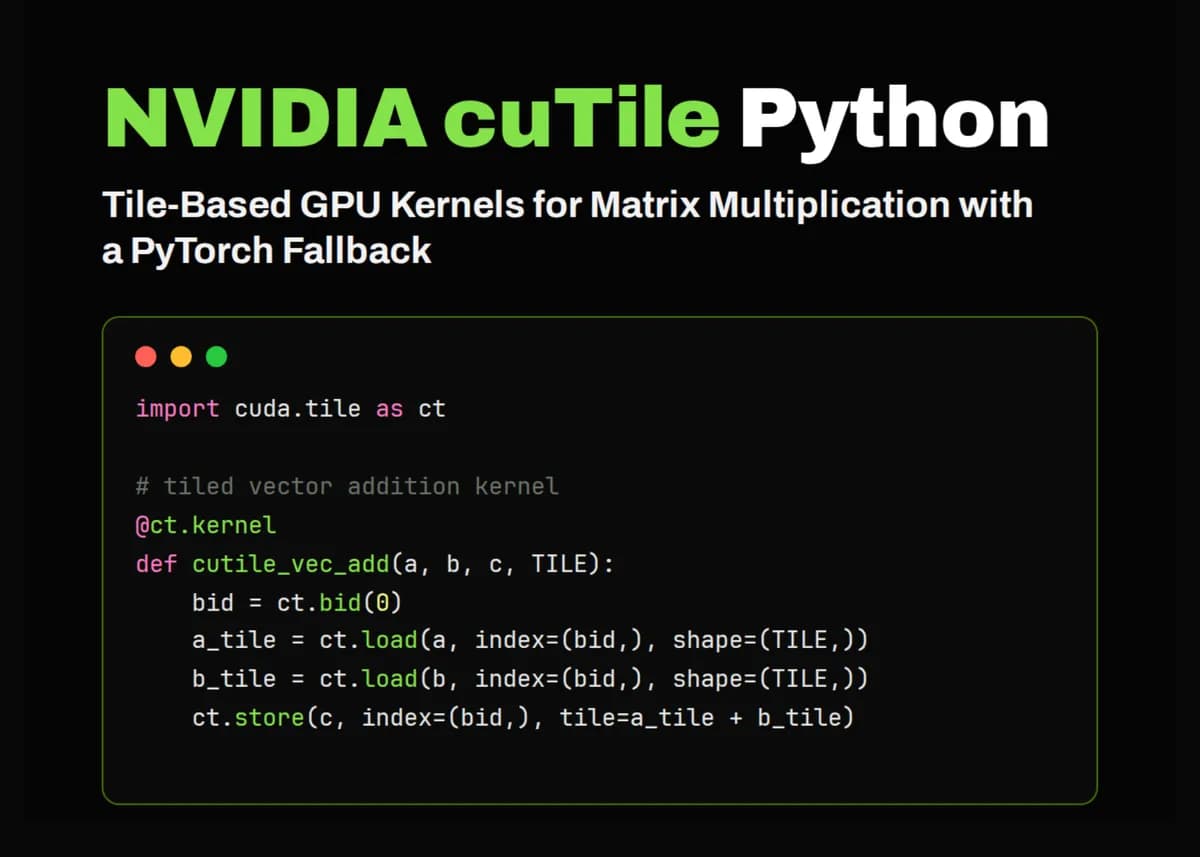
اگر برنامهنویسی هستید که میخواهد عملکرد GPU را بهینه کند اما نمیخواهد درگیر پیچیدگیهای کدنویسی C++ CUDA شود، NVIDIA cuTile Python مسیر جدیدی را پیش روی شما گذاشته است. این ابزار اجازه میدهد عملیاتهای سنگین گرافیکی را مستقیماً در پایتون تعریف کنید و سرعت اجرای سطح پایین را به محیط توسعه سریع پایتون بیاورید. cuTile با فراهم کردن یک مسیر مستقیم به هستههای کاشیوار (Tiled Kernels) با عملکرد بالا، اصطکاک سنتی بین نمونهسازی در سطح بالا و اجرای سختافزاری در سطح پایین را از بین میبرد.
سالها بود که توسعهدهندگان مجبور بودند بین راحتی PyTorch و سرعت خام CUDA یکی را انتخاب کنند؛ یا با اجرای کندتر کنار میآمدند یا به زنجیرههای پیچیده ابزارهای C++ پناه میبردند. cuTile به عنوان یک پل ارتباطی عمل میکند و رابط برنامهنویسی «کاشیوار» یا Tile-based را معرفی میکند که دقیقاً مشابه نحوه مدیریت حافظه و محاسبات در سختافزار GPU است. این رویکرد برای بارهای کاری مدرن هوش مصنوعی که در آنها پهنای باند حافظه اغلب گلوگاه اصلی است، حیاتی است.
همانطور که در تحلیلهای پیشین ما درباره بهینهسازیهای سختافزاری مدلهای زبانی اشاره کردیم، مدیریت بهینه حافظه تنها راه رسیدن به سرعتهای واقعی است. در این راستا، cuTile با تقسیم دادهها به قطعات کوچکتر، فشار روی حافظه را کاهش میدهد.
گردش کار پیادهسازی cuTile
به نقل از آموزش منتشر شده در Marktechpost، گردش کار این ابزار با بررسی دقیق محیط در Google Colab آغاز میشود. برای اجرای واقعی هستههای cuTile، سیستم به درایور NVIDIA نسخه R580 یا بالاتر و CUDA Toolkit 13.1+ نیاز دارد. از آنجایی که محیطهای Colab متغیر هستند، این آموزش یک مکانیزم جایگزین (Fallback) با PyTorch پیادهسازی کرده است تا اطمینان حاصل شود که کدها حتی در رانتایمهای قدیمیتر نیز قابل اجرا باقی میمانند.
پس از تایید محیط، سیستم از یک مسیر نصب خاص از طریق بسته cuda-tile[tileiras] در PyPI استفاده میکند. فرآیند راهاندازی شامل چندین مرحله تشخیصی است:
- نصب پیشنیازمهای پایتون با استفاده از دستور
pip install -q -U pip setuptools wheelو سپس نصبtorch,numpy,pandasوmatplotlib. - تایید دسترسی PyTorch به CUDA از طریق تابع
torch.cuda.is_available(). - بررسی قابلیت محاسباتی GPU (مانند sm_80 یا sm_90) با استفاده از
torch.cuda.get_device_capability(0). - تحلیل نسخه درایور با استفاده از دستور
nvidia-smi --query-gpu=driver_version --format=csv,noheaderبرای اطمینان از سازگاری با بکاند cuTile.
تشخیصهای زمان اجرا و منطق جایگزین
این آموزش از یک بررسی جامع استفاده میکند تا تعیین کند آیا وارد کردن (import) کتابخانه cuda.tile با موفقیت انجام شده است یا خیر. اگر نسخه اصلی درایور ۵۸۰ یا بالاتر باشد و عملیات import با موفقیت انجام شود، مسیر cuTile فعال میگردد. در صورتی که این شرایط برقرار نباشد، سیستم به طور خودکار به حالت جایگزین PyTorch بازمیگردد. این موضوع تضمین میکند که آموزش برای همه کاربران، صرفنظر از اینکه نمونه Colab آنها دارای آخرین درایور NVIDIA R580+ و CUDA Toolkit 13.1+ هست یا خیر، قابل دسترسی باشد.
ساخت هستههای کاشیوار (Tiled Kernels)
مرکز این فناوری بر سه عملیات بنیادی GPU متمرکز است که هر کدام با منطق کاشیوار برای حداکثر بهرهوری پیاده شدهاند. این هستهها با استفاده از دکوراتور @ct.kernel تعریف میشوند و برای انواع اعداد صحیح ثابت از ConstInt استفاده میکنند.
جمع برداری (Vector Addition): در این آموزش، دو روش متمایز برای جمع برداری نمایش داده شده است:
- هسته مستقیم (Direct Kernel): از
ct.loadوct.storeبر اساس شناسه بلوک (ct.bid(0)) برای مدیریت کاشیهای متوالی با اندازهTILEاستفاده میکند. - هسته Gather: از
ct.gatherوct.scatterبهره میبرد. این روش آفستها را با استفاده از فرمولbid * TILE + ct.arange(TILE, dtype=torch.int32)محاسبه میکند که برای مدیریت دادههای غیرمتوالی و ایندکسگذاریهای پیچیده ضروری است.
جمع ماتریسی (Matrix Addition): این پیادهسازی از یک شبکه دو-بعدی از کاشیها استفاده میکند. با تعریف ثابتهای TILE_M (که روی ۱۶ تنظیم شده) و TILE_N (که روی ۶۴ تنظیم شده)، هسته مدیریت میکند که سطرها و ستونها چگونه به صورت موازی پردازش شوند. این هسته از ct.bid(0) برای بعد M و ct.bid(1) برای بعد N استفاده میکند. همچنین با ترکیب بازههای سطر و ستون (rows[:, None] و cols[None, :]) ایندکسهای دو-بعدی ایجاد میکند تا عملیات gather و scatter را به صورت ایمن از نظر مرزی انجام دهد و از سرریز حافظه (Memory Overflow) جلوگیری کند.
ضرب ماتریسی (MatMul): این پیچیدهترین پیادهسازی است که از ct.mma (ضرب-تجمع ماتریسی) بهره میبرد و کاشیها را در بعد K مدیریت میکند. هسته تعداد کاشیها در محور K را با استفاده از ct.num_tiles(A, axis=1, shape=(TM, TK)) محاسبه میکند.
مکانیسمهای فنی کلیدی در اینجا عبارتند از:
- تجمع (Accumulation): یک متغیر تجمعکننده با استفاده از
ct.full((TM, TN), 0, dtype=ct.float32)مقداردهی اولیه میشود. - پدینگ (Padding): از
ct.PaddingMode.ZEROبرای مدیریت ابعادی استفاده میشود که مضرب کامل اندازه کاشی نیستند. - تغییر دقت: آموزش یک بهینهسازی حیاتی را برجسته میکند: استفاده از
ct.tfloat32برای ورودیهای float32 جهت بهرهگیری از هستههای تنسور (Tensor Cores). برای بارهای کاری با دقت نصف (float16)، اندازه کاشیها به ۱۲۸x۱۲۸x۶۴ تغییر میکند، در حالی که برای float32 اندازه ۳۲x۳۲x۳۲ است.
اجرا و اعتبارسنجی دقیق
برای اثبات کارایی این هستهها، آموزش نمونههای خاصی را با اشکال و انواع مختلف تنسور اجرا میکند:
- جمع برداری کاشیوار: از اندازه تنسور $N = 1,000,003$ استفاده میکند. این تست توانایی هسته در مدیریت ابعاد بزرگ و اعداد فرد را میسنجد. رپِر
vec_add_tutorialدر صورت استفاده از gather، اندازهTILEرا ۲۵۶ قرار میدهد، یا در صورت استفاده از روش مستقیم، اندازه کاشی را بر اساس توان دو بر اساس کل عناصر محاسبه میکند. - جمع ماتریسی کاشیوار: از ابعاد $M=777$ و $N=1001$ استفاده میکند. انتخاب این ابعاد خاص که مضرب کامل نیستند، ماهیت ایمن از نظر مرزی (boundary-safe) پیادهسازی gather/scatter را تایید میکند.
- ضرب ماتریسی Float32: از ابعاد $M=512, K=768, N=384$ استفاده میکند. آموزش دستور
torch.set_float32_matmul_precision("high")را روی CUDA تنظیم میکند تا مقایسهای عادلانه با عملیات استاندارد PyTorch صورت گیرد. - ضرب ماتریسی با دقت نصف: از همان ابعاد $512 \times 768 \times 384$ اما با نوع داده
torch.float16استفاده میکند. این بخش انتقال به اندازههای کاشی بزرگتر (۱۲۸, ۱۲۸, ۶۴) را برای بهینهسازی نرخ انتقال داده در هستههای تنسور نشان میدهد.
بنچمارک و تایید صحت
این آموزش تنها به پیادهسازی اکتفا نمیکند، بلکه این هستهها را در برابر عملیات استاندارد PyTorch بنچمارک میکند. برای اطمینان از دقت، بررسی صحت با استفاده از torch.testing.assert_close با تلرانسهای خاص بر اساس دقت انجام میشود:
- ضرب Float32: از
atol=1e-2وrtol=1e-2در محیط CUDA استفاده میکند. - ضرب Float16: از
atol=5e-2وrtol=5e-2استفاده میکند. - جمع عمومی: از تلرانس سختگیرانهتر
1e-4استفاده میکند.
عملکرد با استفاده از یک ابزار بنچمارک سفارشی اندازهگیری میشود. این فرآیند شامل یک مرحله گرمکردن (Warmup) با ۵ اجرا و سپس ۲۰ تکرار است. این ابزار زمان شروع و پایان را با time.perf_counter() ثبت میکند، GPU را از طریق torch.cuda.synchronize() همگامسازی میکند و میانگین، میانه، حداقل و حداکثر زمان اجرا را به میلیثانیه محاسبه میکند. این نتایج در یک DataFrame پانداس سازماندهی شده و از طریق نمودار میلهای Matplotlib که زمان میانه را برای هر عملیات نشان میدهد، بصریسازی میشود.
مسیرهای بهینهسازی پیشرفته
فراتر از جمع و ضرب ساده، آموزش چندین آزمایش با تاثیر بالا را برای توسعهدهندگانی که میخواهند در بهینهسازی GPU استاد شوند پیشنهاد میکند:
- جستجوی اندازه کاشی (Tile Size Sweeps): تغییر مقادیر
TM,TNوTKبرای یافتن تعادل بهینه بین اشغال حافظه و استفاده از هستههای تنسور. این امر حیاتی است زیرا شکل کاشی کنترل میکند که سختافزار چگونه به حافظه دسترسی یابد. - ابعاد غیرمضرب: تست با ابعادی مانند ۱۰۰۳x۷۷۱ برای تایید نحوه مدیریت پدینگ و رفتار مرزی در طول عملیات gather/scatter.
- مقایسه دقت: مقایسه float32، float16 و bfloat16، زیرا مسیرهای هسته تنسور برای دقتهای کاهشیافته به طور قابل توجهی قویتر هستند.
- ادغام عملیات (Operation Fusion): ترکیب یک جمع برداری با فعالساز ReLU برای محاسبه
c = relu(a + b). این کار ترافیک حافظه را با نگه داشتن دادهها برای مدت طولانیتر در رجسترهای GPU کاهش میدهد؛ تکنیکی که در هستههای تولیدی LLM بسیار رایج است. - مطالعه Attention: تحلیل نمونه
AttentionFMHA.pyاز مخزن کد برای درک اینکه چگونه هستههای کاشیوار به معماریهای ترنسفورمر و بارهای کاری سبک Flash Attention قدرت میبخشند.
این چرخش به سمت هستههای GPU بومی در پایتون به این معناست که «مالیات عملکردی» زبانهای سطح بالا در حال کاهش است. توسعهدهندگان اکنون میتوانند منطق هسته را در یک نوتبوک آزمایش کنند و آن را با کارایی نزدیک به زبان C++ مستقر نمایند.
برای کسانی که میخواهند این ابزار را امروز پیادهسازی کنند، فوریترین گام، بررسی این است که آیا محیط فعلی آنها نیاز درایور R580+ را برآورده میکند یا خیر، و یا بررسی الگوهای جایگزین PyTorch برای شبیهسازی رفتار کاشیوار است.
گام بعدی شما
- بررسی کنید که آیا درایور سیستم شما نسخه R580 یا بالاتر است تا بتوانید از قابلیتهای بومی cuTile استفاده کنید.
- اگر دسترسی به درایور جدید ندارید، الگوهای Fallback پایتورچ را برای شبیهسازی رفتار کاشیوار بررسی کنید.
- برای درک عمیقتر، نمونه کد
AttentionFMHA.pyرا مطالعه کنید تا ببینید این تکنیک چگونه سرعت مدلهای ترنسفورمر را بالا میبرد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell و نحوه مدیریت حافظه در نسل جدید مراجعه کنید.



گفتگو