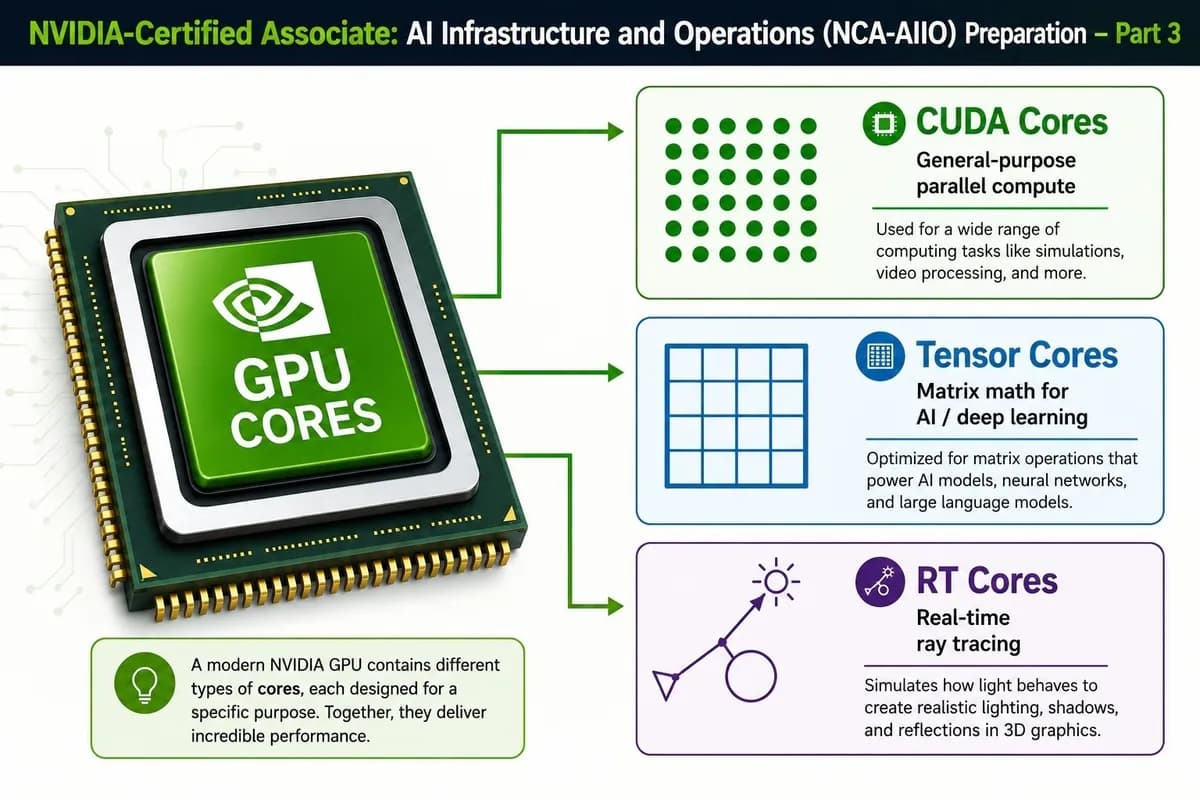
اگر یک توسعهدهنده هستید که برای استقرار مدلهای سنگین برنامهریزی میکند، باید بدانید که گلوگاه عملکرد شما لزوماً تعداد کل هستهها نیست، بلکه توزیع بار میان تخصصهای سختافزاری است. تصور کنید یک کارت گرافیک انویدیا (NVIDIA GPU) را نه بهعنوان یک تکواحد، بلکه مجموعهای پیچیده از سه نوع هسته متمایز ببینید که هر کدام برای یک عملیات ریاضی خاص طراحی شدهاند.
بر اساس راهنمای فنی منتشر شده در ۲۹ ژوئیه ۲۰۲۶ در وبسایت dev.to، کلید دستیابی به زیرساختهای بهینه هوش مصنوعی در ترکیب درست این بارهای کاری نهفته است. این ساختار شبیه به یک کارگاه ساختمانی است که در آن کارگران عمومی، معماران متخصص و طراحان نورپردازی همزمان روی یک پروژه کار میکنند؛ شما هرگز از متخصص نورپردازی نمیخواهید که بتن ریختن را مدیریت کند. همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی مرکز داده اشاره کردیم، تخصص سختافزاری جایگزین قدرت خام شده است. این رویکرد بهینهسازی در مقیاس کلان با چالشهای دسترسی به سختافزار گره خورده است؛ چنانکه مدلهای جدید تامین مالی چرخهای تلاش میکنند تا گلوگاههای دسترسی به این سختافزارهای تخصصی را برطرف کنند.
طبق مستندات فنی، تفکیک سختافزاری به شرح زیر است:
- هستههای کودا (CUDA Cores): کارگران عمومی سیستم هستند که محاسبات موازی را برای پردازش ویدیو، محاسبات علمی و بارهای کاری سنتی GPU مدیریت میکنند.

هستههای تنسور (Tensor Cores) — مانند موتورهای جتی که بهجای حرکت آرام، دادهها را با سرعت برقآسا در ضربهای ماتریسی میچرkhanند — موتور محرک هوش مصنوعی مدرن هستند. این هستهها بهطور خاص برای ضرب سریع ماتریسها بهینه شدهاند که زیربنای آموزش مدل زبانی بزرگ (LLM)، تولید تصویر و ایجاد بردار معنایی (Embedding) برای مدلهایی مثل ChatGPT است.
هستههای RT (RT Cores): تمرکز این بخش بر گرافیکهای واقعگرایانه است و بازتاب و شکست نور را برای رندرینگ سهبعدی و شبیهسازیهای گیمینگ محاسبه میکند.
به نقل از منابع تخصصی، این تخصصیشدن به این معناست که هنگام مقیاسگذاری زیرساختهای AI، محدودیت اصلی معمولاً دسترسی به هستههای تنسور برای وظایف یادگیری عمیق است. برای یک مهندس، این تغییر یعنی بهینهسازی دیگر فقط مربوط به کارآمدی نرمافزاری نیست، بلکه باید روی حداکثر کردن توان عملیاتی (Throughput) موتور تنسور تمرکز کند. کسانی که این تفاوت را نادیده بگیرند، در مرحله استنتاج (Inference) مدلهای زبانی با افت شدید عملکرد مواجه خواهند شد. در کنار بهینهسازی توان پردازشی، مدیریت منابع محیطی نیز در نسلهای جدید اهمیت یافته است و طراحیهای جدیدی مانند معماری روبین بر کاهش مصرف آب در مراکز داده تمرکز دارند.
گام بعدی شما
- بررسی میزان اشغال هر یک از هستهها در هنگام اجرای مدل با استفاده از ابزارهای مانیتورینگ انویدیا
- مطالعه مستندات NVIDIA-Certified Associate: AI Infrastructure and Operations (NCA-AIIO) برای تسلط عملی بر تعاملات سختافزاری
- تحلیل مجدد لایههای مدل برای جایگزینی عملیاتهای عمومی با توابع بهینهشده برای Tensor Cores
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک لایههای عمیقتر، به تحلیل ما دربارهی معماری تراشههای Blackwell مراجعه کنید.



گفتگو