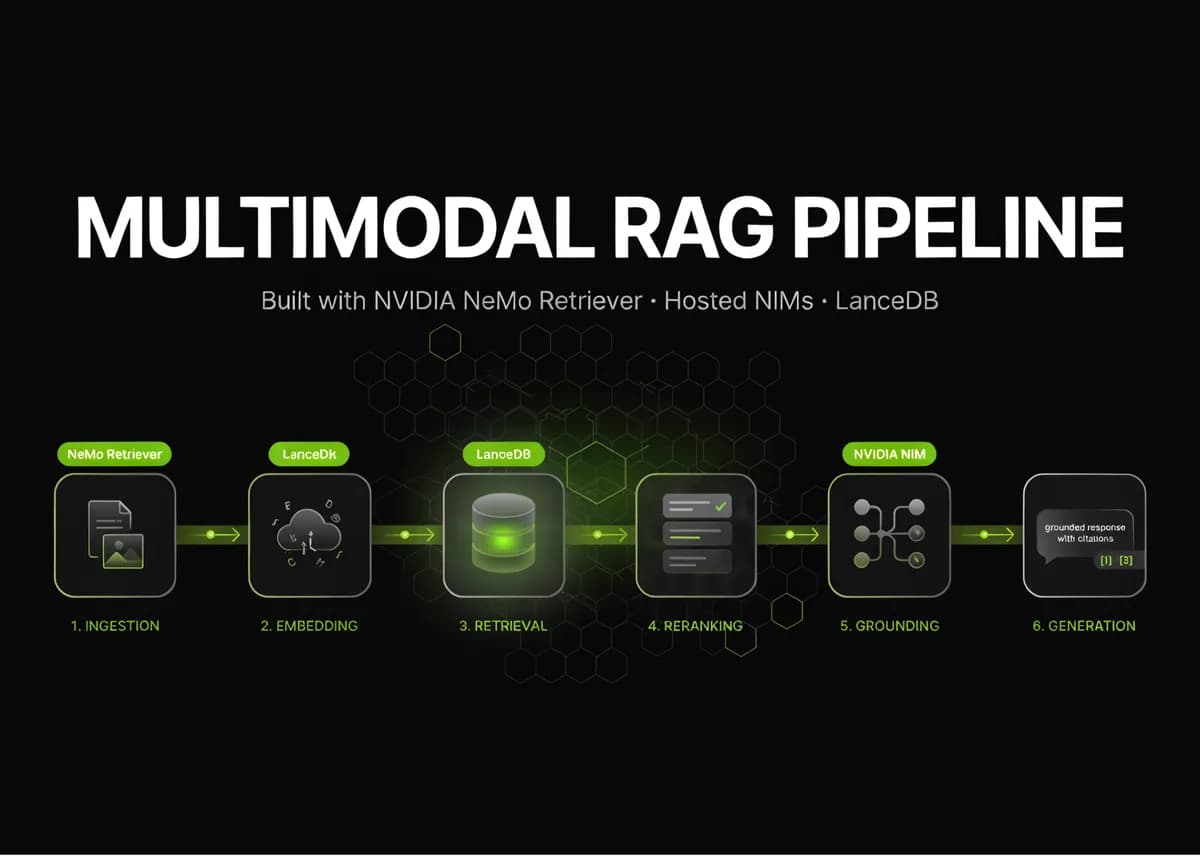
تصور کنید یک مدیر محصول است که باید از میان هزاران صفحه گزارش فنی، دادههای دقیق یک نمودار یا یک جدول پیچیده را پیدا کند، بدون آنکه مدل هوش مصنوعی اعداد را جابهجا کند یا توهم بزند. NVIDIA NeMo Retriever دقیقاً برای حل این چالش طراحی شده تا PDFهای پیچیده را به یک پایگاه دانش قابل جستوجو و مستند تبدیل کند. این خط لوله (Pipeline) آماده تولید، PDFهای چندوجهی را به دانشی تبدیل میکند که دارای ارجاعات دقیق است و به توسعهدهندگان اجازه میدهد جداول، نمودارها و اینفوگرافیکها را در کنار متن استخراج کنند و تمام دادهها را در یک مدل زبانی مستند کنند تا از توهمات جلوگیری شود.
بسیاری از سامانههای فعلی در مواجهه با دادههای بصری شکست میخورند؛ آنها یا جداول را نادیده میگیرند یا نمودارها را به صورت متنی نامفهوم میخوانند. این نقص، یک نقطه کور بزرگ در تحلیل اسناد ایجاد میکند. انویدیا با انتقال محاسبات سنگین استنتاج (Inference) — که شبیه به سپردن آشپزی به یک رستوران صنعتی بهجای آشپزخانه کوچک خانه است — به سرویسهای میزبانیشدهی NIM (NVIDIA Inference Microservices)، این امکان را فراهم کرده تا توسعهدهندگان حتی در محیطهای سبک مثل Google Colab و بدون نیاز به GPU محلی، این خط لولههای پیشرفته را اجرا کنند.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی استنتاج در مدلهای زبانی اشاره کردیم، کاهش وابستگی به سختافزار محلی، سرعت پذیرش ابزارهای سازمانی را بهشدت افزایش میدهد.
محیط و تنظیمات اولیه
برای شروع، این خط لوله به پیکربندی خاصی از محیط نیاز دارد. این سیستم با استفاده از پایتون ۳.۱۲ ساخته شده است، زیرا کتابخانه nemo-retriever بهطور خاص برای عملکرد صحیح به این نسخه نیاز دارد. فرآیند نصب شامل بستههای کلیدی مانند PyJWT ،nemo-retriever و openai از طریق pip است.
فرآیند با دانلود یک فایل PDF چندوجهی نمونه (multimodal_test.pdf) از مخزن گیتهاب NVIDIA NeMo-Retriever آغاز میشود. این سند به عنوان بستر آزمایشی برای اعتبارسنجی توانایی سیستم در مدیریت محتوای رسانهای مختلط عمل میکند. سیستم پیش از رفتن به مراحل استخراج، وجود سند و اندازه آن را بر حسب بایت بررسی میکند.
فرآیند جذب دادههای چندوجهی
فرآیند استخراج در دو مرحله رخ میدهد: ابتدا استخراج متن بهصورت آفلاین با استفاده از PDFium انجام میشود که به هیچ کلید API یا GPU نیاز ندارد. این کار تضمین میکند که متنهای پایه پیش از رفتن به تحلیلهای بصری پرهزینه، ثبت شوند. این مرحله اولیه در حالت inprocess و با تنظیم allow_no_gpu=True اجرا میشود تا ردپای سختافزاری کمی داشته باشد. در این فاز، گزینههای extract_tables ،extract_charts ،extract_images و extract_infographics روی False تنظیم میشوند تا جریان متن ساده ایزوله شود.
در مرحله دوم، پس از تامین متن پایه، سیستم چندین نقطه اتصال (Endpoint) میزبانیشده NIM را برای مدیریت عناصر پیچیده فراخوانی میکند. فرآیند جذب داده با یک request_timeout_s معادل ۱۲۰ ثانیه پیکربندی شده است تا پیچیدگیهای تحلیل چندوجهی مدیریت شود. سیستم از نقاط اتصال تخصصی زیر استفاده میکند:
- Nemotron-Page-Elements-v3: برای تشخیص چیدمان و عناصر خاص صفحه از طریق آدرس
https://ai.api.nvidia.com/v1/cv/nvidia/nemotron-page-elements-v3. - Nemotron-OCR-v1: برای نویسهخوانی نوری (OCR) — شبیه به چشمکی که متنهای چاپ شده یا دستنویس را میخواند و به کد دیجیتال تبدیل میکند — برای متونی که قابل انتخاب نیستند از طریق آدرس
https://ai.api.nvidia.com/v1/cv/nvidia/nemotron-ocr-v1. - Nemotron-Table-Structure-v1: برای استخراج جداول و تبدیل آنها به فرمت Markdown با استفاده از آدرس
https://ai.api.nvidia.com/v1/cv/nvidia/nemotron-table-structure-v1. - Nemotron-Graphic-Elements-v1: برای تحلیل نمودارها و اینفوگرافیکها از طریق آدرس
https://ai.api.nvidia.com/v1/cv/nvidia/nemotron-graphic-elements-v1.

پالایش و پردازش دادهها
برای تضمین کیفیت دادههای جذب شده، خط لوله یک مرحله حذف دادههای تکراری (Deduplication) را پیاده میکند. این سیستم از content_hash=True و bbox_iou=True با آستانه Intersection over Union (IoU) معادل ۰.۴۵ استفاده میکند. این کار مانع از آن میشود که یک عنصر بصری یکسان، اگر در مراحل مختلف استخراج ظاهر شود، چندین بار ایندکس شود.
برای سازماندهی متن، سیستم از تکهبندی (Chunking) توکن-آگاه استفاده میکند. تنظیمات split_config روی حداکثر ۵۱۲ توکن برای هر تکه با همپوشانی (Overlap) ۶۴ توکن قرار داده شده است. این همپوشانی تضمین میکند که بافت معنایی در مرز تکهها حفظ شود و از دست رفتن اطلاعاتی که هنگام نصف شدن یک جمله رخ میدهد، جلوگیری شود.
ذخیرهسازی برداری و بازیابی
پس از استخراج، خط لوله از مدل Llama-Nemotron-Embed-1b-v2 (از طریق نقطه اتصال https://integrate.api.nvidia.com/v1/embeddings) برای تولید جاسازیهای برداری متراکم (Dense Vector Embeddings) استفاده میکند. سیستم با inference_batch_size معادل ۱۶ و nim_http_max_concurrent برابر با ۸ پیکربندی شده است تا بازدهی در مرحله Embedding بهینه شود. نوع ورودی (input_type) در هنگام جذب دادهها بهطور خاص روی "passage" تنظیم شده است.
این بردارها به همراه متادادههایشان در LanceDB (در مسیر ./lancedb و جدول colab_demo) ذخیره میشوند. پایگاه داده از یک ایندکس IVF_HNSW_SQ با معیار l2 برای جستوجوی کارآمد شباهت استفاده میکند. این امر به سیستم اجازه میدهد تا جستوجوهای سریع مبتنی بر فاصله را در میان هزاران قطعه سند انجام دهد.
برای افزایش دقت، یک مرحله بازرتبهبندی (Reranking) زبان-بینایی پیاده شده است. در حالی که بازیابی اولیه مجموعهای گسترده از کاندیداها را مییابد (top_k=5)، مدل Llama-Nemotron-Rerank-VL-1b-v2 (از طریق نقطه اتصال https://ai.api.nvidia.com/v1/retrieval/nvidia/llama-nemotron-rerank-vl-1b-v2/reranking) این نتایج را بر اساس ارتباط معنایی با پرسوجو بازآرایی میکند. این بازرتبهبند از یک refine_factor معادل ۴ و batch_size معادل ۱۶ استفاده میکند تا مطمئن شود مرتبطترین تکههای بصری و متنی به مدل زبانی (LLM) ارسال میشوند.
مکانیسمهای پیشرفته بازیابی
این سیستم فراتر از جستوجوی معنایی ساده عمل میکند. سیستم بازیابی با فیلتر متاداده را پیاده کرده است که به توسعهدهندگان اجازه میدهد فیلترها را به پایگاه داده برداری منتقل کنند. برای مثال، یک پرسوجو برای «هزینه گجتها» میتواند با استفاده از یک عبارت where مانند text LIKE '%Cost%' محدود شود. این کار تضمین میکند که بازیاب فقط تکههایی را در نظر بگیرد که صراحتاً به هزینهها اشاره کردهاند و نویز را در بافت بازیابی شده بهشدت کاهش میدهد.
توسعهدهندگان همچنین میتوانند با اتصال مستقیم به جدول LanceDB، دادههای خام را بررسی کنند تا تعداد کل ردیفها را تایید کرده و قطعات متن ایندکس شده را پیش از ارسال به مرحله تولید بررسی کنند. خط لوله همچنین توابع کاربردی مانند to_markdown و to_markdown_by_page را برای تبدیل سند پردازش شده به فرمتی قابل خواندن برای انسان فراهم میکند.
تولید مستند و اعتبارسنجی
مرحله نهایی از مدل Llama-3.3-Nemotron-Super-49b-v1.5 (از طریق نقطه اتصال https://integrate.api.nvidia.com/v1) برای تولید پاسخها استفاده میکند. سیستم پرامپتی را میسازد که مدل را اکیداً به بافت (Context) ارائه شده محدود میکند و ارجاعات درونمتنی (مانند [1]، [2]) و شماره صفحات را برای تضمین ردیابیپذیری الزامی میکند. مدل زبانی با دمای (Temperature) ۰.۰ برای تضمین پاسخهای قطعی و واقعی و محدودیت max_tokens معادل ۵۱۲ پیکربندی شده است.
برای اعتبارسنجی سیستم، این آموزش از ارزیابی recall-at-k استفاده میکند. بازیاب در برابر یک مجموعه «طلایی» از پاسخهای مورد انتظار تست میشود، شامل:
- شناسایی اینکه کدام حیوان روی لپتاپ میپرد (پاسخ مورد انتظار: گربه).
- تعیین اینکه یک نمودار خاص چه چیزی را نشان میدهد (پاسخ مورد انتظار: گجتها).
- شناسایی اینکه کدام حیوان در ساحل است (پاسخ مورد انتظار: زرافه).
با محاسبه امتیاز recall@5 ،سیستم میتواند بهطور کمی اندازهگیری کند که پاسخ صحیح در چند درصد موارد در ۵ تکه برتر بازیابی شده ظاهر میشود. این یک اعتبارسنجی ریاضی از کیفیت بازیابی در محتوای چندوجهی فراهم میکند.
این معماری بار پردازش چندوجهی را از کلاینت محلی به ابر منتقل میکند. با استفاده از یک رویکرد ماژولار که در آن استخراج، جاسازی و بازرتبهبندی تماسهای API جداگانه هستند، توسعهدهندگان میتوانند با آمدن نسخههای جدیدتر Nemotron، مدلها را بدون نیاز به بازسازی کل پایگاه داده تعویض کنند.
برای کاربر نهایی، این به معنای تغییر از «چت با یک PDF» به «پرسوجو از یک پایگاه دانش ساختاریافته» است. توانایی فیلتر کردن نتایج بازیابی با استفاده از متادادهها، بازیابی دادههای بسیار دقیقتری را نسبت به جستوجوی معنایی استاندارد به تنهایی فراهم میکند. خروجی نهایی خط لوله شامل یک فایل Markdown کامل از سند (extracted.md) و یک جدول برداری پایدار است که هر دو نسخه قابل خواندن برای انسان و قابل جستوجو برای ماشین از PDF اصلی را ارائه میدهد.
گام بعدی شما
- اگر با اسناد PDF حجیم سر و کار دارید، مدلهای Nemotron را برای استخراج ساختاریافته جداول تست کنید.
- برای کاهش نرخ توهم در پاسخها، استراتژی ارجاع اجباری (Inline Citation) را در پرامپتهای خود پیاده کنید.
- بررسی کنید که آیا استفاده از بازرتبهبندی (Reranking) میتواند دقت بازیابی دادههای بصری شما را بهبود ببخشد یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو