
اگر هنوز دادههای خود را با قوانین سختگیرانه و خشک جابهجا میکنید، احتمالاً نیمی از ارزش اطلاعاتتان را در مسیر گم میکنید. زمان آن رسیده که خط لولههای داده را از «لولههای انتقال» به «موتورهای پردازش» تبدیل کنید.
مهندسی داده در حال گذار از جابهجایی مکانیکی به استدلال هوشمند است. با ادغام سرور استنتاج تریتون انویدیا (NVIDIA Triton Inference Server یا TIS) در معماریهای استخراج، تبدیل و بارگذاری (ETL)، سازمانها اکنون میتوانند دادههای بدون ساختار را با آگاهی از زمینه پردازش کنند، بهجای آنکه به طرحهای صلب و مبتنی بر قانون تکیه کنند.
خط لولههای سنتی ETL اساساً کور هستند؛ آنها دادهها را بدون درک معنا جابهجا میکنند. همانطور که در تحلیلهای صنعتی اشاره شده است، «ETL سنتی مکانیکی است؛ استخراج میکند، تبدیل میکند و بارگذاری میکند، اما هیچ آگاهی از آنچه انجام میدهد ندارد.» صنعت اکنون به سمت «مهندسی داده بومی هوش مصنوعی» حرکت میکند، جایی که هوش مستقیماً در دل خط لوله قرار میگیرد. تصور کنید سیستمی را که فقط چک نمیکند آیا یک فیلد خالی است یا خیر، بلکه میفهمد آیا لحن شکایت یک مشتری نیاز به ارجاع فوری به مدیر ارشد دارد یا نه.
به نقل از راهنمای فنی dev.to، سرور استنتاج تریتون با ارائه یک رابط یکپارچه برای سرویسدهی مدلها در چارچوبهای مختلف، کاتالیزور این تغییر است. این نرمافزار متنباز برای سادهسازی استقرار مدلهای هوش مصنوعی در مقیاس تولید طراحی شده است. TIS با پشتیبانی همزمان از TensorFlow، PyTorch، TensorRT، ONNX Runtime و چارچوبهای سفارشی، وابستگی به یک فروشنده خاص (Vendor Lock-in) را از بین میبرد.
سازوکارهای فنی برای مقیاسپذیری
برای مدیریت حجم بالای داده، TIS از چندین بهینهسازی حیاتی استفاده میکند که آن را برای جریانهای کاری شبیه به ETL ایدهآل میسازد:
- دستهبندی پویا (Dynamic Batching) — شبیه به اتوبوسی که منتظر میماند تا تعداد کافی مسافر جمع شوند و سپس حرکت کند تا مصرف سوخت کم شود — درخواستهای استنتاج را برای حداکثر کردن توان عملیاتی GPU و کاهش تأخیر هر رکورد تجمیع میکند. این قابلیت برای کارهای ETL که میلیونها رکورد را پردازش میکنند، ضروری است. این رویکرد بهینهسازی سختافزاری یادآور تفاوتهای بنیادین شتابدهی GPU در برابر پردازش CPU در جریانهای کاری یادگیری ماشین است که منجر به کاهش چشمگیر زمان پردازش میشود.
- اجرای همزمان مدلها: مهندسان میتوانند مجموعهای از مدلها (Model Ensembles) را مستقر کنند که خروجی یک مدل (مثلاً استخراج ویژگی) مستقیماً به مدل بعدی (مثلاً طبقهبندی) تغذیه شود.
- انعطافپذیری سختافزاری: این سرور بار کاری را بین GPUها و CPUها بهینه میکند؛ بنابراین پردازش دستهای قدیمی روی CPU و استریم در لحظه روی GPU میتوانند در کنار هم باشند.
الگوهای ادغام معماری
ادغام معمولاً در مراحل «تبدیل» و «بارگذاری» رخ میدهد تا غنیسازی دادهها و مسیریابی هوشمند ممکن شود.
یک الگوی اصلی، استفاده از مجموعههای پیشپردازش و مهندسی ویژگی است. در سیستمهای توصیهگر و تحلیلهای پیچیده، دادههای خام باید به ویژگیهای سازگار با مدلهای هوش مصنوعی تبدیل شوند. با استقرار NVIDIA NVTabular در کنار مدلهای آموزشدیده (مانند DLRM) در یک مجموعه تریتون، مهندسان تضمین میکنند که منطق تبدیل مورد استفاده در زمان آموزش مدل، دقیقاً با منطقی که در زمان استنتاج زنده استفاده میشود، یکسان است. این کار باعث حذف انحراف دادهها (Data Skew) و تضمین سازگاری میشود.
این الگو بهویژه برای موارد زیر ارزشمند است:
- تشخیص کلاهبرداری در لحظه: دادههای تراکنش نرمال شده و فوراً به یک مدل ریسک ارسال میشوند.
- بخشبندی مشتریان: متنهای بدون ساختار به بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که همسایگی آن با کلمات دیگر را میگوید — تبدیل میشوند تا خوشهبندی صورت گیرد.
- پیشبینی سریهای زمانی: دادههای تاریخی پیشپردازش شده و به مدلهای LSTM یا ترنسفورمر تغذیه میشوند.
الگوی دیگر، جایگزینی بررسیهای ایستا با اعتبارسنجی معنایی است. ETL سنتی بر قوانین ایستا تکیه دارد (مثلاً «بررسی مقادیر null»). اما ETL تقویتشده با هوش مصنوعی از مدلهای سرویسدهی شده توسط تریتون برای اعتبارسنجی معنایی استفاده میکند. بهجای بررسیهای ساده SQL، یک مدل NLP که توسط تریتون سرویسدهی میشود، میتواند لاگها یا بازخوردها را برای شناسایی احساسات، موضوعات یا ناهنجاریها ارزیابی کند. دادههای باکیفیت به انبار داده میروند و موارد پرت (Outliers) برای بررسی دستی یا تحلیل بیشتر توسط هوش مصنوعی به یک منطقه قرنطینه هدایت میشوند.
کاربردهای دنیای واقعی
بر اساس بررسی منابع متعدد، این معماریها در محیطهای حساس با دادههای بدون ساختار در حال ظهور هستند:
- خدمات مالی: خط لولههای بانکی لاگهای تراکنش را استخراج کرده و از یک مدل تشخیص ناهنجاری مستقر در تریتون برای شناسایی فعالیتهای مشکوک استفاده میکنند و موارد شناسایی شده را در لحظه به داشبوردهای تطبیق (Compliance) ارسال میکنند.
- بهداشت و درمان: سوابق پزشکی از منابع پراکنده توسط مجموعهای از مدلهای NLP پردازش میشوند تا موجودیتهایی مانند تشخیصها و داروها استخراج شده و در قالب استاندارد یکپارچه HL7/FHIR تبدیل شوند.
- پلتفرمهای رسانهای: برای نظارت خودکار بر محتوا، دادههای خام از طریق API استخراج شده، توسط طبقهبندهای تصویر یا متن در تریتون برای فیلتر کردن محتوای سمی پردازش شده و سپس در CDN یا پایگاه داده بارگذاری میگردند.
این چرخش، فرض بنیادی مهندسی داده را تغییر میدهد: خط لوله دیگر فقط یک لوله نیست، بلکه یک موتور پردازش است. با انتقال استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دوره آموزش آشپز — به جریان ETL، گلوگاه از «چگونه داده را جابهجا کنیم» به «چگونه آن را بهتر تفسیر کنیم» تغییر مییابد. این تلاش برای بهینهسازی لحظهی استنتاج، در راستای استراتژیهای جدید همسویی مدل و سختافزار است که هدف نهایی آنها کاهش هزینهها و افزایش سرعت پاسخدهی مدلهای هوش مصنوعی است.
برای کسانی که از ارکستراتورهایی مانند Apache Airflow یا Kubeflow Pipelines استفاده میکنند، TIS از پروتکلهای gRPC و HTTP پشتیبانی میکند. این قابلیت اجازه اجرای غیرمسدودکننده و نامتقارن (Asynchronous) را میدهد تا جریان داده حتی تحت بار شدید، دچار توقف نشود و سرویسدهی مدلها باعث ایجاد گلوگاه نشود.
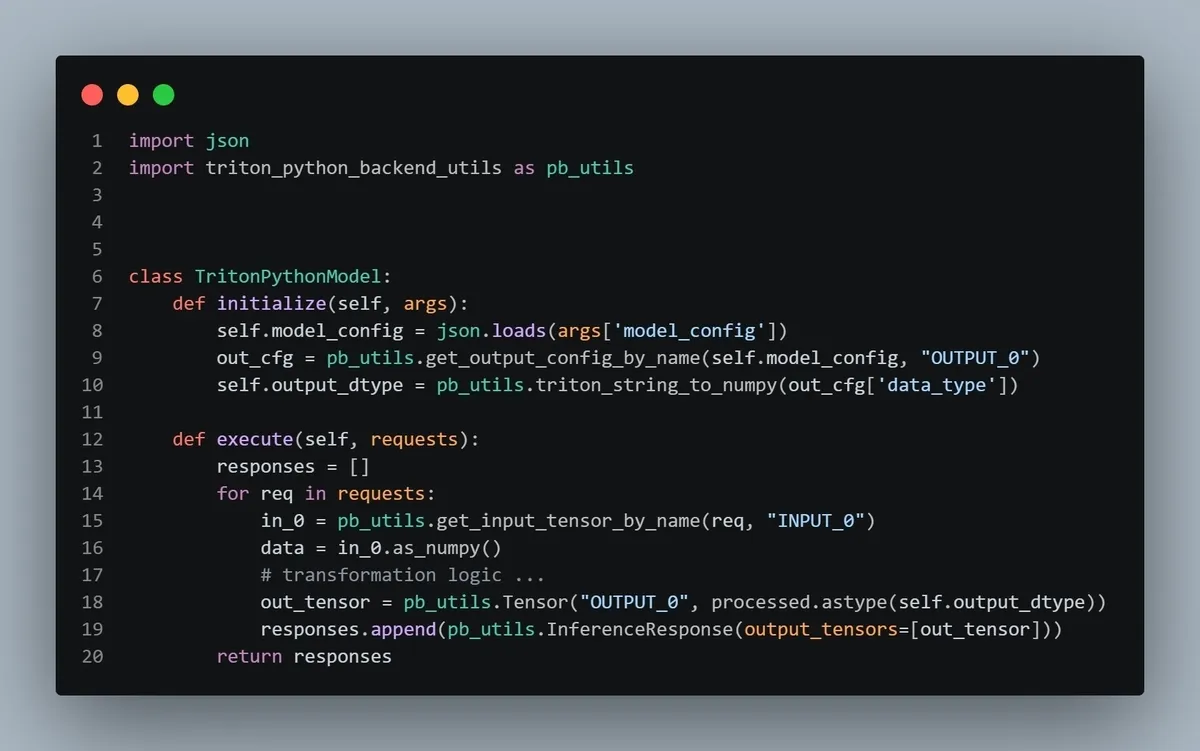
مهندسان میتوانند از بکاِند پایتون در تریتون برای اجرای منطق پیشپردازش سفارشی مستقیماً داخل سرور استفاده کنند. این کار تأخیر بین استخراج داده و رسیدن به هوش را کاهش میدهد و فاصله بین داده خام و بینش عملیاتی را میپوشاند.
گام بعدی شما
- بررسی مستندات NVIDIA Triton برای جایگزینی اسکریپتهای پیشپردازش پایتونی با مدلهای بهینه شده در TensorRT.
- ارزیابی خط لولههای ETL فعلی برای شناسایی نقاطی که اعتبارسنجی معنایی میتواند جایگزین قوانین If/Else ساده شود.
- تست قابلیت Dynamic Batching در محیطهای توسعه برای کاهش هزینه استنتاج در حجم دادههای بالا.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو