
تصور کنید برای آموزش یک ربات، بهجای یک تلاش کند و تکبهتک، بتوانید ۲۰۴۸ نسخه از آن را بهطور همزمان در دنیاهای موازی به آزمایش بگذارید. این یعنی آنچه پیشتر هفتهها زمان میبرد، اکنون در چند ساعت به نتیجه میرسد.
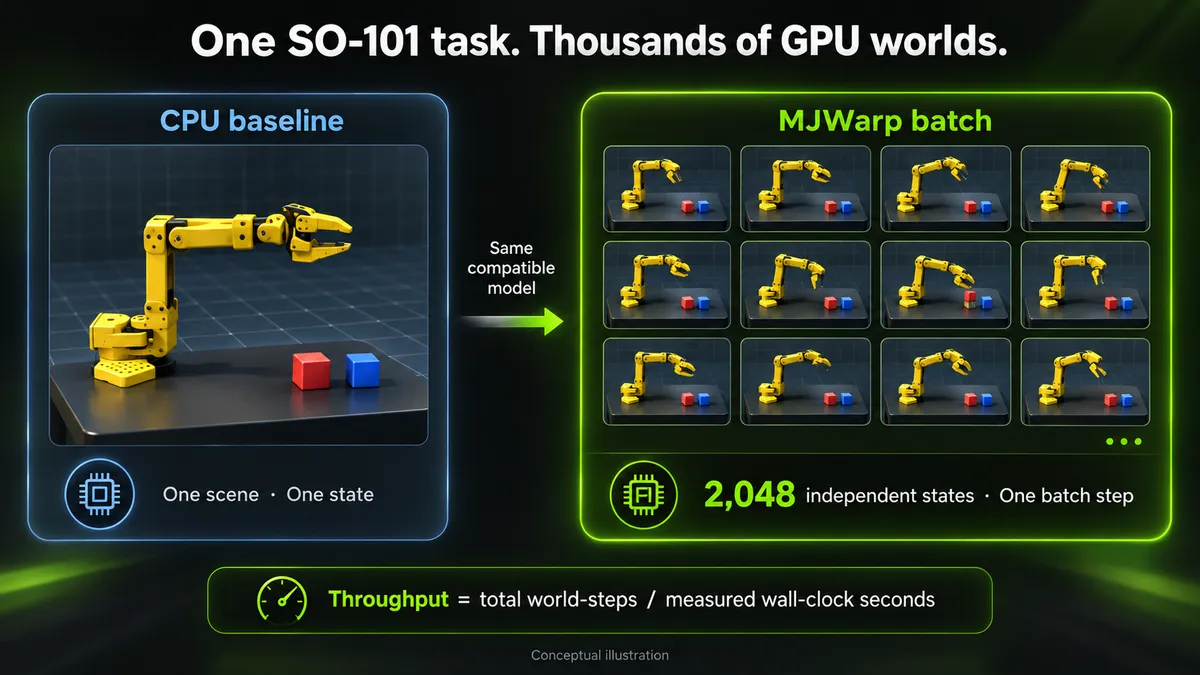
طبق اعلام انویدیا (NVIDIA)، گلوگاه اصلی در آموزش «مغز» رباتها، نیاز به میلیونها تکرار است. در حالی که شبیهسازی یک ربات با دقت بالا مسئلهای حلشده است، اما مقیاسپذیری آن تا به حال با محدودیتهای پردازنده مرکزی (CPU) روبرو بود. انویدیا با انتقال موتور فیزیک از CPU به واحد پردازش گرافیکی (GPU) — که شبیه به داشتن هزاران کارگر کوچک است که بهجای یک مهندس ارشد، تکالیف ساده را بهطور همزمان انجام میدهند — این محدودیت را شکست و امکان اجرای ۲۰۴۸ محیط موازی را در یک دسته (Batch) فراهم کرد.
این رویکرد، معیار موفقیت را از «تأخیر» (Latency) — یعنی سرعت اجرای یک دنیا — به «توان عملیاتی» (Throughput) تغییر میدهد؛ یعنی مجموع گامهای دنیایی که سیستم در هر ثانیه تکمیل میکند. این تحول از طریق MuJoCo Warp (یا MJWarp) محقق شده است که از چارچوب NVIDIA Warp برای کامپایل هستههای CUDA جهت محاسبات فیزیکی استفاده میکند.
همانطور که در تحلیلهای قبلی ما دربارهی شتابدهندههای سختافزاری اشاره کردیم، انتقال محاسبات از CPU به GPU همواره منجر به جهشی در سرعت میشود. این موضوع در حوزههای مختلف یادگیری ماشین مشهود است، بهطوری که شتابدهی GPU در مقایسه با پردازش CPU میتواند زمان جریانهای کاری پیچیده را بهشدت کاهش دهد. MJWarp همین اصل را در دینامیک اجسام صلب رباتیک پیاده کرده است. در حالی که نسخه کلاسیک MuJoCo برای کنترل و بازرسی مبتنی بر CPU بهینه شده بود، MJWarp برای نیازهای شدید یادگیری تقویتی طراحی شده است.
معماری MJWarp
در پایه این ساختار، NVIDIA Warp قرار دارد؛ یک چارچوب پایتونی که به توسعهدهندگان اجازه میدهد هستههایی با تایپ استاتیک بنویسند. این هستهها بهصورت JIT (کامپایل در لحظه اجرا) به کد بومی CUDA تبدیل میشوند تا سرعت C++ را با سهولت پایتون ترکیب کنند. اولین اجرا، یک ماژول بومی میسازد و در دفعات بعد از همان حافظه استفاده میکند.
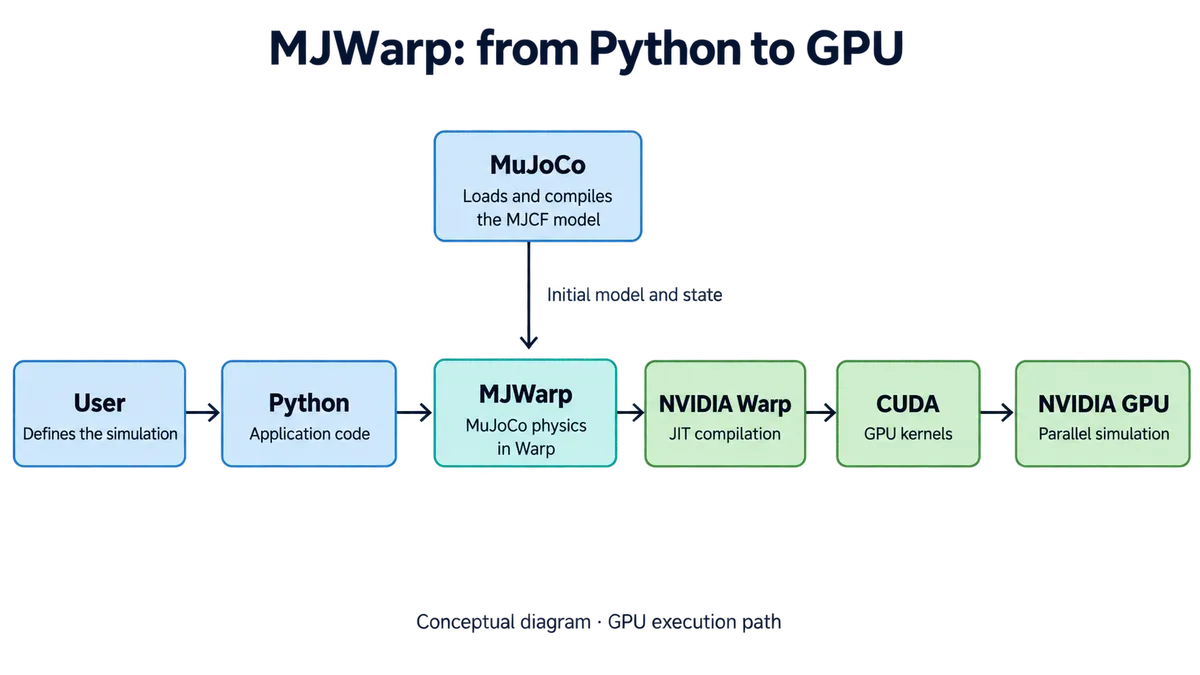
این سیستم سه ستون اصلی برای رباتیک فراهم میکند:
- عملکرد: دستیابی به سرعت بومی CUDA از طریق کامپایل JIT، ادغام هستهها (Kernel Fusion) و گرافهای CUDA.
- سهولت در استفاده: نویسندگی خالص پایتونی با پشتیبانی داخلی از بردارها، ماتریسها، کواترنیونها، BVHها، شبکههای هش (Hash Grids)، ماتریسهای پراکنده و توابع اولیه کاشی (Tile Primitives).
- قابلیت: هستههای مشتقپذیر و تعامل در سبک DLPack که اجازه میدهد شبیهسازی مستقیماً درون حلقه آموزش یادگیری ماشین قرار بگیرد.
بهعنوان مثال، یک هسته ساده در Warp میتواند موقعیت نقاط را تحت تأثیر گرانش پیش ببرد. با استفاده از wp.tid()، هر رشته منطقی یک نقطه را مدیریت میکند و کد را بدون پیچیدگیهای GPU از دو نقطه به میلیونها نقطه مقیاس میدهد.
دو قابلیت دیگر برای جریانهای کاری پیشرفته حیاتی هستند. نخست، هستههای Warp مشتقپذیر هستند؛ یعنی یک wp.Tape اجراهای هسته را ثبت کرده و هنگام فراخوانی backward()، آنها را بهصورت معکوس بازپخش میکند. این قابلیت، بهینهسازی طراحی و جریانهای کاری CAE را ممکن میسازد. دوم، نسخه ۱.۱۵ قابلیت اجرای قطعی (Deterministic) را معرفی کرد. در حالی که عملیات اتمیک GPU معمولاً وابسته به زمانبندی هستند، حالتهای قطعی را برای تستهای اعتبارسنجی و رگرسیون فراهم میکند. باید توجه داشت که اینها قابلیتهای سطح Warp هستند و تضمینی خودکار برای کل فرآیند MJWarp نیستند.
MJWarp در واقع پلی است که مدلهای سازگار MuJoCo (تعریف شده در MJCF) را گرفته و خط لوله فیزیک را روی GPU پیاده میکند. بهجای پیشبرد تکتک دنیاها، یک فراخوانی ساده از mjw.step وضعیت تمام دنیاهای موجود در یک دسته را بهطور همزمان جلو میبرد.
پشته شبیهسازی
برای درک جایگاه MJWarp، باید نقش هر لایه در پشته هوش مصنوعی فیزیکی را بررسی کنیم:
- NVIDIA Warp: زبان هسته پایتونی که SIMT (یک دستور، چندین رشته)، مشتقگیری خودکار و تعامل با PyTorch/JAX را فراهم میکند.
- MJWarp: پیادهسازی فیزیک MuJoCo روی Warp برای دستیابی به توان عملیاتی دستهای در GPU با استفاده از همان فایلهای MJCF.
- صحنه (مثلاً SO-101): داراییهای MuJoCo Menagerie یا Robot Studio ترکیب شده با هندسه تسک.
- Newton / Isaac Lab: لایههای یکپارچهساز بعدی که APIهای چند-حلکننده، USD، سنسورها، مدیران و حلقههای آموزش را ارائه میدهند.
بسته به نیاز، توسعهدهندگان مسیرهای متفاوتی را انتخاب میکنند: برای MPC تکرباتی یا کنترل از راه دور، MuJoCo CPU همچنان بهترین است، اما برای حداکثر توان عملیاتی در فیزیک خام MuJoCo، باید از MJWarp (یا mjlab) استفاده کرد. دستورالعملهای آموزشی JAX توسط MuJoCo Playground یا MJX مدیریت میشوند و یکپارچهسازی کامل چند-حلکننده در قلمرو Newton است.
مهاجرت از CPU به GPU
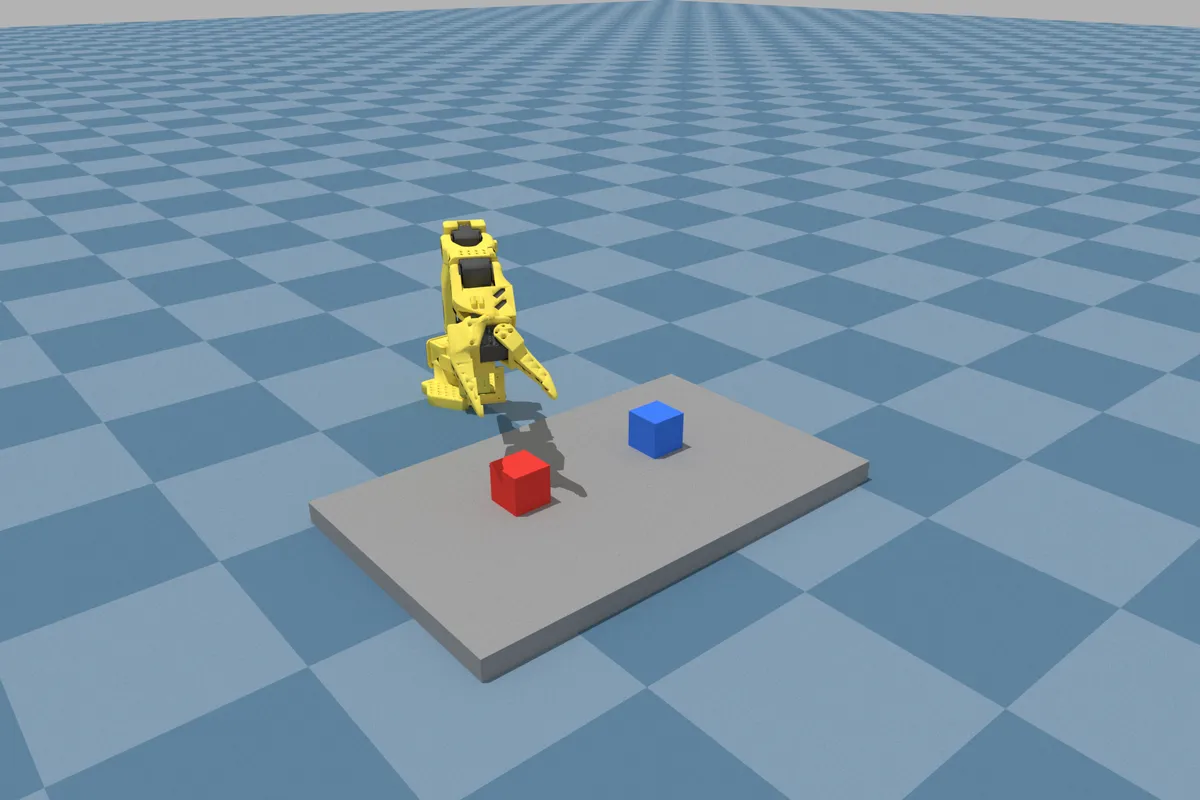
بر اساس مستندات انویدیا، برای نمایش این انتقال از یک بازوی دنبالکننده SO-101 استفاده شد که وظیفه جابهجایی مکعبهای ۴۴ میلیمتری را داشت. جریان کار با ایجاد یک خط مبنا (Baseline) در CPU شروع شد تا اطمینان حاصل شود ربات میتواند مکعبها را بهدرستی روی هم بچیند.
جزئیات اعتبارسنجی تسک
برای بازوی SO-101، موفقیت با دو شرط اندازهگیری شده تعریف میشود که پس از استقرار مکعبها بررسی میگردند:
- خطای افقی: خطای مرکز به مرکز
xy_err ≤ 0.015 m. - جدایش عمودی: فاصله بین مراکز مکعبها بین
0.035 mتا0.055 m(که نشاندهنده لبه یک مکعب با کمی فضای خالی برای استقرار است).
شبیهسازی از نرخ کنترل ۵۰ فریم بر ثانیه با ۱۰ زیرگام فیزیکی در هر فریم استفاده میکند که منجر به گام زمانی ۰.۰۰۲ ثانیه میشود. تطبیق این گام زمانی بین CPU و GPU حیاتی است؛ در غیر این صورت، مقایسههای برابری و سیاستهای یادگرفتهشده بهدلیل عدم تطابق نرخ اکشنها شکست میخورند.
در مدل MJCF، مکعبها بهعنوان جعبههایی با ابعاد نصف (half-extents) ۰.۰۲۲ تعریف شدهاند که لبههای ۴۴ میلیمتری را ایجاد میکند. پایه بازو در مبدأ قرار دارد و در امتداد محور +X پیش میرود، در حالی که مکعبها در امتداد محور Y چیده شدهاند. برای کسانی که از مخزن همراه استفاده میکنند، تابع resolve_pick_place_scene() این فرآیند را با کپی کردن بازوی Menagerie و پر کردن مختصات از پروفایل ربات خودکار میکند. همچنین نسخه reBot در دسترس است که نیاز به اعتبارسنجی جداگانه دارد و از محدودیتهای ظرفیت متفاوتی (nconmax=256 و njmax=500) استفاده میکند.
پس از اعتبارسنجی CPU، مدل با استفاده از mjw.put_model به GPU منتقل میشود. در مثال SO-101، سیستم از یک دنیا به ۲۰۴۸ وضعیت مستقل GPU مقیاس مییابد.
مکانیزمهای پیادهسازی
انتقال API از MuJoCo به MJWarp بسیار ساده و بهینه شده است:
mujoco.MjModelبهmjw.put_model(mjm)تبدیل میشود تا یک مدل دستگاه ایجاد کند.mujoco.MjDataاز طریقmjw.put_data(mjm, mjd, ...)برای دستهبندی وضعیتهای موجود یاmjw.make_data()برای وضعیتهای جدید مدیریت میشود.mujoco.mj_stepباmjw.step(m, d)جایگزین میشود که هر دنیای موجود در دسته را پیش میبرد.- آرایههای میزبان (مانند
mjd.ctrl) با آرایههای دستهای دستگاه با شکل(nworld, nu)جایگزین میشوند.
هنگام مقداردهی اولیه GPU، توسعهدهندگان میتوانند qpos و qvel و ctrl را با استفاده از wp.copy کپی کنند. برای حفظ بُعد پیشرو دنیا، وضعیت میزبان باید به صورت mjd.qpos[None, :] ایندکس شود. همچنین mjw.put_model() بهعنوان یک بررسی سازگاری عمل کرده و در صورت استفاده از ویژگیهای پشتیبانینشده، خطا میدهد.
مدیریت حافظه در این مهاجرت بسیار حساس است. توسعهدهندگان باید ظرفیتهای مشخصی را برای تماسها و محدودیتها تعریف کنند:
- nworld: تعداد کل محیطهای موازی.
- nconmax: تماسهای مورد انتظار در هر دنیای مجزا (ظرفیت کلی
nconmax * nworldاست). - naconmax: حداکثر تماسهای جهانی در تمام محیطها (اگر تعریف شود، اولویت دارد).
- njmax: حد بالای سخت برای محدودیتها در هر دنیا.
برای پروفایل SO-101، ظرفیتهای اولیه nconmax=128 و njmax=300 است. اگر شبیهسازی از این بافرها فراتر رود — مثلاً لحظهای که هر دو فک و میز با مکعب تماس دارند — سیستم هشدار "narrowphase overflow" میدهد.
انویدیا توصیه میکند از ابزار mjwarp-testspeed --measure_alloc برای اندازهگیری مصرف واقعی و بهینهسازی این محدودیتها جهت صرفهجویی در حافظه GPU استفاده شود. تنها mjw.put_data بهطور مستقیم خطا میدهد؛ سایر سرریزها در Data.overflow علامتگذاری میشوند تا کاربر پس از یک گام آنها را بخواند. علاوه بر این، nccdmax و naccdmax را میتوان برای کاهش تخصیص بافر CCD در صورت پایین بودن تعداد تماسها تنظیم کرد.
بهینهسازی برای توان عملیاتی
برای به حداکثر رساندن عملکرد، MJWarp از قابلیت CUDA graph capture استفاده میکند. از آنجایی که mjw.step شامل تعداد زیادی اجرای کوچک هسته است، ثبت اینها در یک گراف از طریق wp.ScopedCapture() به GPU اجازه میدهد توالی را بدون سربار تکراری ارسال (Dispatch) از میزبان پایتونی بازپخش کند.
اندازهگیری این عملکرد نیازمند همگامسازی سختگیرانه است. بهدلیل ناهمگام بودن اجراهای GPU، یک تایمر ساده فقط سرعت صفبندی پایتون را اندازه میگیرد. برای بهدست آوردن عدد دقیق گامهای دنیایی در ثانیه، توسعهدهندگان باید:
۱. گرم کردن: اجرای ۱۰ مورد اول برای مدیریت کامپایل هسته و تخصیص حافظه.
۲. همگامسازی: فراخوانی wp.synchronize() دقیقاً قبل و بعد از محدوده زمانسنجی.
این کار محاسبه توان عملیاتی کل را ممکن میکند: (total_steps * nworld) / elapsed_time. نتایج بسته به سختافزار متفاوت است، اما استفاده از یک مطالعه مقیاسپذیری (تغییر اندازه دستهها از ۱ تا ۸۱۹۲) کمک میکند تا نقطهای که محدودیتهای حافظه یا محاسبات، سودِ افزودن دنیاهای بیشتر را کاهش میدهند، شناسایی شود.
اکوسیستم گستردهتر
MJWarp بهتنهایی عمل نمیکند و بهعنوان بکاند برای چندین دستورالعمل آموزشی سطح بالا عمل میکند:
- mjlab: یک API مدیریتی که MJWarp را مستقیماً به PyTorch متصل میکند.
- MuJoCo Playground: از MJX با پیادهسازی Warp (
impl='warp') استفاده میکند. - Isaac Lab: از طریق چارچوب Newton یکپارچه میشود که API چند-حلکننده و پشتیبانی USD را فراهم میکند.
این رویکرد لایهبندی شده به توسعهدهنده اجازه میدهد ابزار مناسب را انتخاب کند: MuJoCo CPU برای MPC تکرباتی یا کنترل از راه دور، MJWarp برای حداکثر توان عملیاتی فیزیک خام، و Newton برای یکپارچگی کامل با Isaac Lab.
تحلیل: تغییر به سمت هوش مصنوعی فیزیکی
برای مهندسان رباتیک، این یک تغییر بنیادین در چرخه توسعه است. توانایی اجرای بیش از ۲۰۰۰ شبیهسازی بهطور موازی به این معناست که جمعآوری تجربه — کندترین بخش یادگیری تقویتی — دیگر گلوگاه اصلی نیست.
با نگه داشتن دادههای شبیهسازی و یادگیری روی یک دستگاه واحد، MJWarp سربار هزینهبر انتقال داده از طریق PCIe را که معمولاً خط لولههای sim-to-real را مختل میکند، حذف میکند. این امر چشمانداز «هوش مصنوعی فیزیکی» را دستیافتنیتر میکند، زیرا مدلها میتوانند پیش از لمس هر موتور فیزیکی، در معرض مقادیر عظیمی از تنوع مصنوعی قرار گیرند. در همین راستا، انویدیا در حال توسعه ابزارهایی است که مدیریت این چرخه را سادهتر کند؛ برای مثال استفاده از یک فایل YAML در OSMO میتواند کل چرخه هوش مصنوعی فیزیکی را سازماندهی کند.
گام بعدی شما
توسعهدهندگان میتوانند با نصب mujoco-warp (نسخه ۱.۱۵ به بالا برای اجرای قطعی در GPU) و اجرای آموزشهای Colab، این جریان کار را آزمایش کنند. تکامل بعدی در این پشته، یکپارچهسازی چارچوب Newton است که از MuJoCo Warp بهعنوان حلکننده اجسام صلب (newton.solvers.SolverMuJoCo) استفاده خواهد کرد. Newton داراییهای چند-فرمت، حلکنندههای قابل تعویض و ابزارهای پیشرفته سنسور/IK را اضافه خواهد کرد و شکاف بین شبیهسازی خام و هوش مصنوعی قابل استقرار را بیشتر پر میکند.



گفتگو