تصور کنید یک باگ بحرانی در API ردیابی سفارشات، پیش از آنکه برنامهنویس حتی لپتاپ خود را باز کند، شناسایی و اصلاح شود. این سناریو اکنون با ادغام OpenTelemetry و عاملهای کدنویس (Coding Agents) ممکن شده است تا سیستمی ایجاد شود که خطاهای سرور را بهطور خودکار شناسایی، بررسی و ترمیم میکند. این یک سیستم حلقه-بسته (Closed-loop) است که اجازه میدهد توسعهدهندگان فرآیند تشخیص، تحقیق و رفع خطا را کاملاً خودکار کنند.
بسیاری از توسعهدهندگان به مشاهدهپذیری (Observability) — که شبیه داشتن جعبهسیاه در هواپیماست تا بعد از حادثه بفهمیم چه رخ داده — بهعنوان فعالیتی غیرفعال نگاه میکنند؛ یعنی فقط لاگ میگیرند و امیدوارند هنگام خرابی مفید باشند. اما در پروژهای که به نقل از DataTalksClub در جریان Zoomcamp ابزارهای توسعه AI منتشر شد، چارچوبی ساخته شده تا این سیگنالهای غیرفعال به محرکهای فعال برای تعمیرات مبتنی بر هوش مصنوعی تبدیل شوند. این پروژه یک برنامه ساده ردیابی سفارش با پایگاهداده SQLite را به سیستمی پیچیده تبدیل کرد که متریکها، لاگها و ردپاها (Traces) را جمعآوری کرده، در Grafana بصریسازی میکند و یک عامل کدنویس را برای رفع مشکل فرا میخواند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، دسترسی مدل به دادههای واقعی محیط عملیاتی، دقت آن را بهشدت بالا میبرد. در اینجا، وقتی سرور خطای ۵۰۰ میدهد، بهجای اینکه برنامهنویس ساعتها در لاگها جستوجو کند، سیستم بهطور خودکار ردپای خطا را جمعآوری کرده، علت ریشهای را مییابد و اصلاحیه را اعمال میکند. این تغییر، نقش هوش مصنوعی را از یک «تولیدکننده کد» به یک «همتیمی عملیاتی» تغییر میدهد. با این حال، اتکای کامل به این ابزارها میتواند چالشهای جدیدی ایجاد کند؛ چنانکه در بررسی اثرات جایگزینی مهندسان با AI در رفع خطاها اشاره کردیم، فقدان تجربه عملی انسانی ممکن است منجر به ایجاد یک «بدهی درک فنی» در تیمهای مهندسی شود.
مشکل عیبیابی دستی
یک برنامه ممکن است در زمان توسعه عالی عمل کند اما در محیط عملیاتی شکست بخورد. برای یک API ردیابی سفارش، شکست ممکن است ساده باشد: درخواست GET /api/orders/express-1002 خطای سرور میدهد. بدون مشاهدهپذیری، روند کار خستهکننده است: چیزی میشکند، توسعهدهنده لاگها را چک میکند، خطا را میگردد، سعی میکند آن را بازتولید کند، کد را مییابد، اصلاح میکند، برنامه را ریاستارت میکند و دوباره تست میکند.
این فرآیند دستی با رشد سیستم دشوارتر میشود. هرچه تعداد میکروسرویسها و پیچیدگی کدها بیشتر شود، یافتن نقطه شکست سختتر میگردد. هدف این پروژه ساخت گردشکاری بود که در آن تلهمتری تمام این مراحل را به هم متصل کند و مسیر را از شناسایی به بررسی، ترمیم و در نهایت اعتبارسنجی تغییر دهد تا نیاز به دخالت دستی در مراحل اولیه حذف شود.
خط لوله مشاهدهپذیری
این معماری بر یک پشته تلهمتری تخصصی تکیه دارد تا زمینه لازم را برای عامل هوشمند فراهم کند. فرآیند با ابزارگذاری FastAPI با استفاده از OpenTelemetry آغاز میشود که مسیرهای HTTP، کدهای وضعیت و متریکهای درخواست را ثبت میکند. برای مثال، سیستم تفاوت بین یک درخواست موفق مانند GET /api/orders/standard-1001 (200 OK) و یک سفارش گمشده مانند GET /api/orders/standard-1002 (404 Not Found) را بهطور دقیق تشخیص میدهد.
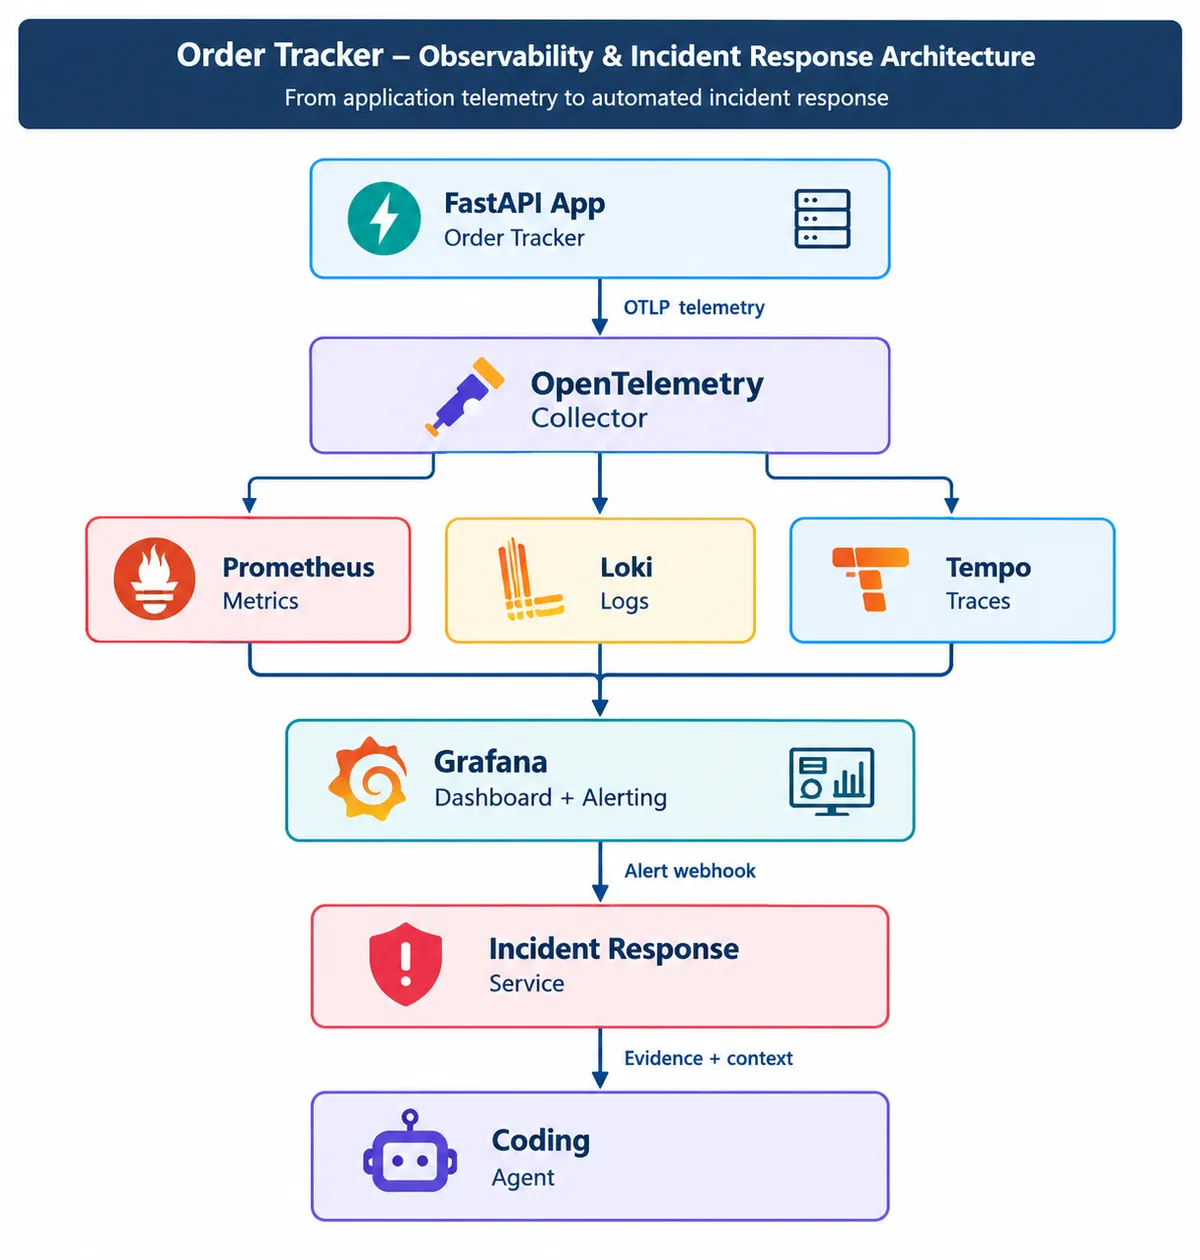
این سیگنالها از طریق یک OpenTelemetry Collector عبور میکنند که بهعنوان خط لوله مرکزی عمل میکند. این Collector دادههای OTLP را دریافت کرده و آنها را به سه مقصد ذخیرهسازی مجزا هدایت میکند:
- Prometheus: مدیریت متریکها برای اعلام اینکه «چیزی در حال رخ دادن است» (مثلاً افزایش نرخ خطاهای ۵۰۰).
- Loki: ذخیره لاگها برای توضیح اینکه «چه اتفاقی افتاده است» (ثبت جزئیات خطا در کنسول).
- Tempo: مدیریت ردپاها برای نمایش اینکه «دقیقاً کجا اتفاق افتاده است» (ردیابی درخواست از ورودی تا لایه دیتابیس).
Grafana بهعنوان لایه بصریسازی و موتور اصلی هشدار عمل میکند. بر اساس مستندات پروژه، یکی از کلیدیترین درسهای آموخته شده این بود که ترکیب این سه سیگنال (متریک، لاگ و ردپا)، زمینه عملیاتی بسیار بیشتری نسبت به تکیه بر یک سیگنال واحد فراهم میکند. سیستم بهگونهای تنظیم شده که خطاهای ۴۰۴ را — که در واقع خطاهای سمت کلاینت هستند و نقص فنی سرور محسوب نمیشوند — نادیده بگیرد و فقط برای خطاهای سری ۵xx (خطاهای داخلی سرور) گردشکار حادثه را فعال کند.
از هشدار تا اصلاح خودکار
وقتی خطای ۵xx شناسایی میشود، Grafana یک بسته داده (Payload) را از طریق نقطه اتصال POST /alerts به یک سرویس پاسخ به حوادث اختصاصی میفرستد. این سرویس، هشدار خام را به یک بسته بررسی جامع تبدیل میکند که شامل نقطه اتصال دقیق (Endpoint)، وضعیت خطا، لاگهای مرتبط و ردپاهای مربوطه است.
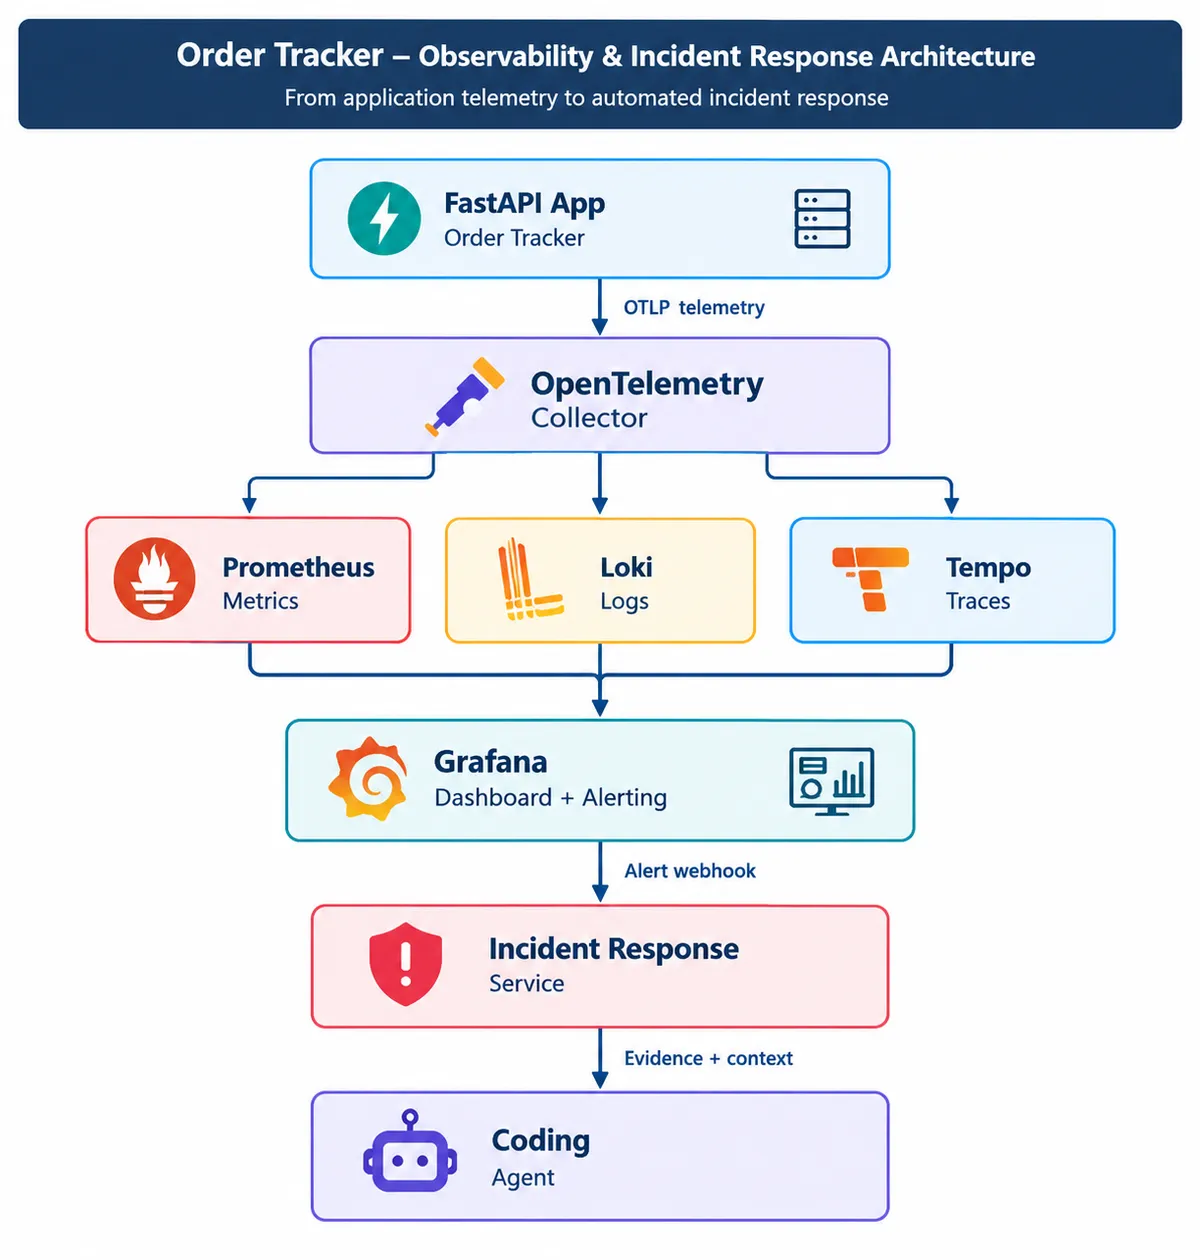
این بسته سپس از طریق Codex CLI به عامل کدنویس داده میشود. چون عامل بهجای یک پیام خطای مبهم، شواهد واقعی تلهمتری را دریافت میکند، میتواند دقیقاً نقطه شکست منطقی را در کد شناسایی کند. زنجیره عملیاتی به این شکل است: شناسایی ۵xx $ \rightarrow $ هشدار Grafana $ \rightarrow $ سرویس پاسخ به حادثه $ \rightarrow $ جمعآوری شواهد $ \rightarrow $ بررسی توسط عامل $ \rightarrow $ شناسایی علت ریشهای $ \rightarrow $ اعمال اصلاحیه $ \rightarrow $ ریاستارت برنامه $ \rightarrow $ تایید رفتار.
مطالعه موردی: باگ سفارش اکسپرس
در یک تست واقعی، سیستم باگی را در جستوجوی سفارشات اکسپرس شناسایی کرد. پیادهسازی مشکلدار، تاریخ تحویل تخمینی را با استفاده از کد زیر محاسبه میکرد:estimated_at = placed_at.replace(day=placed_at.day + 2)
این منطق به اشتباه فرض میکند که روز حاصل (روز فعلی + ۲) حتماً در همان ماه قرار دارد. برای سفارشی که در اواخر ماه (مثلاً روز ۲۹ یا ۳۰) ثبت شده باشد، این فرض شکست میخورد زیرا مقدار day از تعداد روزهای ماه فراتر میرود و این امر منجر به بروز خطای سرور میشود. عامل هوش مصنوعی این خطای مرزی (Boundary Error) را تشخیص داد و آن را با محاسبات صحیح تاریخ جایگزین کرد:estimated_at = placed_at + timedelta(days=2)
این تغییر اجازه میدهد پیادهسازی datetime در پایتون، مرزهای ماه و سال را بهدرستی مدیریت کند. گردشکار مشاهدهپذیری، مسیری مستقیم و سریع از شکست HTTP در محیط عملیاتی به خط خاصی از کد که نیاز به تغییر داشت، ایجاد کرد.
حلقه اعتبارسنجی
آخرین و حیاتیترین مرحله، اعتبارسنجی است. گردشکار با اعمال اصلاحیه متوقف نمیشود؛ بلکه سیستم باید برنامه را ریاستارت کرده و تایید کند که خطای ۵xx دیگر رخ نمیدهد و مشکل واقعاً حل شده است.
این یک چرخه چهار مرحلهای میسازد: شناسایی $ \rightarrow $ بررسی $ \rightarrow $ اصلاح $ \rightarrow $ تایید. بدون مرحله نهایی اعتبارسنجی، تغییرات خودکار کد ریسک ایجاد رگرسیونهای (Regressions) جدید در محیط عملیاتی را دارند. اتوماسیون برای اینکه بتواند در محیطهای حساس قابلاعتماد باشد، باید لزوماً به یک مرحله تایید متصل باشد.
تاثیر عملیاتی و پشته فناوری
این رویکرد مفروضات بنیادی DevOps را تغییر میدهد. ثابت شد که عاملهای هوش مصنوعی زمانی بیشترین اثر را دارند که «زمینه عملیاتی» (Operational Context) داشته باشند. عاملی که کورکورانه از او خواسته شود «باگ را رفع کن»، بسیار غیرقابلاعتمادتر از عاملی است که یک ردپای دقیق و تکهای از لاگهای یک شکست واقعی را دریافت میکند.
خلاصه فنی پروژه
- API و محیط اجرا: FastAPI / Python
- پایگاهداده: SQLite
- تلهمتری: OpenTelemetry (ابزارگذاری و Collector)
- ذخیرهسازی: Prometheus (متریک)، Loki (لاگ)، Tempo (ردپا)
- بصریسازی: Grafana
- زیرساخت: Docker / Docker Compose
- ترمیم: Codex CLI
نتایج اعتبارسنجی
گردشکار تکمیلشده از طریق مجموعهای از تکالیف و تستها تایید شد:
- Q1 (تست سلامت): بازگشت کد ۲۰۰ (موفق).
- Q2 (سفارش موجود): بازگشت کد ۲۰۰ (موفق).
- Q3 (سفارش گمشده): بازگشت کد ۴۰۴ (درست).
- Q4 (هشدار ۵xx): تایید رفتار عادی برای ۴۰۴ها (عدم ارسال هشدار برای خطاهای کلاینت).
- Q5 (گردشکار حادثه): تکمیل موفقیتآمیز فرآیند از هشدار تا اصلاح.
- Q6 (باگ سفارش اکسپرس): شناسایی دقیق علت ریشهای و رفع باگ تاریخ.
برای یک توسعهدهنده، این به معنای رهایی از چرخه خستهکننده بازتولید محلی باگها است. سیستم جمعآوری شواهد را مدیریت میکند و انسان را از نقش یک «کارآگاه در جستوجوی سوزنی در انبار کاه» به نقش یک «بازبین اصلاحات پیشنهادی AI» ارتقا میدهد.
گام بعدی شما
- بررسی مستندات OpenTelemetry برای یادگیری نحوه استخراج ردپاهای (Traces) دقیق از برنامههای پایتونی.
- آزمایش اتصال هشدارهای Grafana به وبهوکهای (Webhooks) خارجی برای خودکارسازی واکنش به حوادث.
- مطالعه درباره Codex CLI برای درک نحوه تعامل عاملهای کدنویس با فایلهای سیستم.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو