عاملهای هوش مصنوعی شما در هر ثانیه از اجرای خود، در سکوت کامل در حال نوشتن مجموعهدادههای آموزشیشان هستند. اکثر تیمها با این تلهمتری صرفاً بهعنوان لاگهایی برای عیبیابی (Debugging) برخورد میکنند، اما Overmind استدلال میکند که این ردپاها (Traces) ارزشمندترین دارایی برای عبور از مدلهای با کاربرد عمومی هستند. هر سیستم عاملمحور (Agentic) میتواند دادههای آموزشی خود را تولید کند؛ جریانی از ورودیها و خروجیها — شامل پرامپت، فراخوانی ابزارها، مراحل استدلال و پاسخ نهایی — یک ردپاست که اکثر تیمها هرگز از آن استفاده نمیکنند.
ساخت یک عامل با کارایی بالا، بیش از آنکه به مدل بنیادی (Foundation Model) که فراخوانی میکنید وابسته باشد، به دادههای رفتاری اختصاصی (Proprietary Behavioral Data) بستگی دارد که در اختیار دارید. در حالی که مدلهای عمومی در تاریخ پیشآموزش (Pre-training) خود منجمد شدهاند، سیستمی که از شکستهای عملیاتی خود یاد میگیرد، در لحظه تکامل مییابد. این تغییر، مزیت رقابتی را از مهندسی پرامپت به مهندسی خط لوله دادهها (Data Pipeline Engineering) منتقل میکند. یک مجموعه داده آموزشی، محدودتر از تلهمتری خام است: این یک مجموعه منتخب از اجراهاست که بر اساس یک مشخصات فنی امتیازدهی شده و بهطور خاص برای کارهای تنظیم دقیق (Fine-tuning) طراحی شده است.
طبق راهنمایی که در ۴ سپتامبر ۲۰۲۶ منتشر شد، فرآیند تبدیل تلهمتری خام به یک مجموعه آموزشی، نیازمند یک خط لوله سختگیرانه در چهار مرحله است. این یک خروجی یکباره نیست، بلکه یک چرخه هفتگی از بهینهسازی و ارزیابی است. هدف این است که از تلهمتری خام به فرمتی ماشینخوان حرکت کنیم که در آن هدف و نتیجه به هر اجرای سیستم متصل شده باشد.
مرحله ۱: ثبت کامل ردپاها
هر اجرای عامل، جریانی از ورودیها، فراخوانی ابزارها، مراحل استدلال و پاسخهای نهایی را ساطع میکند. برای اینکه این دادهها مفید باشند، صنعت در حال همگرایی به سمت کنوانسیونهای معنایی OpenTelemetry's GenAI است. این استاندارد تضمین میکند که نام مدل، تعداد توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — و تأخیر (Latency)، بهعنوان فیلدهای درجه اول ثبت شوند، نه چیزی که هر تیم از ابتدا برای خودش اختراع کند.
این استانداردسازی حیاتی است؛ زیرا طرحی از ردپا (Trace Schema) که هر بار با تغییر تامینکننده ابزارهای نظارتی (Observability Vendors) باید بازطراحی شود، طرحی است که هیچکس اعتماد کافی برای ساخت یک مجموعه داده روی آن را ندارد. گروه کاری OpenTelemetry GenAI از سال ۲۰۲۴ در حال ساخت این ویژگیهای استاندارد (Span Attributes) بوده است و اجرای ابزارها (Tool Execution) را بهعنوان یک فیلد اصلی پوشش داده است.
Overmind این فرآیند را با پوشاندن رابط فراخوانی مدل ساده میکند. یک دستور overmind.init() تمام فراخوانیها در OpenAI، Anthropic، Google Gemini و Agno را ثبت میکند. این ابزار ورودیها، خروجیها، تأخیر، تعداد توکنها و خطاها را بدون نیاز به سیمکشیهای اضافی از سوی توسعهدهنده لاگ میکند. بدون ثبت خودکار و کامل، مراحل بعدی نمونهگیری و برچسبگذاری فاقد مواد خام لازم برای دستیابی به معنای آماری (Statistical Significance) خواهند بود.
مرحله ۲: نمونهگیری استراتژیک
برچسبگذاری تکتک اجراها غیرممکن و ناکارآمد است. بیشتر کارهایی که یک عامل در یک هفته انجام میدهد، معمولی و پیشپاافتاده هستند و بررسی همه آنها چیزی به تیم برچسبگذاری یاد نمیدهد که قبلاً ندانسته باشد. وظیفه در این مرحله، انتخاب اجراهایی است که ارزش توجه انسان را داشته باشند.
تیمها باید از سه استراتژی خاص نمونهگیری برای به حداکثر رساندن سیگنالها استفاده کنند:
- نمونهگیری تصادفی (Random Sampling): یک خط مبنای صادقانه از آنچه عامل در یک روز عادی انجام میدهد فراهم میکند. این مورد باید در هر چرخه بهعنوان «گروه کنترل» اجرا شود تا سایر نمونهها با آن مقایسه شوند.
- نمونهگیری لایهای (Stratified Sampling): پوشش عمدی مواردی را تضمین میکند که شما از قبل به آنها اهمیت میدهید. مثالها شامل یک دلیل خاص برای استرداد وجه، یک سطح خاص از مشتریان، یا ابزاری است که مدام دچار Timeout میشود. زمانی از این روش استفاده کنید که یک بخش شناختهشده مهمتر از میانگین اجراها باشد.
- نمونهگیری وزندار بر اساس شکست (Failure-Weighted Sampling): اجراهایی را که دارای پرچم خطا (Error Flags) یا امتیازات رضایت پایین هستند، در اولویت قرار میدهد. این موارد بیشترین اطلاعات را در خود دارند و بیشترین سیگنال را به ازای هر اجرا فراهم میکنند.
برای یک عامل استرداد وجه که ۵۰,۰۰۰ اجرای هفتگی دارد، استخراج حدود ۵۰۰ مورد منطقی است: یک برش تصادفی بهعلاوه هر اجرای که به خطا خورده یا امتیاز رضایت پایینی گرفته است. این فرآیند باید طبق یک تقویم زمانی — در ابتدا بهصورت هفتگی — اجرا شود، نه بهعنوان یک خروجی یکباره که فقط پس از شکستن چیزی در محیط عملیاتی انجام میگیرد.
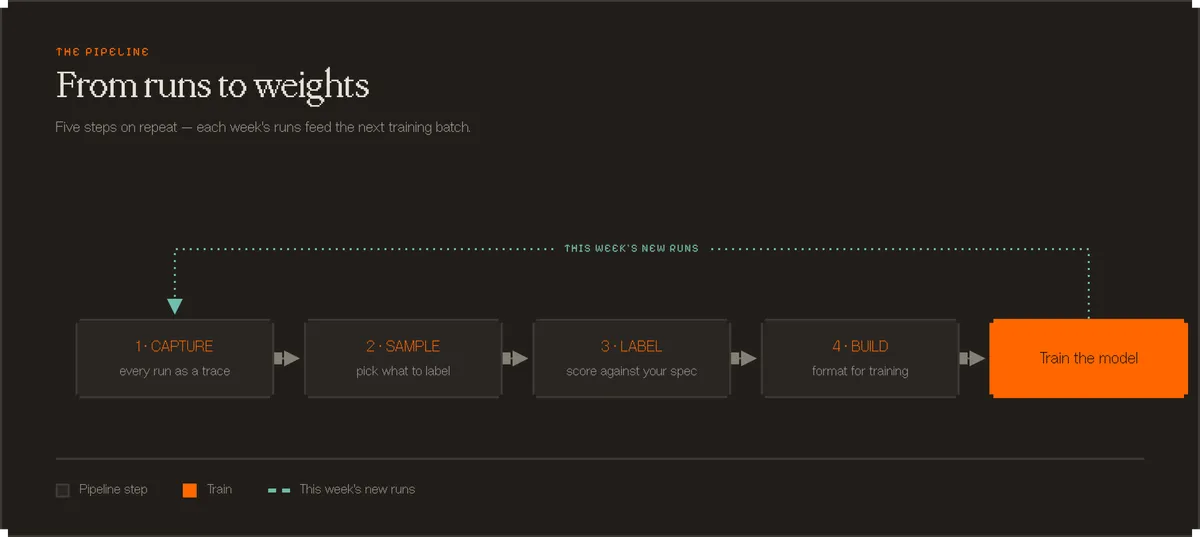
مرحله ۳: برچسبگذاری مبتنی بر دستورالعمل
برچسبگذاری بر اساس «حس کلی» (Gut Feeling) در مقیاس بالا شکست میخورد، زیرا استانداردهای بازبینها در طول زمان تغییر میکند. سریع مرور کردن یک اجرا و تصمیمگیری درباره اینکه «به نظر خوب میرسد»، برای صد اجرا جواب میدهد اما در ده هزار اجرا از هم میپاشد. راهکار، تعریف یک مشخصات (Specification) صریح از اینکه «خوب» چه معنایی دارد و امتیازدهی به هر اجرای نمونهبرداری شده بر اساس آن مشخصات است.
کدبیس عامل شما در حال حاضر اکثر این الزامات را رمزگذاری کرده است. با خواندن کد، میتوانید خروجیهایی که باید تولید کند، ابزارهایی که اجازه فراخوانیشان را دارد، بررسیهایی که قبل از اقدام انجام میدهد و مسیرهایی که باید یا نباید طی کند را شناسایی کنید.
برای یک عامل استرداد وجه، یک دستورالعمل (Rubric) مشتق شده از کد میتواند شامل موارد زیر باشد:
- استرداد در چارچوب شرایط: مبلغ باید در محدوده ارزش سفارش و بازه زمانی ۳۰ روزه باشد. (نقض: استرداد وجه برای سفارشی که ۹۰ روز پیش ثبت شده است).
- عدم ابداع قوانین: عامل فقط باید به شرایط استرداد منتشر شده استناد کند. (نقض: نقل قول از یک قانون مرجوعی که وجود خارجی ندارد).
- ارجاع اختلافات: تراکنشهای برگشتی (Chargebacks) باید به یک انسان سپرده شوند. (نقض: استرداد خودکار وجه برای یک تراکنش مورد اختلاف).
برای مقیاسپذیری، تکنیک مدل زبانی بهمثابه داور (LLM-as-judge) اکنون پیشفرض عملیاتی است، زیرا ارزیابی دستی میزان مفید بودن در دادههای آموزشی بسیار گران شده است. با این حال، محدودیتهایی وجود دارد: تحقیقاتی که داوران LLM را با دادههای مربوط به مرتبط بودن (Relevance) که توسط انسان برچسبگذاری شدهاند مقایسه کرد، همبستگی رتبهای قوی اما توافق متوسطی در مورد برچسبهای دقیق یافت. دقت در دستهبندیهای ظریف در مقایسه با تصمیمات سادهی «قبول/رد»، بهشدت افت میکند.
Overmind این موضوع را از طریق شش نوع ارزیاب، از بررسیهای قطعی (Deterministic) تا داوران LLM، پیادهسازی کرده است. هر اجرا قبل از اینکه نتیجه آن به حساب بیاید، در برابر یک خط مبنا امتیازدهی میشود. اجراهایی که در یک معیار شکست میخورند — صرفنظر از اینکه مشتری بعد از آن روی چه چیزی کلیک کرده است — ارزشمندترین دادههای آموزشی موجود هستند.
مرحله ۴: ساخت مجموعه داده
اجراهای برچسبگذاری شده باید بر اساس روش آموزش مورد نظر فرمت شوند. الزامات بین دو مسیر اصلی بهشدت متفاوت است:
تنظیم نظارتشده (SFT):
- اجراهای نگه داشته شده: فقط مواردی که از تمام معیارها عبور کردهاند.
- محتوای ردیف: یک جفت ورودی-خروجی از رفتاری که میخواهید تکرار شود.
- هدف مدل: تقلید از مجموعهای ثابت از مثالهای خوب.
- الزام برچسب: یک حکم قبول/رد برای هر معیار.
یادگیری تقویتی (RL):
- اجراهای نگه داشته شده: اجراهای نمونهبرداری شده به همراه امتیازات معیار متصل به آنها.
- محتوای ردیف: اجرا بهعلاوه امتیازات، که بهعنوان سیگنال پاداش (Reward Signal) استفاده میشود.
- هدف مدل: تولید اجراهایی که امتیاز بالاتری بگیرند.
- الزام برچسب: یک امتیاز قابل استفاده برای هر معیار، نه فقط قبول/رد.
این مرحله اهمیت مدلهای کوچک و تخصصی را برجسته میکند. تحقیقات Overmind استدلال میکند که هر فراخوانی مدل در یک گردش کار عاملمحور، منبعی طبیعی از دادههای آموزشی باکیفیت است، زیرا پرامپتها محدود و بهخوبی تعریف شدهاند و سیگنال قبول/رد شفاف است، برخلاف دادههای چت باز و نامحدود. تنظیم دقیق یک مدل متخصص روی این الگوها به سیستم اجازه میدهد با هر اجرای عملیاتی بهبود یابد، بهجای اینکه در حالت پیشآموزش منجمد بماند. در این راستا، بهینهسازی لایههای حافظه نیز برای کاهش هزینههای انتقال داده در عاملهای پیچیده حیاتی است، مشابه آنچه لایه حافظه funes برای کاهش هزینه انتقال عاملهای کدنویس به ارمغان آورد.
این خط لوله شکافی را پر میکند که ابزارهای نظارتی سنتی ایجاد کردهاند. در حالی که پلتفرمهایی مانند Datadog ترویج ردپاها را به مجموعهدادههای «طلایی» (Golden Datasets) تحت کنترل نسخه و لایهبندی متادیتای ارزیابی روی آنها تشویق میکنند، اما دوختن واقعی ردپاها به دادههای آموزشی اغلب در صفحات گسترده دستی (Spreadsheets) و اسکریپتهای یکباره اتفاق میافتد. Overmind این چرخه «بهینهسازی-ارزیابی-پذیرش» را بهطور کامل و سرتاسری خودکار میکند. در سیستمهای فیزیکی و رباتیک نیز چالشهای مشابهی در انتقال دادههای آموزشی وجود دارد که استفاده از استریمینگ دادهها میتواند گلوگاههای انتقال را برطرف کند.
برای متخصصان، این بدان معناست که هدف دیگر فقط «مانیتورینگ» نیست، بلکه «برداشت محصول» (Harvesting) است. تیمی که دقیقترین مجموعه داده برچسبگذاری شده از شکستهای عامل خود را در اختیار داشته باشد، بهناچار از کسانی که به بهروزرسانیهای عمومی مدلهای بنیادی تکیه میکنند، پیشی خواهد گرفت. تمایز در هوش مصنوعی عاملمحور بهطور فزایندهای در دادههای رفتاری اختصاصی نهفته است، نه در اینکه کدام مدل بنیادی را فراخوانی میکنید.
برای شروع، شما باید اولین مرحله برچسبگذاری را برای یک ماه بهصورت دستی انجام دهید. این سریعترین راه برای کشف این است که معیارهای واقعی شما چیست، در مقابل آنچه تصور میکردید هنگام نوشتن چکلیست اولیه بود.
گام بعدی شما
- اولین مرحله برچسبگذاری را برای یک ماه بهصورت دستی انجام دهید تا معیارهای واقعی سیستم خود را کشف کنید.
- استراتژی نمونهگیری وزندار بر اساس شکست را برای شناسایی نقاط کور مدل پیاده کنید.
- یک مدل زبانی کوچک (SLM) را روی دادههای استخراجشده از ردپاهای موفق SFT کنید تا هزینه استنتاج را کاهش دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو