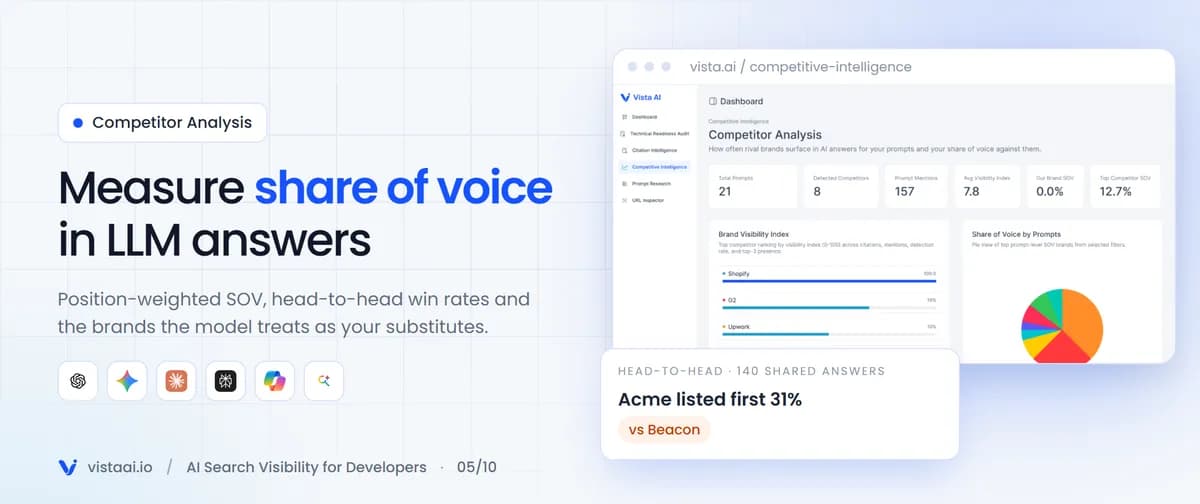
اگر امروز برای تحلیل حضور برندتان در ChatGPT فقط به تعداد دفعات ذکر نام اکتفا میکنید، احتمالاً دادههای گمراهکنندهای در دست دارید. اندازهگیری اینکه آیا یک برند در ChatGPT «دیده میشود» یا خیر، معیاری ضعیف است؛ برتری رقابتی واقعی در این است که بدانید مدل زبانی دقیقاً چند بار شما را نسبت به رقیبتان توصیه کرده و در چه جایگاهی قرار داده است.
این مسئله هسته اصلی مفهوم «سهم صدا» (Share of Voice یا SOV) است؛ معیاری که دادههای دیدهشدن در هوش مصنوعی را به ابزاری برای تصمیمات استراتژیک تبدیل میکند. طبق مستندات این چارچوب، یک متدولوژی عملی برای محاسبه SOV با استفاده از کتابخانه pandas (پانداس) — که شبیه به یک اکسل بسیار قدرتمند برای برنامهنویسان است و اجازه میدهد حجم عظیمی از دادهها را با سرعت بالا دستهبندی و تحلیل کنند — ارائه شده است تا پاسخهای خام مدلهای زبانی بزرگ (LLM) به دادههای رقابتی قابل اجرا تبدیل شوند.
این رویکرد در زمانی ارائه میشود که کسبوکارها برای درک ردپای خود در عصر هوش مصنوعی زاینده (Generative AI) دستوپنجه نرم میکنند. همانطور که در تحلیل قبلی ما دربارهی شکست عاملهای هوش مصنوعی در مقیاس واقعی (فراتر از مدل زبانی) اشاره کردیم، دیدهشدن صرف کافی نیست، بلکه کیفیت و جایگاه این ذکر نام است که اهمیت دارد. تصور کنید برند شما در لیستی از ۱۰ ابزار ذکر شده، اما همیشه نفر آخر است؛ شما «دیده شدهاید»، اما در واقع در حال شکست خوردن هستید.
ورودی دادهها و ساختار
برای محاسبه این معیارها، سیستم فرض میکند جدولی از پاسخها در دسترس است. بر اساس مستندات فنی، دادههای ورودی باید به گونهای باشند که برای هر جفت (پاسخ، برند) یک ردیف وجود داشته باشد. این کار از طریق تخت کردن (Flattening) جدول امتیازات با استفاده از یک Join در SQL بین اجراها (runs)، پرامپتها، امتیازها و برندها انجام میشود.
به طور مشخص، دادهها برای ۲۸ روز گذشته فیلتر میشوند. هر پاسخ در برابر تمام برندهای رصدشده امتیازدهی میشود؛ حتی اگر برندی در یک پاسخ خاص ذکر نشده باشد، ردیفی با مقدار mentioned = 0 برای آن حفظ میشود. این دقت در ساختار دادهها تضمین میکند که مخرج کسر در محاسبات SOV از نظر ریاضی درست باقی بماند و نتایج دچار خطا نشوند.
اندازهگیری سهم صدا
این چارچوب برای حل مشکل دیدهشدن، سه لایه اندازهگیری متمایز را اجرا میکند. لایه اول «سهم ذکر» (Mention Share) است که سهم کل دفعات ذکر یک برند را در تمام پاسخها محاسبه میکند. اما این معیار به راحتی قابل تحریف است؛ زیرا برندی که صرفاً در متن به صورت گذرا ذکر شده است (مثلاً: «همچنین ابزارهایی مثل X هم وجود دارند»)، همان وزن برندی را دارد که در اولویت اول به کاربر توصیه شده است.
برای رفع این نقص، سیستم «سهم وزنی بر اساس جایگاه» (Position-Weighted Share) را معرفی میکند. این معیار، یک وزن معکوس (۱، ۱/۲، ۱/۳ و...) را بر اساس جایگاه برند در لیست اعمال میکند تا کاهش طبیعی توجه کاربر در طول یک لیست را شبیهسازی کند. برای ذکراتی که در قالب متن (Prose) ظاهر میشوند و نه در یک لیست رتبهبندی شده، یک وزن ثابت ۰.۲۵ اعمال میشود. این عدد ۰.۲۵ یک تصمیم تحلیلی (Judgment Call) است که باید در مستندات ثبت شده و ثابت بماند، زیرا تغییر دادن وزنها در میانه هر فصل، تحلیل روندها را کاملاً بیمعنی میکند.
معیارهای رقابتی پیشرفته
علاوه بر سهم ساده، این چارچوب از دو نمای با تفکیک بالا برای شناسایی نقاط ضعف خاص استفاده میکند:
- نرخ برد رودررو (Head-to-Head Win Rates): سهم صدا به شما میگوید چه تکهای از کیک را دارید، اما نمیگوید دقیقاً چه کسی شما را شکست میدهد. با جداسازی پاسخهایی که دو برند خاص هر دو در آن حضور دارند و با فرض اینکه ذکرهای متنی (بدون رتبه) در جایگاه آخر (جایگاه ۹۹) قرار بگیرند، سیستم نرخ برد را محاسبه میکند. برای مثال، اگر برندهای Acme و Beacon هر دو در ۱۴۰ پاسخ ظاهر شوند، دادهها میتوانند نشان دهند که Acme تنها در ۳۱٪ موارد در جایگاه اول لیست بوده است. این تحلیل بسیار کاربردیتر از یک درصد کلی SOV است.
- ماتریس همنامی (Co-mention Matrix): با استفاده از شباهت جاکارد (Jaccard similarity)، چارچوب شناسایی میکند که مدل زبانی کدام برندها را به عنوان جایگزین یکدیگر میبیند. این تحلیل اغلب با لیست رقبایی که در اسلایدهای فروش (Sales Deck) آمده است، تفاوت دارد. اگر برندی غیرمنتظره شباهت بالایی با برند شما داشته باشد، این یک سیگنال جدی از مشکل جایگاهسازی (Positioning) است؛ یعنی هوش مصنوعی محصول شما را در دستهبندی اشتباهی قرار داده است.
تفاوت در موتورها و مراحل خرید
اعداد تکبعدی SOV میتوانند فریبدهنده باشند چون میانگین موتورها و مراحل خرید را که رفتار متفاوتی دارند، یکسان میبینند. دادهها نشان میدهند که دیدهشدن در موتورهای مختلف تفاوت شدیدی دارد. برای مثال، یک برند ممکن است در Perplexity — که شدیداً به بازیابی زنده وب (Live Web Retrieval) وابسته است — دیدهشدن بالایی داشته باشد، اما در OpenAI یا Claude ضعیف باشد.
این شکاف معمولاً نشاندهنده نبود ردپا در بررسیهای تخصصی، انجمنها و نشریات شخص ثالث است، نه لزوماً ضعف وبسایت خود برند. پاسخهایی که بر دانش پیشآموزش شده (Pre-trained) تکیه میکنند، بازتابدهنده ردپای کلی و تاریخی شما در وب هستند، در حالی که موتورهای بازیابی زنده، صفحات بهروز شده را سریعتر شناسایی و بازتاب میدهند.
بررسیهای صحت برای یکپارچگی دادهها
برای متخصصان، عدد SOV بدون دانستن مخرج کسر و تفکیک موتورها بیمعنی است. برای حفظ یکپارچگی دادهها، این چارچوب چندین حفاظ امنیتی را پیشنهاد میکند:
- گزارش N: هر سلول SOV باید تعداد پاسخهای پشت آن را نشان دهد؛ سلولهایی با n < ۳۰ باید پنهان شوند تا نویز آماری حذف شود و تصمیمات بر اساس دادههای ناچیز گرفته نشود.
- نسخهبندی مجموعه برندها: اضافه کردن یک رقیب جدید در میانه ماه، به طور خودکار سهم بقیه را کاهش میدهد. بنابراین مجموعههای برند باید دقیقاً مانند پرامپتها نسخهبندی شوند.
- تفکیک موتورها: اگر یک موتور دو برابر پرامپت داشته باشد، در صورت عدم تفکیک قبل از میانگینگیری، بر عدد نهایی غلبه کرده و نتایج را منحرف میکند.
- پوشش نامهای مستعار: ماهی یک بار، پاسخهای بدون ذکر نام را از طریق یک مدل زبانی بررسی کنید (با پرسشی مثل «کدام برندهای محصول در اینجا نام برده شدهاند؟») تا نامهای مستعاری که Regex تشخیص نمیدهد، پیدا شوند.
این تغییر در اندازهگیری، تمرکز صنعت را از «مهندسی پرامپت» برای دیدهشدن، به «مهندسی ردپا» (Footprint Engineering) تغییر میدهد. برندها باید به جای پرسیدن «آیا حضور داریم؟»، بپرسند «چرا رقیب خاصی در یک موتور خاص جایگاه اول را میگیرد؟»
گام بعدی شما
برای تبدیل اعداد به اقدام، گام بعدی انجام یک «تحلیل تفاوت» (Diff Analysis) روی صفحات خاصی است که مدل زبانی هنگام برد رقیب، به آنها استناد میکند. شما میتوانید با اقدامات زیر شروع کنید:
- حضور خود را در Gemini و Perplexity ممیزی کنید تا ببینید آیا ردپای زنده شما با دستهبندی مورد نظرتان مطابقت دارد یا خیر.
- یک ماتریس همنامی برای رقبای اصلی خود بسازید تا متوجه شوید هوش مصنوعی شما را با چه کسانی جایگزین میکند.
- تحلیل کنید که کدام منابع شخص ثالث (Third-party) بیشترین تأثیر را در رتبهبندی شما در موتورهای بازیابی زنده دارند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو