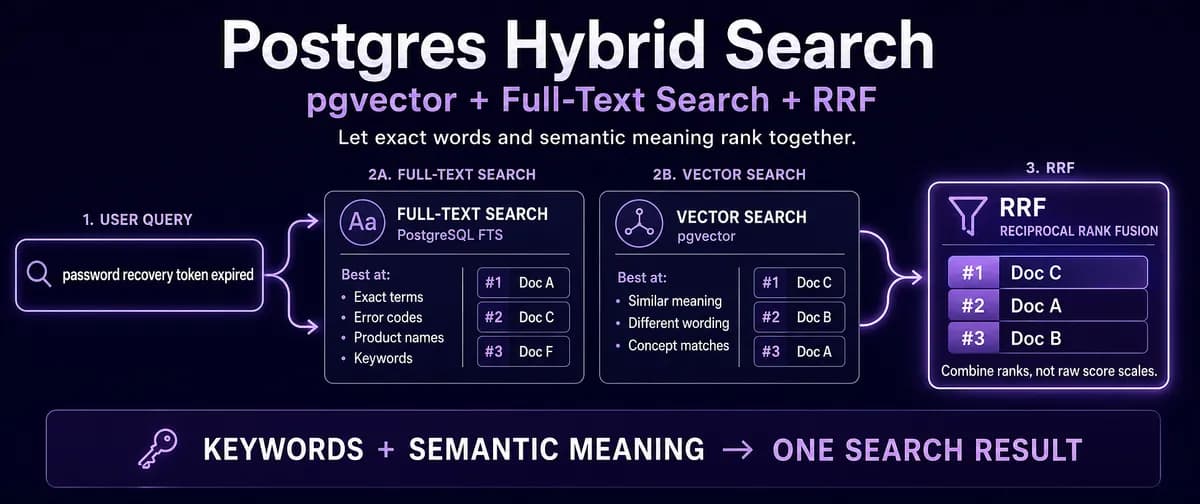
تصور کنید برنامهنویسی به دنبال کد خطای 'ERR_AUTH_2041' است اما جستوجوی معنایی هیچ نتیجهای نمییابد، یا کاربری درباره «بازیابی رمز عبور» میپرسد اما سندی که فقط عبارت «بازنشانی اعتبارنامه» دارد را از دست میدهد. PostgreSQL این تضاد را با ایجاد یک مسیر بازیابی ترکیبی حل میکند که جستوجوهای کلیدواژهای و برداری را بهطور موازی اجرا میکند.
بسیاری از برنامههای مدرن هوش مصنوعی بر پایه تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — بنا شدهاند. اما تکیه صرف به بردار معنایی (Embedding) — که مثل کارت معرفی عددی برای هر واژه است و میگوید این کلمه همسایهی چه کلمات دیگری است — اغلب هنگام جستوجوی نامهای خاص محصول، شماره فاکتور یا اختصارات فنی شکست میخورد. یک راهنمای پیادهسازی دقیق نشان میدهد که چگونه میتوان این شکاف را با استفاده از pgvector و جستوجوی متنی کامل (FTS) در یک نمونه دیتابیس واحد پر کرد. این رویکرد با PostgreSQL نسخه ۱۶ و pgvector نسخه ۰.۸.۶ سازگار است، هرچند pgvector از PostgreSQL نسخه ۱۳ و نسخههای جدیدتر را نیز پشتیبانی میکند.
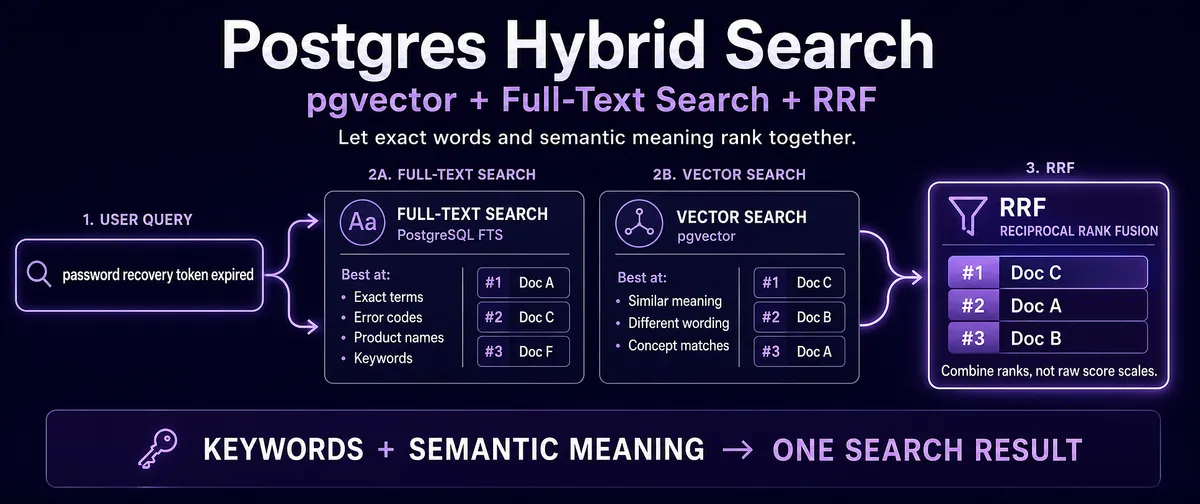
معماری ترکیبی
جستوجوی ترکیبی با استخراج لیست کاندیدها از دو سیستم مستقل و ترکیب رتبههای آنها کار میکند. مسیر اول از FTS در PostgreSQL استفاده میکند که برای تطابق دقیق کلمات بهینه شده است. مسیر دوم از pgvector بهره میبرد تا اسنادی با معانی مشابه را پیدا کند، حتی اگر کلمات متفاوتی به کار رفته باشد.
به عنوان مثال، سندی را در نظر بگیرید که میگوید: «لینکهای بازنشانی پس از پانزده دقیقه باطل میشوند.» کاربری که عبارت «انقضای توکن بازیابی رمز عبور» را جستوجو میکند، توسط جستوجوی معنایی پیدا میشود چون ایدهها مرتبط هستند. اما اگر کاربر عبارت «ERR_AUTH_2041» را جستوجو کند، یک بردار معنایی احتمالاً درک بسیار کمی از این شناسه دارد، اما جستوجوی متنی کامل میتواند مستقیماً آن را بیابد. این موضوع برای نام APIها، اصطلاحات خاص مشتریان و نامهای دقیق ویژگیهای محصول به همان اندازه صادق است.
جریان بازیابی
مسیر نهایی برای یک پرسوجو از این توالی پیروی میکند:
- پرسوجوی کاربر $\rightarrow$ اجرای موازی جستوجوی کلیدواژهای (PostgreSQL FTS) و جستوجوی معنایی (pgvector).
- رتبهبندی کاندیدها $\rightarrow$ هر دو سیستم لیستی از نتایج احتمالی را برمیگردانند.
- RRF $\rightarrow$ مکانیزم Reciprocal Rank Fusion این لیستها را در یک امتیاز واحد ادغام میکند.
- لیست نهایی $\rightarrow$ اسنادی با بالاترین امتیاز به کاربر نمایش داده میشوند.
برای پیادهسازی این سیستم، به یک طرح جدول (Schema) خاص نیاز است. جدول documents باید متن خام، یک بردار معنایی (مثلاً با ۱۵۳۶ بُعد) و یک ستون tsvector تولیدشده را ذخیره کند. این طرح از قابلیت GENERATED ALWAYS AS برای ترکیب عنوان و محتوا استفاده میکند.
وزندهی و متادیتا
- وزندهی فیلدها: استفاده از
tsvectorبه دیتابیس اجازه میدهد تا وزن عنوانها را بیشتر از متن بدنه در نظر بگیرد. با استفاده ازsetweightعنوان به وزن 'A' و محتوا به وزن 'B' اختصاص مییابد. این امر تضمین میکند که تطابق در عنوان، رتبه بالاتری نسبت به تطابقی که در اعماق بدنه متن دفن شده است، کسب کند. - ستونهای متادیتا: جدول شامل ستونهای
tenant_id(از نوع bigint)،category(از نوع text) وpublished_at(از نوع timestamptz) است تا از جستوجوهای فیلتر شده پشتیبانی کند. - ابعاد بردار: عدد ۱۵۳۶ یک مثال است؛ توسعهدهندگان باید دقیقاً از ابعادی که توسط مدل برداری خاص آنها بازگردانده میشود استفاده کنند.
بهینهسازی عملکرد
سرعت سیستم به استفاده از انواع ایندکسهای صحیح برای هر روش جستوجو وابسته است. جستوجوی متنی کامل به یک ایندکس GIN (Generalized Inverted Index) روی ستون search_vector نیاز دارد. جستوجوی برداری از ایندکس HNSW (Hierarchical Navigable Small World) با استفاده از vector_cosine_ops بهره میبرد تا جستوجوی سریع «نزدیکترین همسایه تقریبی» را تضمین کند.
در برنامههای چندمستاجری (Multi-tenant)، افزودن یک ایندکس استاندارد B-tree روی tenant_id حیاتی است. اگر فیلد category معمولاً برای فیلتر کردن استفاده میشود، باید یک ایندکس مجزا به نام documents_category_idx ایجاد شود. بدون این ایندکسها، دیتابیس ممکن است اسکنهای ترتیبی (Sequential Scans) کندی انجام دهد، بهویژه زمانی که نتایج بر اساس کاربر یا سازمان فیلتر میشوند.
حل تضاد امتیازدهی
یکی از بزرگترین چالشها در جستوجوی ترکیبی این است که امتیازات لغوی (مانند ts_rank_cd) و امتیازات شباهت برداری در مقیاسهای کاملاً متفاوتی قرار دارند. جمع کردن یک رتبه متنی ۰.۷۸ با یک شباهت برداری ۰.۷۸ از نظر ریاضی بیمعنی است زیرا این مقادیر مفاهیم متفاوتی را نمایندگی میکنند. نرمالسازی این امتیازات اغلب سیستم را بیش از حد به انتخابهای نرمالسازی حساس میکند.
برای حل این مشکل، راهنمای مذکور Reciprocal Rank Fusion (RRF) را پیشنهاد میکند. RRF بهجای استفاده از امتیازات خام، از جایگاه (رتبه) سند در هر لیست استفاده میکند. فرمول 1 / (k + rank) (که در آن k معمولاً ۶۰ است) امتیازات را بر اساس موقعیت اختصاص میدهد.
- سهم رتبه ۱: ۱ / (۶۰ + ۱) = ۱/۶۱
- سهم رتبه ۱۰: ۱ / (۶۰ + ۱۰) = ۱/۷۰
سندی که در هر دو لیست در رتبههای بالا ظاهر شود، قویترین امتیاز ترکیبی را دریافت میکند، فارغ از اینکه معیار امتیازدهی اولیه چه بوده است.
پیادهسازی در Node.js
ادغام این سیستم در یک برنامه عملیاتی شامل یک جریان پرسوجوی خاص است. برنامه ابتدا یک بردار پرسوجو را با استفاده از یک ارائهدهنده خارجی تولید میکند، سپس آن بردار را به همراه متن خام پرسوجو به یک تابع Node.js با استفاده از کتابخانه pg میفرستد. تابع کمکی toVectorLiteral برای اطمینان از اینکه آرایه بردار بهطور صحیح به عنوان یک رشته برداری PostgreSQL فرمت شده است، استفاده میشود.
- شاخه لغوی: ۵۰ نتیجه برتر را با استفاده از
websearch_to_tsqueryبازیابی میکند. این تابع از ورودیهای کاربرپسند، عبارات داخل کوتیشن، عملگرهای OR و استثناهای سبک منفی (minus-style) پشتیبانی میکند. همچنین ازts_rank_cdاستفاده میکند تا بررسی کند کلمات متطابق تا چه حد نزدیک به هم قرار گرفتهاند. - شاخه معنایی: ۵۰ نتیجه برتر را با استفاده از عملگر فاصله کسینوسی
<=>بازیابی میکند. در این سیستم، فاصله کمتر نشاندهنده بردار نزدیکتر است. شباهت را میتوان به صورت1 - (embedding <=> $1::vector)تبدیل کرد. - لایه ادغام: یک
FULL OUTER JOINاین دو لیست را ترکیب میکند. تابعcoalesceاسنادی را که تنها در یکی از دو لیست ظاهر شدهاند مدیریت کرده و امتیاز نهایی RRF را محاسبه میکند.
مدیریت فیلترها و HNSW
فیلتر کردن بر اساس دستهبندی یا مستاجر در ایندکسهای HNSW میتواند دشوار باشد. از آنجایی که HNSW یک جستوجوی تقریبی است، فیلتر کردن اغلب پس از استخراج کاندیدها از ایندکس اتفاق میافتد. اگر استخر کاندیدهای HNSW برابر با ۴۰ باشد اما تنها ۱۰٪ آنها متعلق به مستاجر درخواستی باشند، ممکن است در نهایت با تعداد بسیار کمی سطر قابل استفاده مواجه شوید.
برای رفع این مشکل، pgvector نسخه ۰.۸.۰ و نسخههای جدیدتر از اسکنهای ایندکس تکرارشونده (iterative index scans) پشتیبانی میکنند. توسعهدهندگان باید از SET hnsw.iterative_scan = strict_order در یک تراکنش (با استفاده از BEGIN و COMMIT) استفاده کنند تا ترتیب سختگیرانه هنگام اعمال فیلترها تضمین شود. این کار از بازگرداندن مجموعهای ناقص از نتایج، صرفاً به دلیل گزینشی بودن زیاد فیلتر، جلوگیری میکند. این چالشهای عملیاتی در محیطهای واقعی بسیار رایج است و تأثیر فیلترهای دسترسی بر نتایج بنچمارکهای pgvector را میتوان در تحلیلهای پیشین مشاهده کرد.
ارزیابی و تست
کیفیت جستوجو نباید بر اساس شهود تنظیم شود. پیشنهاد میشود یک مجموعه ارزیابی کوچک از پرسوجوها با شناسههای اسناد مورد انتظار ایجاد شود. برای مثال:
- پرسوجو: «لینک بازیابی رمز عبور منقضی شده» $\rightarrow$ مورد انتظار:
doc_104,doc_219 - پرسوجو: «ERR_AUTH_2041» $\rightarrow$ مورد انتظار:
doc_442 - پرسوجو: «مشتری پس از بازنشانی نمیتواند به حساب دسترسی داشته باشد» $\rightarrow$ مورد انتظار:
doc_104,doc_331
این کار به توسعهدهندگان اجازه میدهد اندازهگیری کنند که آیا یک سند در ۵ نتیجه برتر در سه حالت مختلف ظاهر میشود یا خیر: فقط لغوی، فقط برداری و ترکیبی RRF. از آنجا، توسعهدهندگان میتوانند تعداد کاندیدها (در حال حاضر ۵۰)، ثابت RRF (در حال حاضر ۶۰) یا وزنهای عنوان/بدنه را تنظیم کنند.
دو تست شکست خاص برای اعتبارسنجی سیستم توصیه میشود:
۱. شناسههای دقیق: سندی با عبارت «ERR_BILLING_4092» ایجاد کنید. جستوجوی دقیق این رشته باید بهطور قوی توسط شاخه لغوی بازیابی شود.
۲. عبارات معنایی: سندی که بیان میکند «در صورت شکست پردازش پیش از تکمیل، مصرف بازگردانده میشود» باید توسط پرسوجویی مانند «آیا اگر جاب کرش کند اعتباراتم را پس میگیرم؟» از طریق شاخه برداری پیدا شود، زیرا «اعتبارات پس» را به «مصرف بازگردانده» و «کرش جاب» را به «شکست پردازش» مرتبط میکند.
آمادگی برای محیط عملیاتی
قبل از عرضه، راهنما تأکید میکند که رتبهبندی جستوجو نباید به عنوان یک مرز احراز هویت (Authorization Boundary) استفاده شود. اپلیکیشن باید همچنان کنترل دسترسی مستاجر را قبل از بازگرداندن نتایج به کاربر اعمال کند.
برای حفظ پایداری بلندمدت، توسعهدهندگان باید embedding_model و embedding_version را برای هر سند ذخیره کنند. این کار از «شکست خاموش» جلوگیری میکند؛ شکستی که زمانی رخ میدهد که اسناد جدید با مدلی متفاوت از اسناد قدیمی برداری شوند و در نتیجه در فضاهای برداری متفاوتی قرار گیرند. در این صورت، مهاجرت به مدل جدید میتواند بهطور صریح از طریق باز-برداری (Re-embedding)، مهاجرت دستهای یا ایجاد جداول جدید انجام شود.
علاوه بر این، توسعهدهندگان باید از EXPLAIN (ANALYZE, BUFFERS) استفاده کنند تا تأیید کنند که ایندکسهای GIN و HNSW واقعاً روی دادههای در مقیاس تولید استفاده میشوند، زیرا PostgreSQL ممکن است در جداول کوچک توسعه، بهطور پیشفرض به اسکنهای ترتیبی روی آورد.
این تنظیمات اجازه میدهد جریان RAG شفاف بماند. با جدا نگه داشتن بازیابی از تولید، تیمها میتوانند بررسی کنند که آیا یک پاسخ ضعیف LLM ناشی از شکست در لایه جستوجوی ترکیبی بوده یا شکست در استدلال مدل. شناسههای کاندیدها از هر دو شاخه لغوی و معنایی را برای عیبیابی اینکه چرا برخی اسناد ظاهر میشوند یا نمیشوند، ثبت (Log) کنید.
چکلیست نهایی تولید
برای اطمینان از استحکام سیستم، موارد زیر را قبل از استقرار بررسی کنید:
- جستوجوی متنی: تأیید کنید که
tsvectorاز فیلدهای مهم ساخته شده و وزندهی عنوان مؤثر است. - جستوجوی برداری: اطمینان حاصل کنید که بردارهای سند و پرسوجو از مدل برداری و بُعد یکسانی استفاده میکنند.
- ایندکسها: فعال بودن GIN و HNSW را روی دادههای مقیاس تولید با
EXPLAIN ANALYZEتأیید کنید. - فیلترها: اطمینان حاصل کنید که فیلترهای مستاجر و دستهبندی بهطور یکسان روی هر دو شاخه بازیابی اعمال میشوند.
- فیلترینگ HNSW: بررسی کنید که آیا فیلترهای گزینشی تعداد کاندیدها را کاهش میدهند؛ برای مقیاسهای بزرگتر، اسکنهای تکرارشونده یا پارتیشنبندی را در نظر بگیرید.
- تنظیم RRF: تعداد کاندیدها و ثابت ادغام را در برابر یک مجموعه پرسوجوی برچسبدار تست کنید.
- کنترل دسترسی: تأیید کنید که پرسوجوهای جستوجو نمیتوانند اسناد مستاجر دیگر را بازیابی کنند.
- مشاهدهپذیری: ثبت لاگ برای شناسههای کاندید لغوی، شناسههای کاندید معنایی، شناسههای نهایی و تأخیر (Latency) را پیادهسازی کنید.
- ارزیابی: مجموعهای از پرسوجوهای تایید شده را برای اجرا هنگام تغییر مدلهای برداری، پیکربندیهای متنی یا پارامترهای RRF حفظ کنید.
برای تیمهایی که در حال حاضر از PostgreSQL استفاده میکنند، این رویکرد نیاز به یک دیتابیس برداری مجزا را از بین میبرد، پیچیدگی معماری را کاهش میدهد و در عین حال تجربهای از جستوجو را فراهم میکند که هم دقت کلیدواژهها و هم انعطافپذیری معنایی را مدیریت میکند. این یک نقطه شروع عملی برای جستوجوی مستندات، پایگاههای دانش داخلی، مراکز کمک SaaS و جریانهای بازیابی هوش مصنوعی است.



گفتگو