اگر امروز با خطای rate_limit_error در Claude مواجه میشوید، احتمالاً ساعتها از زمان مهندسی خود را برای حل مشکلی تلف میکنید که اصلاً به سرعت درخواستهای شما مربوط نیست. طبق یک راهنمای فنی منتشر شده در ۲۶ اوت ۲۰۲۶، واکنش سریع به این خطا بدون بررسی جزئیات، میتواند منجر به اتلاف منابع شود، بهخصوص زمانی که علت واقعی، رسیدن به سقف هزینهی ماهانه است.
همانطور که در تحلیل قبلی ما دربارهی رقابت جریانهای کاری بین Claude 4، GPT-5 و Gemini 2.0 اشاره کردیم، چالش اصلی اکنون از کیفیت مدلها به پایداری در محیط عملیاتی تغییر کرده است. در دنیای امروز، عاملهای هوش مصنوعی (AI Agents) — شبیه دستیارهای اداری که میتوانند بهتنهایی چندین فرم را پر کنند و ایمیل بزنند — با حجم عظیمی از دادهها سروکار دارند و همین موضوع باعث شده «سطل توکن» به گلوگاه اصلی مقیاسپذیری تبدیل شود.
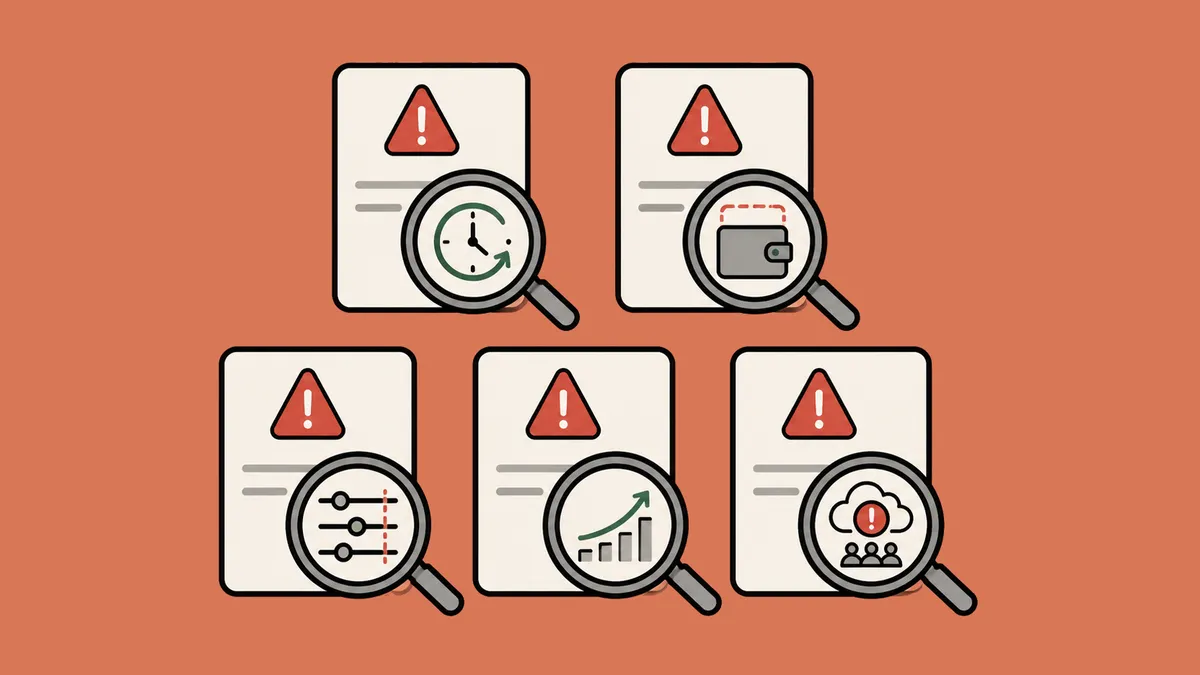
پنج چهرهی خطای ۴۲۹
به نقل از مستندات فنی، تمام محدودیتهای نرخ یکسان نیستند. اولین قدم در عیبیابی، ثبت کامل بدنه خطا است، نه فقط کد وضعیت. Anthropic برای چندین وضعیت مختلف، یک رشته متن مشابه برمیگرداند، اما راهکار هر کدام متفاوت است و پاسخ صحیح میتواند از «۸ ثانیه صبر کنید» تا «صبر کردن هرگز جواب نمیدهد، تنظیمات را تغییر دهید» متغیر باشد:
- محدودیتهای واقعی نرخ (True Rate Limits): این خطاها دارای هدر
retry-afterهستند. شما صرفاً بیش از حد سریع درخواست فرستادهاید؛ صبر کردن به مدت ثانیههای مشخص شده در هدر، مشکل را حل میکند. این یک محدودیت واقعی در هر دقیقه است. - سقف هزینهی ماهانه (Monthly Spend Caps): این موارد خطای ۴۲۹ میدهند اما هدر
retry-afterندارند و کد خطایenforced_spend_limit_reachedرا نمایش میدهند. در این حالت، تلاش مجدد (Retry) کاملاً بیفایده است؛ دسترسی شما تنها در ساعت ۰۰:۰۰ UTC در اول هر ماه باز میشود. این موضوع در حالی رخ میدهد که آنتروپیک برای کاهش هزینههای سازمانی، قیمت API مدل Opus را برای سازمانها نصف کرده است تا دسترسی به مدلهای قدرتمند تسهیل شود. - محدودیتهای تعریفشده توسط کاربر (User-Set Limits): این خطاها به صورت ۴۰۰
invalid_request_errorظاهر میشوند و پیامی مبنی بر رسیدن به محدودیتهای استفادهای که خودتان تعیین کردهاید، ارسال میکنند. شما باید به صورت دستی این محدودیت را در کنسول افزایش داده یا حذف کنید. - محدودیتهای شتابدهی (Acceleration Limits): این خطاها درست بعد از یک جهش شدید در ترافیک رخ میدهند. این یک محدودیت شتاب است، نه محدودیت حالت پایدار شما. راهکار آن، افزایش تدریجی ترافیک (Gradual Ramp-up) است، نه ارسال ناگهانی حجم زیادی از درخواستها.
- خطاهای فشار روی سرور (Overloaded Errors): خطای ۵۲۹ یا
overloaded_errorبه این معناست که کل سیستم Anthropic در سطح جهانی شلوغ است. این موضوع هیچ ارتباطی به حساب شما ندارد. هیچ مقدار ارتقای لایه یا چرخش کلید (Key Rotation) از طرف شما این مشکل را حل نمیکند، زیرا صف انتظار جهانی است.
درک مکانیزم سطل توکن
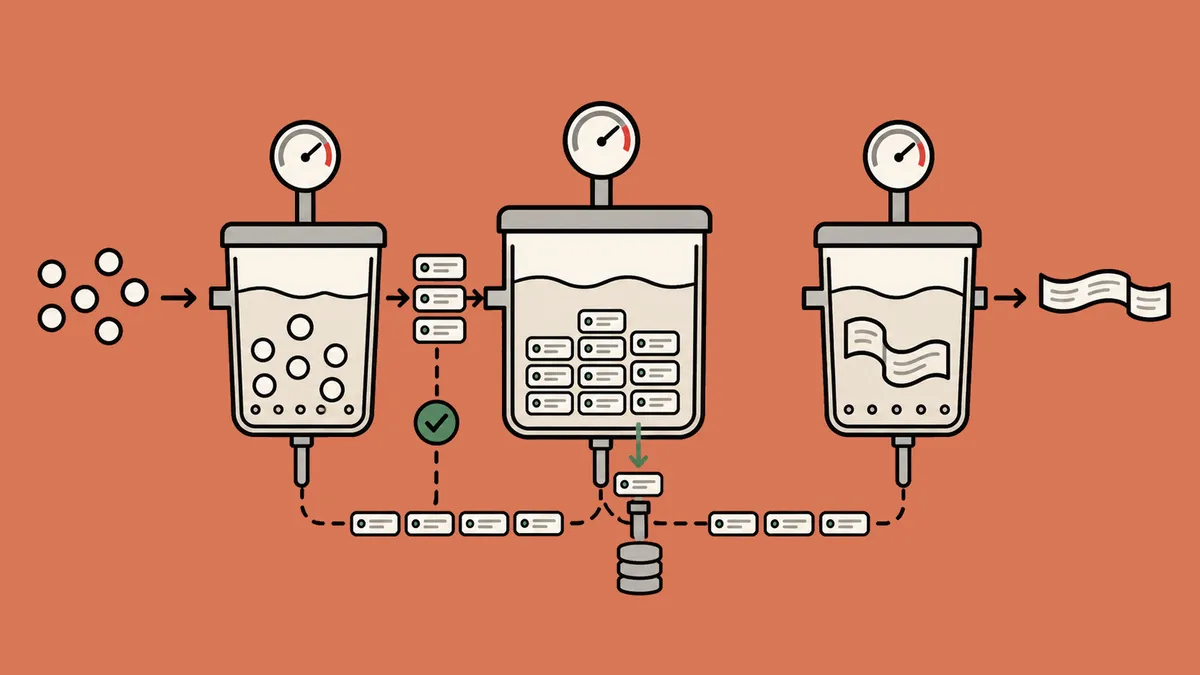
Anthropic سه محدودیت همزمان را برای هر مدل اعمال میکند: تعداد درخواست در دقیقه (RPM)، توکنهای ورودی در دقیقه (ITPM) و توکنهای خروجی در دقیقه (OTPM). اینها از طریق سیستمی به نام «سطل توکن» (Token Bucket) مدیریت میشوند؛ به این معنا که ظرفیت بهجای بازنشانی در ابتدای هر دقیقه، بهطور مداوم و در لحظه پر میشود.
به همین دلیل، محدودیت ۶۰ RPM بیشتر شبیه به «یک درخواست در ثانیه» است تا «۶۰ درخواست آزاد در ابتدای هر دقیقه». اگر ۶۰ درخواست همزمان در ساعت ۱۲:۰۰:۰۰ بفرستید، حتی اگر میانگین شما در آن دقیقه دقیقاً روی سقف باشد، باز هم با محدودیت نرخ مواجه میشوید.
این وضعیت برای کندترین ۱٪ درخواستها (p99 latency) در حلقههای موازی (Fanned-out loops)، یک «دیوار از خطاهای ۴۲۹» ایجاد میکند. برای مثال، هنگام ساخت سیستمی مانند Scholarian برای رتبهبندی ۱۰,۰۰۰ مقاله علمی، حلقهای که برای هر سند یک فراخوانی مدل انجام میدهد، در داشبورد درست به نظر میرسد اما در عمل شکست میخورد، زیرا هیچ مکانیزمی برای تنظیم سرعت (Pacing) در حلقه وجود ندارد.
سطلهای اختصاصی هر مدل
مهم است بدانید این محدودیتها برای هر کلاس مدل جداگانه اعمال میشوند. ترافیک Sonnet و Haiku از سطلهای متفاوتی استفاده میکنند و میتوانند همزمان با حداکثر سرعت اجرا شوند. با این حال، در خط تولید فعلی تفاوتهای ظریفی وجود دارد:
- مدل Sonnet 5 سطل اختصاصی خود را دارد.
- مدلهای Sonnet 4.6 و 4.5 یک سطل مشترک دارند.
- مدل Opus 5 سطل اختصاصی دارد، در حالی که خانواده Opus 4.x سطل دیگری را به اشتراک میگذارند.
بنابراین، هدایت نیمی از ترافیک خود به یک نسخه قدیمیتر Sonnet، باعث دو برابر شدن فضای خالی (Headroom) شما در Sonnet 5 نمیشود.
قدرت حافظهٔ پرامپت
در اکثر مدلها، فقط توکنهای ورودی بدون حافظه در ITPM محاسبه میشوند. به طور دقیقتر، input_tokens و cache_creation_input_tokens محاسبه میشوند، اما cache_read_input_tokens محاسبه نمیشود. یک Cache Hit از نظر محدودیت نرخ اساساً رایگان است و با نرخ هزینه کمتری صورت میگیرد.
(نکته: مدل Claude Haiku 3.5 استثنا است و خواندن از حافظه را محاسبه میکند.)
یک عامل کدنویسی را در نظر بگیرید که در هر نوبت ۱۸۰,۰۰۰ توکن زمینه ارسال میکند و در لایه Start (با ۲ میلیون ITPM) قرار دارد:
- بدون حافظه: ۲,۰۰۰,۰۰۰ تقسیم بر ۱۸۰,۰۰۰ تقریباً برابر با ۱۱ نوبت در دقیقه برای کل سازمان است.
- با حافظهٔ پرامپت: اگر ۱۷۰,۰۰۰ توکن از حافظه خوانده شوند، فقط ۱۰,۰۰۰ توکن در ITPM محاسبه میشود. این امر اجازه میدهد در همان محدودیت، ۲۰۰ نوبت در دقیقه درخواست ارسال شود.
یک نکته ظریف: cache_creation_input_tokens محاسبه میشود. نوشتن حافظه یک بار هزینه کامل ITPM را دارد. باری کاری که مدام پیشوند (Prefix) خود را تغییر داده و حافظه را بازسازی میکند، بدترین حالت هر دو وضعیت را تجربه خواهد کرد.
توکنهای خروجی و پارامتر Max Tokens
مقدار OTPM بر اساس توکنهایی که در زمان واقعی تولید میشوند اندازهگیری میشود. یک اشتباه رایج، کاهش مقدار پارامتر max_tokens برای فرار از محدودیتهای نرخ است. در واقعیت، max_tokens هرگز در محاسبات OTPM دخالت نمیکند. هیچ جریمهای در محدودیت نرخ برای تعیین یک مقدار سخاوتمندانه برای max_tokens وجود ندارد.
نظارت از طریق هدرها
هر پاسخ، حتی پاسخهای موفقیتآمیز، وضعیت فعلی شما را در هدرهای anthropic-ratelimit-* حمل میکند. بهجای حدس زدن، این مقادیر را به متریکهای خود متصل کنید:
anthropic-ratelimit-requests-remaininganthropic-ratelimit-input-tokens-remaininganthropic-ratelimit-output-tokens-remaining- و فیلدهای متناظر
-reset(که به صورت برچسبهای زمانی RFC 3339 ارائه میشوند).
دو نکته مهم: مقادیر باقیمانده به نزدیکترین هزار رند میشوند و سهگانه عمومی anthropic-ratelimit-tokens-* هر محدودیتی که در حال حاضر سختگیرانهترین باشد را گزارش میکند، به این معنی که عدد ممکن است بین محاسبات ورودی و خروجی جابجا شود.
استراتژیهای بازگشت هوشمند (Smart Retries)
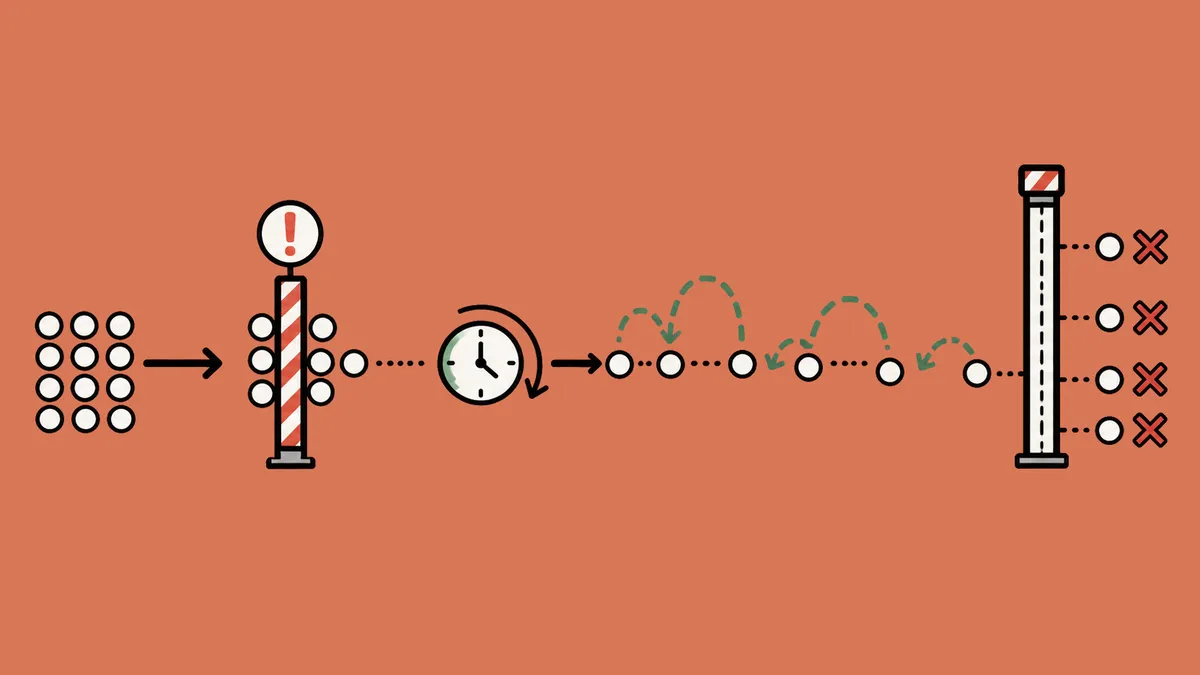
استفاده از بازگشتهای پیشفرض SDK میتواند خطرناک باشد اگر با حلقههای سفارشی شما روی هم قرار بگیرند. SDKهای رسمی به طور پیشفرض دو بار تلاش مجدد میکنند؛ اگر این را در حلقه خودتان قرار دهید، ممکن است ۳ برابر تلاشهای مورد نظرتان انجام شود. اگر بازگشتها را دستی مدیریت میکنید، max_retries=0 را در SDK تنظیم کنید.
استراتژی درست، رعایت دقیق هدر retry-after است. اگر این هدر در خطای ۴۲۹ نبود، فوراً تلاش مجدد را متوقف کنید زیرا نشاندهنده سقف هزینه است. اگر در سایر خطاهای قابل تلاش (۵۰۰، ۵۰۲، ۵۰۳، ۵۰۴، ۵۲۹) نبود، از «پسروی نمایی» (Exponential Backoff) مانند min(2 ** attempt, 30) همراه با یک ضریب «لرزش» (Jitter) بین ۰.۸ تا ۱.۲ استفاده کنید.
بدون لرزش، اگر ۵۰ Worker همزمان محدود شوند، همگی در یک لحظه تلاش مجدد میکنند و یک «گله تندر» (Thundering Herd) ایجاد میکنند که خطای ۴۲۹ را در یک زمانبندی ثابت بازتولید میکند.
گسترش سقف با درگاههای هوش مصنوعی
وقتی یک کلید API دیگر کافی نیست، راهکار استفاده از یک درگاه هوش مصنوعی (AI Gateway) مانند Bifrost است. درگاهها سقف داخلی Anthropic را بالا نمیبرند — لایه Start شما همچنان Start میماند — اما اجازه میدهند به چندین «سطل» ظرفیت بهطور همزمان دسترسی داشته باشید.
چهار منبع اصلی ظرفیت برای Claude وجود دارد:
۱. API مستقیم: بر اساس لایههای مصرف (Start, Build, Scale, Custom). تا اواسط ۲۰۲۶، سقفهای هزینه ماهانه ۵۰۰ دلار (Start)، ۱,۰۰۰ دلار (Build) و ۲۰۰,۰۰۰ دلار (Scale) است.
۲. Amazon Bedrock: تابع سهمیههای سرویس AWS به ازای هر حساب و منطقه. اینها از طریق کنسول Service Quotas قابل تنظیم هستند و مستقل از لایههای Anthropic میباشند.
۳. Google Cloud: مدیریت شده از طریق سهمیههای model garden در Vertex AI با یک شمارنده جداگانه.
۴. لایه اولویت (Priority Tier): ظرفیتهای متعهد شده با هدرهای اختصاصی anthropic-priority-* که در کنار محدودیتهای استاندارد قرار میگیرند.
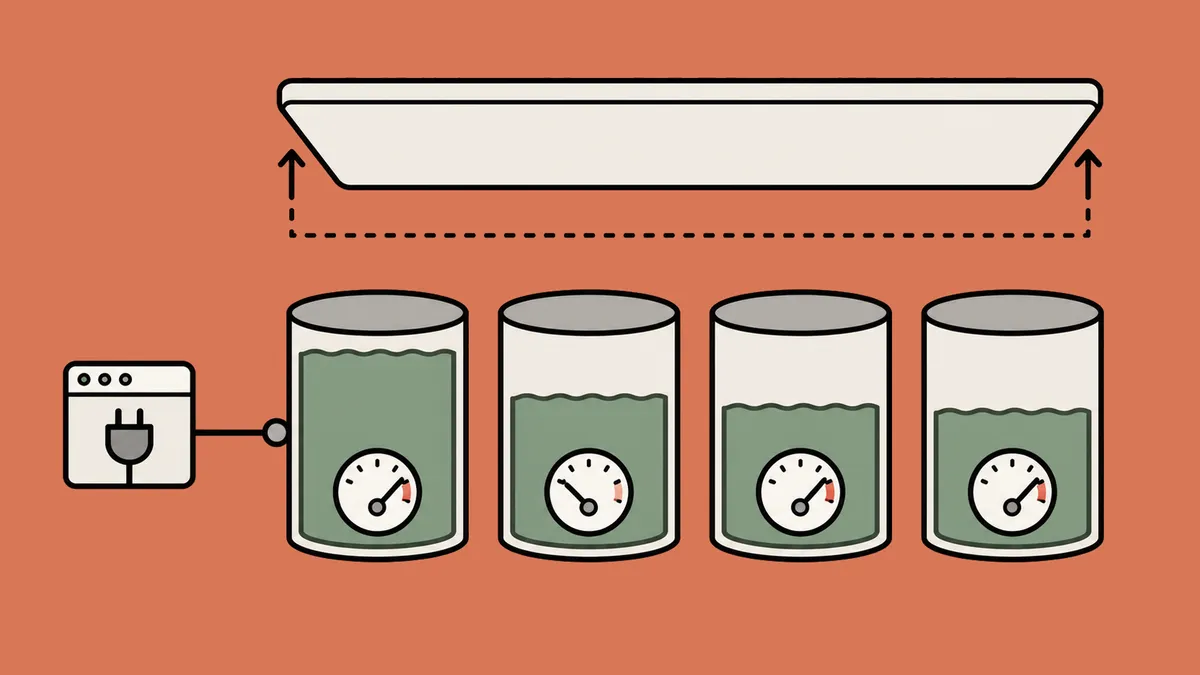
یک درگاه میتواند چندین کلید را تجمیع کند یا درخواستها را بین این تامینکنندگان مختلف مسیریابی کند. اگر API مستقیم خطای ۴۲۹ داد، درگاه میتواند فوراً به Bedrock یا Vertex AI بازگردد (Fallback).
توزیع بار تطبیقی و مدیریت کلیدها
درگاهها میتوانند چندین کلید را به عنوان یک استخر منطقی با استفاده از وزنها مدیریت کنند (مثلاً تقسیم ۷۰/۳۰ بین کلید اصلی و کلید پشتیبان). Bifrost زمانی که خطا مربوط به اعتبارنامه باشد (۴۲۹، ۴۰۱، ۴۰۳، ۴۰۲)، کلیدها را میچرخاند.
انتخاب کلید بر اساس نرخ خطاهای اخیر، تأخیر و دفعات برخورد با محدودیت نرخ امتیازدهی میشود. وزنها در بازههای زمانی کوتاه بازمحاسبه میشوند و جریمهها با بهبودی کلید کاهش مییابند. این در واقع اعمال «توزیع بار تطبیقی» روی اعتبارنامهها است.
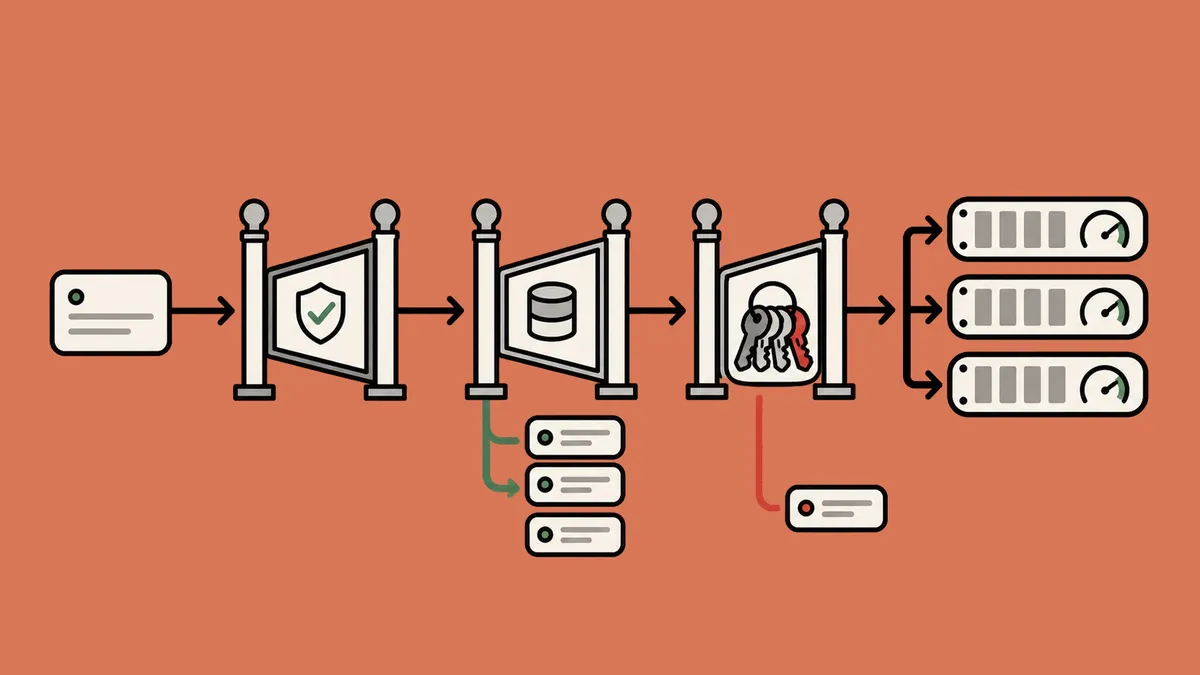
جایگزینی و زمانبندی (Fallbacks)
انتقال ترافیک بین کانالها (Direct $ \rightarrow $ Bedrock $ \rightarrow $ Vertex) کمککننده است، حتی اگر برای هر تامینکننده فقط یک کلید داشته باشید. با این حال، مراقب بودجه بازگشت (Retry Budget) باشید. اگر یک منبع اصلی max_retries: 3 داشته باشد و دو منبع جایگزین نیز هر کدام ۳ بار تلاش کنند، یک فراخوانی واحد میتواند منجر به ۱۲ تلاش شود. زمان انتظار (Timeout) کلاینت خود را بر این اساس تنظیم کنید.
پسروی پیشفرض Bifrost به صورت min(initial × 2^attempt, max) × jitter(0.8-1.2) است، با مقدار اولیه ۵۰۰ میلیثانیه و سقف ۵۰۰۰ میلیثانیه. توجه داشته باشید که max_retries در بسیاری از تنظیمات درگاه به طور پیشفرض ۰ است و باید صراحتاً فعال شود.
حاکمیت و محدودیتهای درگاه
درگاهها مانع از این میشوند که یک پردازش دستهای (Batch) runaway، منابع کاربران تعاملی را مصرف کند. با تعریف محدودیتهای حاکمیتی برای هر کلید مجازی، درگاه میتواند قبل از رسیدن درخواست به تامینکننده، آن را با یک کد خاص مسدود کند:
token_limitedیاrequest_limited(در هنگام ۴۲۹)budget_exceeded(در هنگام ۴۰۲)403برای مدل یا تامینکننده مسدود شده
حافظه در سطح درگاه
حافظه در سطح درگاه بسیار بهینهتر از حافظه در سطح هر سرویس است. اگر چهار سرویس مختلف یک سؤال مشابه بپرسند، حافظه درگاه سه مورد از آنها را پوشش میدهد و از رسیدن آن درخواستها به ITPM شما جلوگیری میکند. حافظه Bifrost از طریق هدر x-bf-cache-key فعال میشود و به طور پیشفرض دارای TTL ۵ دقیقهای و آستانه شباهت کسینوسی ۰.۸ برای حافظه معنایی (Semantic Caching) است.
ادغام با Claude Code
برای کسانی که از عاملهای کدنویسی استفاده میکنند، ادغام از طریق دو متغیر محیطی انجام میشود. Bifrost یک نقطه اتصال سازگار با Anthropic در مسیر /anthropic (و نه /v1/anthropic) ارائه میدهد:export ANTHROPIC_BASE_URL=http://localhost:8080/anthropicexport ANTHROPIC_API_KEY=dummy-key
این ادغام برای توسعهدهندگانی که از Claude Code به عنوان سریعترین چارچوب عاملها استفاده میکنند حیاتی است، هرچند باید مراقب هزینههای بالاتر این ابزار در مقایسه با روشهای سنتی باشند.
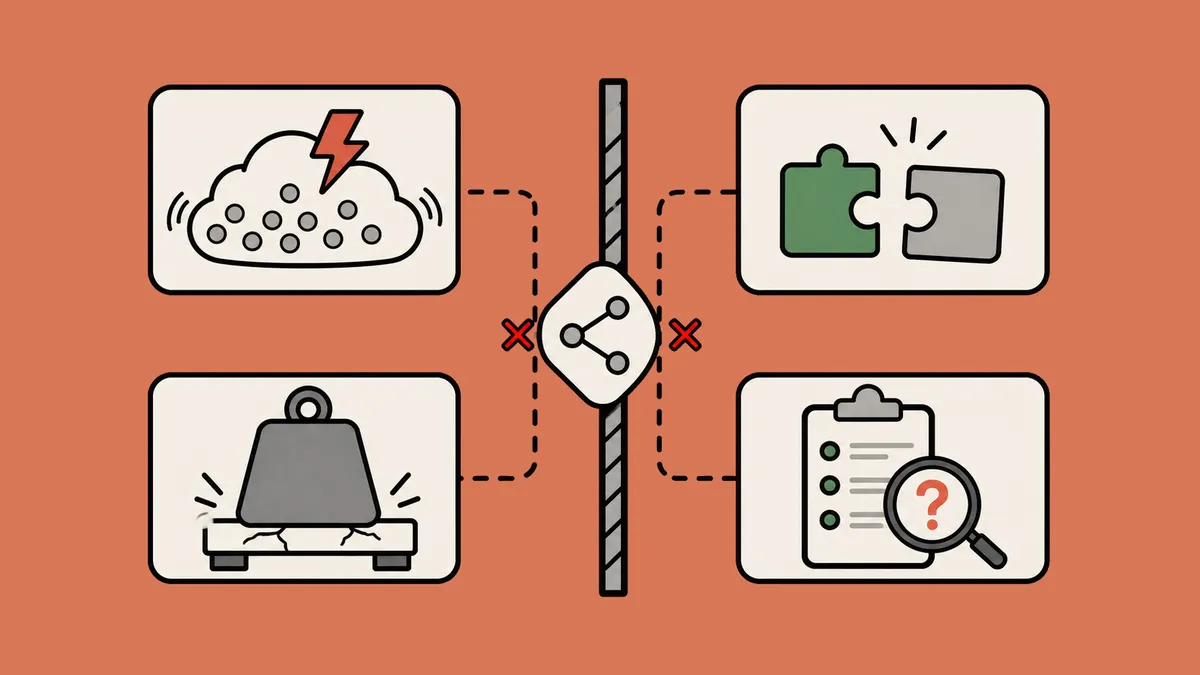
آنچه درگاهها حل نمیکنند
۱. خطاهای ۵۲۹ Overloaded: اینها در سطح کل Anthropic هستند. در حالی که بازگشت به Bedrock ممکن است آن را دور بزند، اما چرخش کلید در API مستقیم کمکی نمیکند.
۲. برابری مدلها (Model Parity): مدل Sonnet 5 در API مستقیم و Sonnet 4.5 در Bedrock دقیقاً یکسان نیستند. اگر پرامپتها به شدت تنظیم شده باشند، بازگشتها ممکن است پاسخهای ضعیفتری تولید کنند.
۳. بارهای ساختاری: اگر تقاضای حالت پایدار شما ۳ میلیون ITPM است و سقف شما ۲ میلیون است، هیچ روش بازگشت یا مسیریابی این را حل نمیکند. شما به افزایش لایه یا ظرفیت متعهد شده نیاز دارید.
۴. واقعیت بنچمارکها: در حالی که Bifrost ادعا میکند در ۵,۰۰۰ RPS تنها ۲۰ میکروثانیه تأخیر اضافه میکند، اینها بنچمارکهای داخلی هستند. همیشه تستهای خودتان را اجرا کنید.
چکلیست حل محدودیتهای نرخ
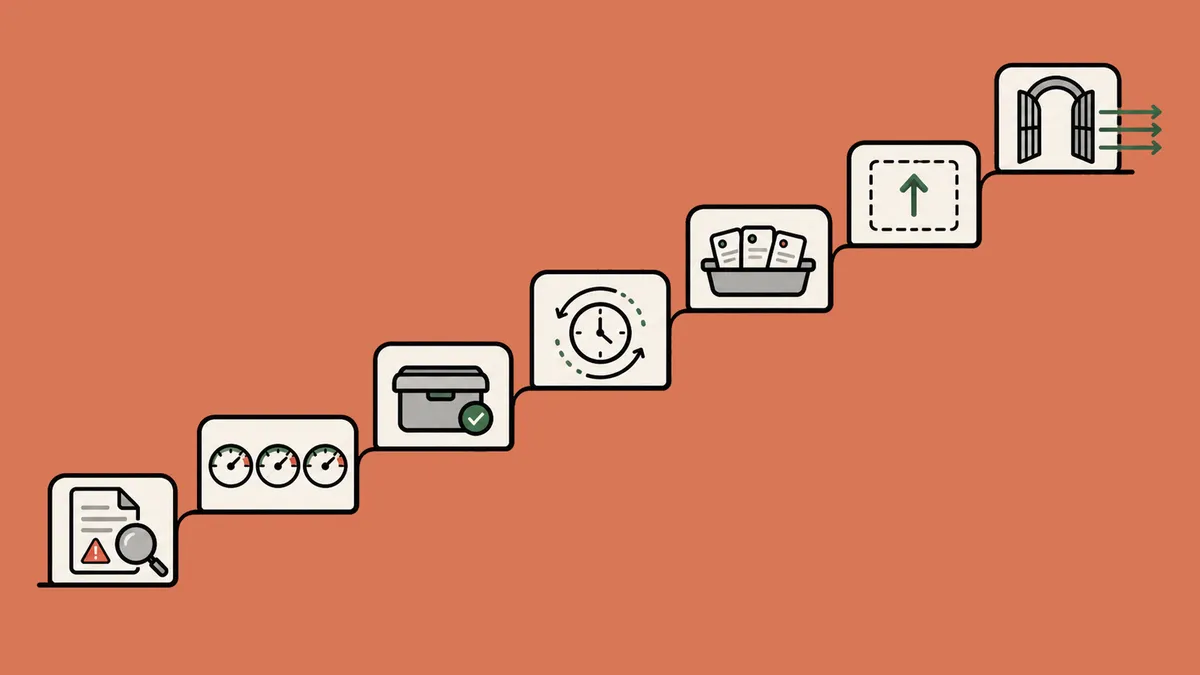
برای حل بهینه، این ترتیب عملیات را از ارزانترین به گرانترین دنبال کنید:
۱. ثبت کامل بدنه خطا: بررسی برای retry-after. اگر در ۴۲۹ نبود، شما سقف هزینه دارید.
۲. استخراج هدرها: از anthropic-ratelimit-*-remaining به عنوان گیجهای نظارتی استفاده کنید.
۳. فعالسازی حافظهٔ پرامپت: نرخ Hit-rate خود را در صفحه Usage بررسی کنید. این بزرگترین برد برای ITPM است.
۴. پیادهسازی بازگشت با لرزش (Jitter): مطمئن شوید که بازگشتها را روی بازگشتهای SDK روی هم نمیاندازید.
۵. استفاده از Message Batches API: کارهای غیرتعاملی را به اینجا منتقل کنید تا از محدودیتهای نرخ جداگانه استفاده کنند.
۶. درخواست ارتقای لایه (Tier Increase): این کار رایگان اما کند است؛ فرآیند را زود شروع کنید.
۷. استقرار درگاه هوش مصنوعی: تجمیع کلیدها یا کانالها را تنها زمانی انجام دهید که واقعاً سقف ظرفیت خود را از دست دادهاید.
این تغییر در زیرساخت به این معناست که برای اکثر توسعهدهندگان، «سقف» دیگر یک محدودیت سخت نیست، بلکه یک مسئله مسیریابی است. با تبدیل ظرفیت به یک منبع توزیعشده در بین تامینکنندگان، هوش مصنوعی در محیط عملیاتی میتواند بدون شکنندگیِ یک کلید API واحد، مقیاسپذیر شود.



گفتگو