تصور کنید ساعتها وقت صرف خواندن مستندات یک کتابخانه میکنید، اما وقتی دستور را اجرا میکنید، متوجه میشوید متغیرهای محیطی تغییر کردهاند یا دستورات تغییر نام یافتهاند و هیچچیز کار نمیکند. در حالی که مستندات اغلب وعده ویژگیهایی را میدهند که کد به دلیل تغییرات جدید دیگر از آنها پشتیبانی نمیکند، README Clew 2 اکنون اجازه میدهد یک مخزن عمومی JavaScript یا TypeScript در عرض چند ثانیه برای این «انحراف مستنداتی» (README drift) مورد بازرسی قرار گیرد. این ابزار مستقیماً یک نقطه درد رایج برای توسعهدهندگان را حل میکند: شناسایی جاهایی که مستندات و پیادهسازی کد از یکدیگر فاصله گرفتهاند.
مستندات زمانی به یک نقطه ضعف تبدیل میشوند که با «منبع حقیقت» (Source of Truth) یعنی کد، در تضاد باشند. اکثر توسعهدهندگان برای بهروزرسانی مستندات به بهروزرسانیهای دستی یا مدلهای زبانی عمومی (LLM) تکیه میکنند که اغلب دچار توهم (Hallucination) میشوند؛ یعنی با اطمینان ادعا میکنند بستهای نصب شده است در حالی که در واقعیت چنین نیست. README Clew 2 این حدس و گمان را با یک خط لوله ترکیبی از یک مدل تصمیمگیر کوچک و تأییدکنندههای سختافزاری (Hard-coded) جایگزین کرده است.
این پروژه در بازه ۶ تا ۱۱ اکتبر ۲۰۲۶ و در جریان هکاتون «What Would Jev Do?» توسعه یافت. برای ساخت این ابزار از AdaL استفاده شده است؛ یک عامل (Agent) کدنویسی از شرکت SylphAI. معماری سیستم بهگونهای طراحی شده است تا اطمینان حاصل شود که یک مدل هوش مصنوعی هرگز کلمه نهایی را درباره اینکه چه چیزی در کد «حقیقت» است، نگوید.
زمینه و ریشهها
این پروژه نه با یک مشکل، بلکه با یک مدل و یک ضربالاجل زمانی آغاز شد. نویسنده در ابتدا بررسی کرد که آیا اپلیکیشنهای قطعی (Deterministic) حاصل از اجرای «Hot AR Summer» یا پروژههای دیگری مانند Dewey, Pun Court, Sortes, Which Door یا Saint of Small Things را بازسازی کند یا خیر. ابزارهای حقوقی نیز از فهرست ایدهها حذف شدند. اکثر این ایدهها معیارهای داوری را که نیازمند «دلیلی روشن برای وجود پروژه» بود، پاس نکردند.
سپس نویسنده به مشکلی از ماه می بازگشت: نسخه اول README Clew. آن نسخه دو محدودیت صادقانه داشت. اول اینکه به یک قانون پرامپت تکیه میکرد و از Claude میخواست مستندات را کلمه به کلمه نقل کند، به جای اینکه بررسی کد انجام دهد. دوم اینکه اغلب برچسبهای متنی مانند «Frontend (Vite)» را به اشتباه به عنوان نام بسته شناسایی میکرد و منجر به اتهامات نادرست میشد. هر دوی اینها مشکلات برچسبگذاری بودند؛ دقیقاً همان تخصص مدل Jev.
نام «clew» (که مانند clue تلفظ میشود) به معنای کلافی از نخ است. در اساطیر یونان، آریادنه به تسیوس یک کلاف نخ داد تا راه خروج از هزارتو را پیدا کند. به همین ترتیب، README Clew نخِ هر خط از مستندات را تا رسیدن به کد دنبال میکند. این نام همچنین نام مجموعه گستردهتری از ابزارهای فناوری مدنی (Civic Tech) نویسنده است.
خط لوله تأیید
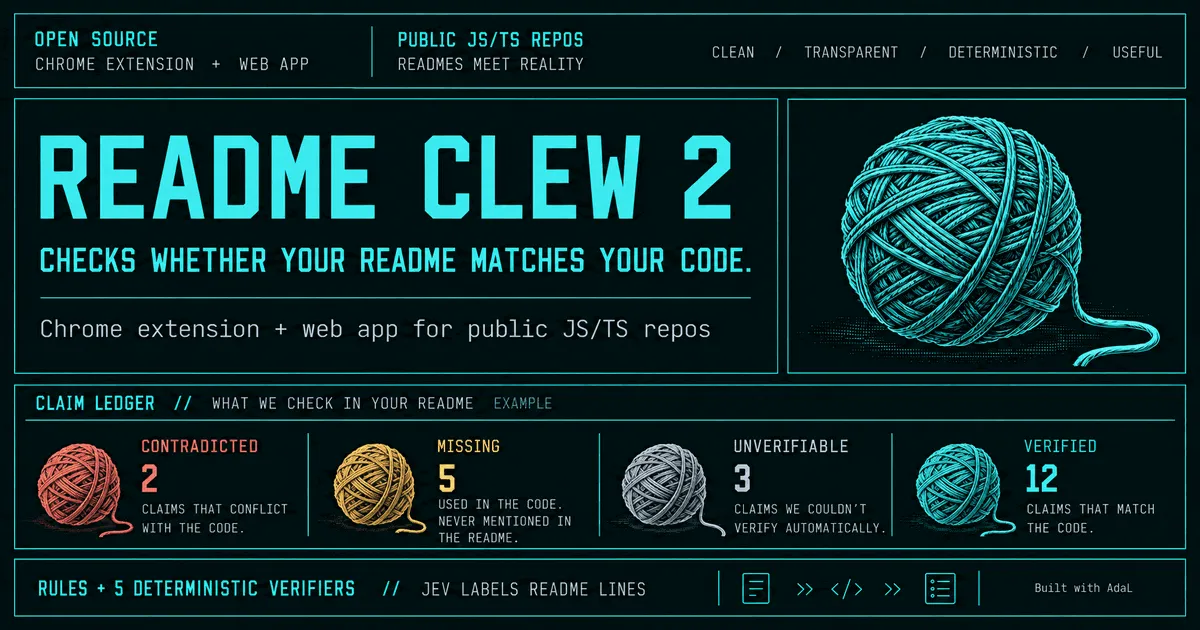
سیستم با تقسیم یک README به خطوط مجزا و مرتب کردن آنها در چهار دسته (Bucket) متمایز عمل میکند:
- تأیید شده (Verified): ادعای مستندات و کد با هم مطابقت دارند.
- متناقض (Contradicted): مستندات ادعایی دارد، اما کد آن را رد میکند.
- مفقود (Missing): کد قابلیتی را اجرا میکند، اما مستندات هرگز به آن اشاره نکرده است.
- غیرقابل تأیید (Unverifiable): هیچ بررسی کدی نمیتواند آن را تست کند، یا Jev مطمئن نبود که این خط از چه نوعی است.
هر ردیف در دفتر ثبت ادعاهای نهایی، خط دقیق README، شواهد موجود در کد و شخصی که درباره نتیجه تصمیم گرفته است (خواه یک قانون سختافزاری باشد یا مدل Jev) را نشان میدهد.
نقش Jev و Glasser
در قلب فرآیند برچسبگذاری، مدل Jev قرار دارد؛ یک مدل تصمیمگیر کوچک از شرکت TypeSafe که از طریق سرویس Glasser در دسترس است. DigitalOcean مدل Jev را به عنوان «مدل هوش مصنوعی که نمیتواند حتی یک جمله بنویسد» توصیف میکند، و دقیقاً همین ویژگی، هسته کاربردی آن است. برخلاف مدلهای زاینده (Generative)، Jev متن تولید نمیکند؛ بلکه یک سؤال، مجموعهای از قوانین و مجموعهای ثابت از برچسبها را میگیرد، سپس یک برچسب را انتخاب کرده و یک امتیاز اطمینان بین ۰ و ۱ ارائه میدهد. این رویکرد در ۳۳ پروژه منتخب برای پیادهسازی تصمیمات محدود به دقت بررسی شده تا کارایی مدل در محیطهای عملیاتی به اثبات برسد.
مدل Jev شناسایی میکند که آیا یک خط مربوط به یک وابستگی (Dependency)، یک دستور (Command)، یک متغیر محیطی، یک فایل یا یک URL است. برای جلوگیری از اتهامات نادرست، سیستم تنها زمانی یک خط را به بررسیکننده کد میفرستد که Jev حداقل ۰.۸ اطمینان به برچسب خود داشته باشد. اگر اطمینان به زیر این آستانه سقوط کند، خط بهطور خودکار به عنوان «غیرقابل تأیید» علامتگذاری شده و تگ «Jev مطمئن نبود» میخورد.
تأییدکنندههای قطعی (Deterministic)
زمانی که Jev یک ادعا را برچسبگذاری کرد، پنج تأییدکننده قطعی وارد عمل میشوند. این بررسیکنندهها فایل package.json، درخت فایلها و کد منبع را میخوانند تا یک پاسخ دوتایی (بله/خیر) ارائه دهند. این امر تضمین میکند که ورودی یکسان همیشه نتیجه یکسانی تولید کند و ماهیت احتمالی (Stochastic) مدلهای زبانی بزرگ را از فرآیند داوری حذف میکند.
برای سختتر کردن سیستم، نویسنده یک «قانون نثر» (Prose Rule) پیادهسازی کرد. اگر نام یک بسته فقط در متن نثر ظاهر شود و نه به عنوان یک ادعای مجزا، هرگز نمیتواند به عنوان «متناقض» علامتگذاری شود، صرفنظر از میزان اطمینان Jev. این کار مانع از آن میشود که ابزار، متون توصیفی را به عنوان خطای فنی گزارش کند.
مدل Claude Haiku برای نوشتن یک خلاصه کوتاه در پایان، تنها بر اساس تعدادها و نامها استفاده میشود. از آنجایی که Haiku هرگز خطوط واقعی README را نمیبیند، سیستم در برابر تزریق پرامپت (Prompt Injection) یا دستورات کاشته شده در داخل یک README مصون است.
توسعه عاملمحور با AdaL
فرآیند ساخت این ابزار، وضعیت فعلی جریانهای کاری عاملمحور (Agentic) را برجسته میکند. AdaL بخش عمدهای از کدنویسی، تولید تستها و استقرار در Vercel را بر عهده داشت، در حالی که Claude (Opus 5.5) معماری را مدیریت کرد، مشخصات فنی (Spec) را نوشت و در هر نقطه بازرسی، کار AdaL را بازبینی کرد.
عامل AdaL بر اساس یک فایل AGENTS.md عمل میکرد که در هر نوبت آن را میخواند و یک پروتکل سختگیرانه را دنبال میکرد: ابتدا پیشنهاد بده، هر بار فقط یک بلوک کد بنویس، فقط فایلهای نامگذاری شده را تغییر بده و برای نقاط بازرسی QA متوقف شو. برای جلوگیری از مشکل «فایل خدایگان» (God File) که در کدهای تولید شده توسط AI رایج است، نویسنده یک سقف سختگیرانه ۲۰۰ خط برای هر فایل از طریق یک تست شکستخورده اعمال کرد.
عامل AdaL همچنین باگها را بهطور مستقل کشف کرد. این عامل متوجه شد که Glasser تعداد درخواستها را به ۱۰۰ سؤال محدود میکند (محدودیتی که در API زنده بود اما در Schema ذکر نشده بود)، یک تایمری را یافت که اجازه میداد تستها به جای شکست خوردن، لغو شوند، یک ابزار برش (Trimmer) را پیدا کرد که نسخه اشتباهی از متن را اندازهگیری میکرد و دو باگ در چیدمان (Layout) را شناسایی کرد. برای رفع مشکلات چیدمان، AdaL بهطور خودکار از ابزار مرورگر خود برای گرفتن اسکرینشات و زمانبندی صفحه استفاده کرد.
هزینههای توسعه و بهرهوری
فرآیند توسعه شامل تکرار و تستهای گستردهای بود. نویسنده درخواست کرد که هر تست باید یک بار در حالت شکست (Failing) نمایش داده شود؛ یعنی کد عمداً خراب شود تا تست قرمز شود و سپس بازیابی شود. این رویکرد منجر به حجم بالای تستها شد:
- بلوک ۱: ۱۰۲ تست (۷۵ شکست عمدی)
- بلوکهای ۳ و ۴: ۱۹۷ تست
- اصلاح Monorepo: ۲۲۲ تست
- قبل از صیقل دادن UI: ۳۵۳ تست
- شنبه شب: ۴۵۲ تست
- ارسال نهایی: ۴۷۴ تست
این رویکرد سختگیرانه هزینه واقعی در زمان عامل (Agent Time) داشت. تا شنبه شب، نویسنده ۳۶ دلار از سقف ۵۰ دلاری را تنها در سه ساعت و نیم هزینه کرده بود. برای بهینهسازی، یک «حالت لین» (Lean Mode) پیاده شد: جلسات تازه برای هر بلوک، خواندن تنها فایلهای ضروری و اجرای QA مرورگر تنها یک بار در پایان. این کار هزینه ساخت باقیمانده را به حدود ۴ دلار کاهش داد و مجموع صورتحساب عامل را به ۴۰.۳۵ دلار رساند. در مقابل، هزینه نهایی اپلیکیشن برای کاربر نهایی در هر اسکن تقریباً ۰.۰۰۹ دلار است. این بهینهسازی در هزینهها با استراتژی کلی TypeSafe همسو است که در آن مدل Jev هزینههای استنتاج را تا ۴۴۴ برابر کاهش داده است تا استفاده از هوش مصنوعی در مقیاس بالا اقتصادی شود.
تستهای دنیای واقعی و شکستها
در اولین تست واقعی روی مخزن نسخه ۱ (v1) خود نویسنده، ابزار در ابتدا با گزارش هفت تناقض نادرست شکست خورد. مشکل از ساختار pnpm monorepo ناشی میشد که در آن مکانیاب Workspace برخی پوشهها را نمیشناخت و گزینه --filter در pnpm به اشتباه به عنوان نام یک اسکریپت خوانده میشد.
پس از اصلاح توسط AdaL، ابزار بهدرستی چهار بسته مفقود در مخزن v1 و ۱۴ بسته مفقود در مخزن polka را شناسایی کرد. این موارد به پوشههای examples مربوط میشدند که فایلهای package مخصوص به خود را داشتند.
سختگیرانهتر کردن سیستم، دو تناقض نادرست احتمالی دیگر را برطرف کرد: متغیرهای محیطی که در فایلهایی فراتر از حد خواندن ۲۰ فایل استفاده شده بودند، و READMEهایی که به خروجیهای Build (مانند dist/) اشاره میکردند که هرگز کامیت نمیشوند. هر دوی این موارد اکنون به جای «متناقض»، به عنوان «غیرقابل تأیید» برمیگردند.
محدودیتهای فنی
طبق مستندات پروژه، ابزار محدودیتهای عملیاتی خاصی دارد:
- پشتیبانی از زبان: محدود به JavaScript و TypeScript است زیرا
package.jsonبستهها و دستورات را متمرکز میکند. در مقابل، پایتون این حقایق را در چندین فایل اختیاری پخش میکند. - عمق اسکن: در هر اسکن حداکثر ۲۰ فایل منبع را میخواند.
- اندازه فایل: READMEهای بالای ۵۰ کیلوبایت قطع (Truncate) میشوند.
- محدودیت Workspace: از الگوهای ساده Workspace پشتیبانی میکند و تا ۳۰ Workspace در یک monorepo را میپذیرد، پیش از آنکه وضعیت را به «غیرقابل تأیید» تغییر دهد.
- عدم وجود بج (Badge): ابزار بج وضعیت ارائه نمیدهد زیرا هر بار که صفحه مشاهده شود یک اسکن هزینهبر را فعال میکند و حافظهای برای کش کردن نتایج وجود ندارد.
دسترسی و حریم خصوصی
این ابزار به سه روش در دسترس است:
۱. صفحه زنده: بهترین گزینه برای مشاهده دفاتر ثبت کامل یا استفاده در موبایل.
۲. افزونه کروم: بازرسی با یک کلیک در حالی که در صفحه یک مخزن گیتهاب هستید.
۳. Bookmarklet: طراحی شده برای کامپیوترهای کاری محدود شده که افزونهها را مسدود میکنند.
سیستم بدون پایگاه داده یا حساب کاربری عمل میکند و اسکنها ذخیره نمیشوند. کاربران میتوانند از ویژگی DOWNLOAD JSON برای دریافت گزارشی همراه با رسید اسکن استفاده کنند که شامل مخزن، کامیت، اثرانگشت متن README و اثرانگشت گزارش است تا اطمینان حاصل شود که گزارش ویرایش نشده است. این مدل عملیاتی باعث شده تا هزینه تصمیمگیری به ۰٫۰۴۲ دلار برای هر میلیون توکن برسد و ابزار برای توسعهدهندگان بسیار ارزان باشد.
این رویکرد، پارادایم مستندات را از یک فایل متنی ایستا به یک دفتر ثبت قابل تأیید تغییر میدهد. با جداسازی «برچسبگذاری» (توسط AI) از «تأیید» (توسط کد)، مدل اعتمادی ایجاد میشود که در آن هوش مصنوعی پیشنهاد میدهد چه چیزی بررسی شود، اما کد تصمیم میگیرد که نتیجه چیست.
گام بعدی شما
- اگر مخزن JS/TS دارید، آن را با README Clew 2 اسکن کنید تا شکافهای مستنداتی را بیابید.
- برای پروژههای بزرگتر، ساختار فایلهای خود را به گونهای تغییر دهید که متغیرهای محیطی در یک فایل متمرکز باشند تا نرخ «غیرقابل تأیید» کاهش یابد.
- بررسی کنید آیا مدلهای تصمیمگیر کوچک (SLM) میتوانند جایگزین مدلهای زبانی بزرگ در بخشهای حساسِ تأیید کد شما شوند؟
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو