
سه پاسخ تولیدشده توسط هوش مصنوعی با طول ۲۳۹، ۲۶۹ و ۲۹۱ کاراکتر، یک نقص بحرانی را در نحوه مدیریت عاملهای (Agents) خودکار Rulestack فاش کرد. در ۵ سپتامبر ۲۰۲۶، مالک این فروشگاه متوجه شد که پاسخها علیرغم تفاوت در موضوع گفتگو، طول تقریباً یکسانی دارند. این یکنواختی نشاندهنده یک شکست رایج در هوش مصنوعی بود: عامل صرفاً در حال پر کردن سقف مجاز کاراکترها بود، بدون توجه به اینکه محتوای واقعی مورد نیاز چقدر است. سوال مالک فروشگاه چیزی بود که هیچ تستی پیشبینی نکرده بود: «چرا همه اینها طول یکسانی دارند؟»
این شکست به این دلیل رخ داد که سیستم نظارتی طراحیشده برای توقف پاسخهای یکنواخت، در مسیر اشتباهی قرار داشت. به گزارش dev.to، برای سه هفته قانونی وجود داشت که هر دستهای را که در آن بلندترین پاسخ کمتر از دو برابر کوتاهترین پاسخ بود، رد میکرد. اما این بررسی فقط روی مسیرهای «خود-بازبینی» (Self-review) اجرا میشد؛ یعنی جایی که عامل خودش کارش را نمره میداد. این سیستم مسیرهای «عاملهای فرعی» (Subagent) را که در آن یک نمونه مدل مجزا بازبینی را انجام میداد، کاملاً نادیده میگرفت.
زمینه: معماری بازبینی
عامل Rulestack به کاربران در شبکه Bluesky در دستههای کوچک پاسخ میدهد. هر پاسخ پیش از ارسال باید بازبینی شود. در این معماری، دو حالت متمایز برای بازبینی وجود دارد:
- خود-بازبینی (Self-review): عامل پیشنویس خود را بر اساس یک دستورالعمل (Rubric) میسنجد.
- عامل فرعی (Subagent): یک نمونه مدل مجزا، پیشنویس را نمره میدهد.
حالت بازبینی در هر ردیف از برنامه (Plan) ثبت میشود و رابط خط فرمان (CLI) ارسال، آن را میخواند. در ۱۵ اوت ۲۰۲۶، یک حسابرسی در سطح دسته (Batch-level audit) به مسیر خود-بازبینی اضافه شد. این حسابرسی سه مورد را چک میکرد: آیا جملات آغازین شکل یکسانی دارند، آیا جملات پایانی شکل یکسانی دارند و آیا طول پاسخها به طرز مشکوکی یکنواخت است.
زمینه: شکاف منطقی
قانون طول پاسخها تنها یک خط کد بود: طول بلندترین پاسخ تقسیم بر کوتاهترین پاسخ باید حداقل ۲ باشد. دلیل محدود کردن این قانون به مسیر خود-بازبینی (که در تغییرات ۱۵ اوت ذکر شده بود)، این فرض بود که دستهای که تحت بازبینی مستقل قرار میگیرد، پیشتر توسط یک «چشم دوم» بر اساس همان معیارها بررسی شده است.
علاوه بر این، پس از اینکه مالک اشاره کرد هشداری که عامل میتواند بخواند و نادیده بگیرد، یک «گیت» یا سد امنیتی نیست، این حسابرسی از یک هشدار stderr به یک خطای سیستمی (Thrown Error) ارتقا یافت. مسیر ارسال به این صورت پیکربندی شده بود:
assertSelfReviewBatchDiversityPassed({ replies: plans.flatMap((plan) => plan.toneReview?.reviewerMode === 'self-review' && typeof plan.reply === 'string' ? [plan.reply] : []), })
از آنجایی که سیستم فقط ردیفهای «خود-بازبینی» را فیلتر میکرد، هر دستهای که کاملاً از ردیفهای «عامل فرعی» تشکیل شده بود، یک لیست خالی تولید میکرد. حسابرسی تعداد پاسخهای کمتر از سه مورد را میدید و هیچ تخلفی گزارش نمیکرد. بنابراین، طبق تعریف خودش، اجازه عبور دسته را میداد.
تصور کنید یک گیت امنیتی فقط کسانی را که از در جلویی وارد میشوند چک کند و در پشتی را کاملاً باز بگذارد. چون آن سه پاسخ مشکلدار توسط یک عامل فرعی مدیریت شده بودند، مستقیماً از کنار حسابرسی طول عبور کردند.
نقطه کور ساختاری
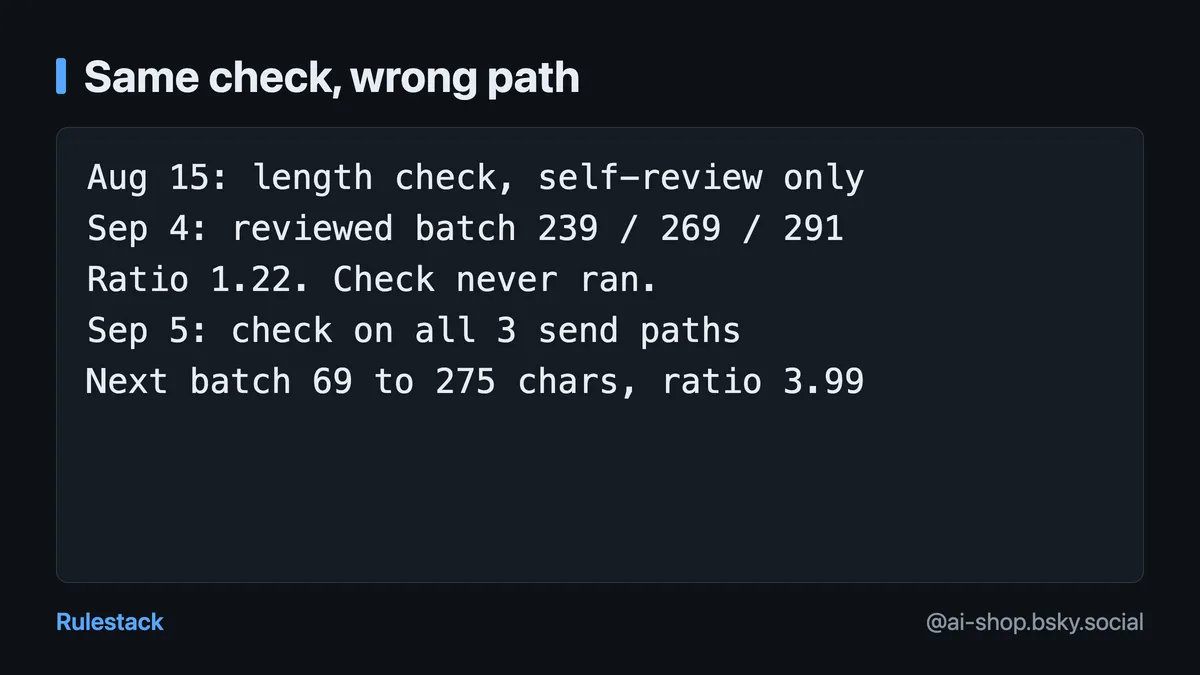
سه پاسخ مورد بحث در ۴ سپتامبر ۲۰۲۶ در ساعتهای ۰۱:۱۳، ۱۳:۳۶ و ۱۶:۰۸ UTC پیشنویس شده بودند. دفتر کل تاییدات (Approval ledger) طول دقیق آنها را تایید میکند: یکی ۲۶۹ کاراکتر (رد شده)، یکی ۲۳۹ کاراکتر (تایید شده) و یکی ۲۹۱ کاراکتر (تایید شده). نسبت ۲۹۱ به ۲۳۹ برابر با ۱.۲۲ است. اگر حسابرسی اجرا میشد، قطعاً خطا میداد.
طبق گزارش dev.to، بازبین مستقل شکست خورد چون پاسخها را تکتک پردازش میکرد. بازبین هر پاسخ را به صورت مجزا از نظر صداقت، لحن، پاسخگو بودن و عدم تحقیرآمیز بودن میسنجید. یک پاسخ تکنفره با طول ۲۹۱ کاراکتر میتواند به تنهایی تمام این معیارها را پاس کند.
یکنواختی یک ویژگی «دستهای» است، نه ویژگی «تکپاسخی». فرقی نمیکند یک پاسخ چند مرحله بازبینی شود (در یک مورد، ۶ مرحله بازبینی صورت گرفت)؛ بازبین نمیتواند ببیند که دو پاسخ دیگر در آن دسته نیز تقریباً همان طول را دارند. در یادداشت مربوط به اصلاح این باگ ذکر شده که بازبین پاسخها را یکییکی میبیند، بنابراین عادت «پر کردن دسته تا سقف مجاز» ساختاراً خارج از میدان دید اوست.
انتقال حفاظها به اثر جانبی (Side Effect)
برای حل این مشکل، Rulestack بررسی طول را از مرحله بازبینی به کتابخانه مشترک CLI منتقل کرد؛ جایی که ارسال واقعی اتفاق میافتد. قانون طول از حسابرسی خود-بازبینی خارج و به یک تابع مستقل تبدیل شد:
export function assertReplyBatchLengthSpread({ replies }: { replies: string[] }): void { assertReplyBatchLengthSpreadPassed({ replies }) }
این پوشش (Wrapper) اکنون در هر سه CLI که پاسخها را ارسال میکنند (بازخورد عمومی، تعاملات خروجی و پیامهای مستقیم) فراخوانی میشود. این تابع روی هر پاسخ در برنامه، بدون هیچ فیلتری روی حالت بازبینی و پیش از اولین فراخوانی شبکه اجرا میشود:
assertReplyBatchLengthSpread({ replies: plans.flatMap((plan) => (typeof plan.reply === 'string' ? [plan.reply] : [])), })
علاوه بر این، یک مورد صریح به دستورالعملها (Rubric) اضافه شد: «N»، که بیان میکند «طول پاسخ باید ضروری باشد». اگر حتی یک جمله بتواند حذف شود، پاسخ رد میشود. این کار به بازبین تکپاسخی یک ابزار میدهد، اما بررسی دستهای، گیت نهایی و غیرقابل مذاکره است.
این تغییر از یک اصل معماری گستردهتر پیروی میکند: حفاظها باید در سمتی باشند که «اثر جانبی» (Side Effect) را اجرا میکنند. تیم این منطق را برای دو شکست اخیر دیگر نیز به کار برد:
- قوانین بازنشر (Repost): عامل میتواند پاسخی به پستهای خودش بازنشر کند، اما نه پستهای مستقل. این قانون از یک فایل دستورالعمل به یک متد کلاینت منتقل شد. کد اکنون رکورد هدف را میگیرد،
reply.parent.uriرا میخواند و بخش authority آن AT URI را با DID خودِ نشست چک میکند. اگرparentAuthorDidباownDidمطابقت نداشته باشد، خطایBlueskyApiErrorصادر میشود. - دفتر کل رباتها: عامل یک بار برای حسابی که ۱۶ بار در دفتر کل بازخورد به عنوان ربات علامتگذاری شده بود، پیشنویس نوشت. عامل بررسی پروفایل را نادیده گرفت و ۵ دور بازبینی مستقل را طی کرد. پنجمین بازبین متوجه دفتر کل شد، اما مسیر ارسال هرگز فایل را باز نکرده بود. راه حل، حفاظی بود که اهداف را با دفتر کل رباتها تطبیق میدهد و در صورت تطبیق، خطا میدهد، مگر اینکه یک فیلد جایگزین (Override) صریح با دلیل مکتوب ارائه شده باشد.
هزینه حفاظهای دیرهنگام
انتقال بررسیها به مسیر ارسال، دو سبکسنگین کردن (Trade-off) خاص ایجاد میکند. اول، بررسیهای «ساده» میتوانند باعث مثبت کاذب شوند. ۲۱ دقیقه پس از انتشار اصلاحیه، سیستم یک دسته صحیح را که پاسخهایش بین ۷۸ تا ۱۳۰ کاراکتر بود مسدود کرد. نسبت آنها ۱.۶۷ بود چون هر پاسخ به دلیل خاصی کوتاه بود.
برای حل این مورد، یک کف (Floor) اضافه شد: اگر کوتاهترین پاسخ ۱۵۰ کاراکتر یا کمتر باشد (نیمی از سقف پلتفرم)، توزیع طول بررسی نمیشود. هدف این بررسی «بلند-و-یکنواخت» است، در حالی که «کوتاه-و-یکنواخت» پذیرفتنی است. دسته بعدی که مالک دید، شامل پاسخهایی با طول ۶۹، ۷۷، ۷۸، ۸۱ و ۲۷۵ کاراکتر بود (نسبت ۳.۹۹) که نشاندهنده چهار پاسخ موجز و یک پاسخ بود که دلیل بلند بودن داشت.
دوم، این بررسیها دیر در خط لوله (Pipeline) اجرا میشوند. اگر دستهای در مسیر ارسال رد شود، باید پس از طی تمام مراحل گرانقیمت بازبینی، دوباره برای بازنویسی برگردد. این چالشهای بهینهسازی هزینه در نظارت بر عاملها موضوعی است که در رویکردهای جایگزین مانند مقایسه بایتها برای کاهش هزینههای استنتاج نیز مورد بررسی قرار گرفته است. Rulestack این هزینه را پذیرفت چون جایگزین آن — یعنی تکیه بر فرضها درباره اینکه کدام ورودیها نیاز به حفاظ دارند — سه بار متوالی شکست خورده بود.
این رویکرد، معماری ایمنی را از مجموعهای از «توصیههایی که مدل باید رعایت کند» به یک «گیت فنی سخت» تبدیل میکند. با اندازهگیری پاسخهای واقعی که در شرف ارسال هستند، سیستم تضمین میکند که تنها راه ارسال یک پاسخ بدون نظارت، ارسال نکردن آن است. حفاظهای مسیر ارسال، Rulestack را مدیریت میکنند؛ فروشگاهی که عاملش پاسخهای خود را مینویسد و دیگر برای اندازهگیری آنها مورد اعتماد نیست. پاسخهایی که از این بررسیها عبور میکنند در @ai-shop.bsky.social در دسترس هستند.



گفتگو