تصور کنید یک ربات استخراج داده (Scraper Bot) تمام ویژگیهای مرورگر شما را تقلید کند، اما یک اشتباه کوچک در نحوهٔ پایین کشیدن صفحه، هویت واقعیاش را لو بدهد. تفاوت بنیادین در اینجاست: انسانها با جهشهای نامنظم و غیرخطی اسکرول میکنند، اما اکثر رباتها در الگوهای پیشبینیپذیر و خطی حرکت میکنند.
به گزارش پژوهشگری در niki.cat، تحلیل این الگوهای رفتاری میتواند رباتهایی را که در ظاهر انسانی به نظر میرسند، شناسایی کند. این روش از فرمولهای ریاضی خاص برای محاسبهٔ «انفجاری بودن» (Burstiness - B) و «حافظه» (Memory - M) استفاده میکند تا فریب رباتها را بشکند و ماهیت آنها را آشکار سازد.
زمینه و مبانی نظری
این پژوهش از مقالهٔ سال ۲۰۰۸ با عنوان «انفجاری بودن و حافظه در سیستمهای پیچیده» اثر کوانگ-ایل گوه و آلبرت لاسزلو باراباسی الهام گرفته است. این فرمولهای ریاضی اجازه میدهند سیستمهای مبتنی بر رویداد — مانند زمان ارسال ایمیلها، پیامهای متنی یا حتی ضربان قلب — تنها در صورتی که برچسبهای زمانی (Timestamps) رویدادها مشخص باشد، تحلیل شوند.
این چارچوب ریاضی کمک میکند تا مشخص شود کدام الگوها رفتاری انسانی هستند. برای مثال، انسانها معمولاً به پیامهای متنی بهصورت «انفجاری» پاسخ میدهند؛ به این معنا که فاصله زمانی بین پاسخها یکنواخت نیست. در مقابل، رباتهای ساده سعی میکنند در سریعترین زمان ممکن پاسخ دهند، که این امر منجر به ثبت ضرایب B و M کاملاً متفاوتی میشود.
بیشتر سیستمهای شناسایی ربات امروز بر تشخیص مرورگرهای بدون رابط گرافیکی (Headless Browsers) یا نبود فایلهای CSS و JS متکی هستند. اما عاملهای پیشرفتهای مثل ClaudeBot میتوانند با استفاده از محیطهای کامل مرورگر، این لایههای کنترلی را دور بزنند. پژوهشهای قبلی که بر تحلیل زمان درخواستها (Request Timings) متکی بودند، اغلب شکست خوردند؛ زیرا آنها صرفاً تفاوت بین یک درخواست دستساز (Crafted Request) و درخواستی که از یک مرورگر واقعی ارسال شده بود را تشخیص میدادند، نه تفاوت بنیادین بین یک ربات و یک انسان را.
برای حل این مشکل، پژوهشگر از مجموعه دادههای مقالهٔ «FP-Agent: Fingerprinting AI Browsing Agents» اثر اتان وانگ و همکارانش استفاده کرد. نویسندگان آن مقاله یک مدل یادگیری ماشین ساخته بودند تا عاملهای مرورگر هوش مصنوعی را در یک محیط کنترلشده و با استفاده از یک وبسایت اختصاصی تشخیص دهند. اگرچه پژوهشگر معتقد است که آن مدل ممکن است در دنیای واقعی بهدلیل تنوع وبسایتها دچار مشکل شود، اما مجموعه دادههای موجود در OSF.io زیربنای حیاتی و لازم برای تست رویدادهای اسکرول (Scroll Events) در جاوااسکریپت فراهم کرد.
مکانیزم شناسایی
مکانیزم شناسایی بر دو محور اصلی استوار است:
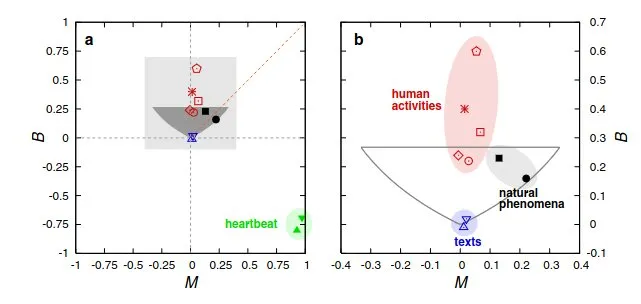
- انفجاری بودن (B): این شاخص عدم یکنواختی زمانبندی رویدادها را میسنجد. انسانها اسکرولهای نامنظم و تکهتکه دارند که «انفجاری بودن» بالایی ایجاد میکند. این الگو در مطالعه گوه و باراباسی بیشتر شبیه به سریهای زمانی 'a' یا 'e' است تا سری 'c'.
- حافظه (M): این شاخص همبستگی بین رویدادهای متوالی را اندازه میگیرد. انسانها در فواصل اسکرول خود تقریباً هیچ حافظهای (الگوی تکرارشونده یا همبستگی منظم) نشان نمیدهند.
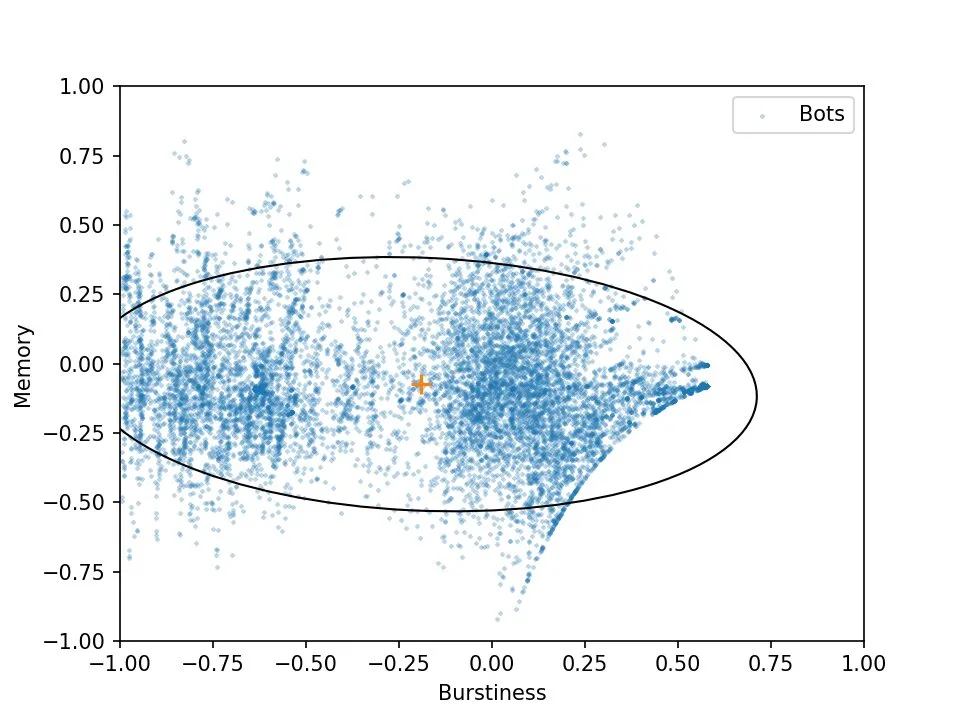
- شکاف رفتاری: اکثر عاملهای هوش مصنوعی در مقایسه با کاربران انسانی، انفجاری بودن بهمراتب کمتر و ضرایب حافظه متفاوتی را ثبت میکنند.
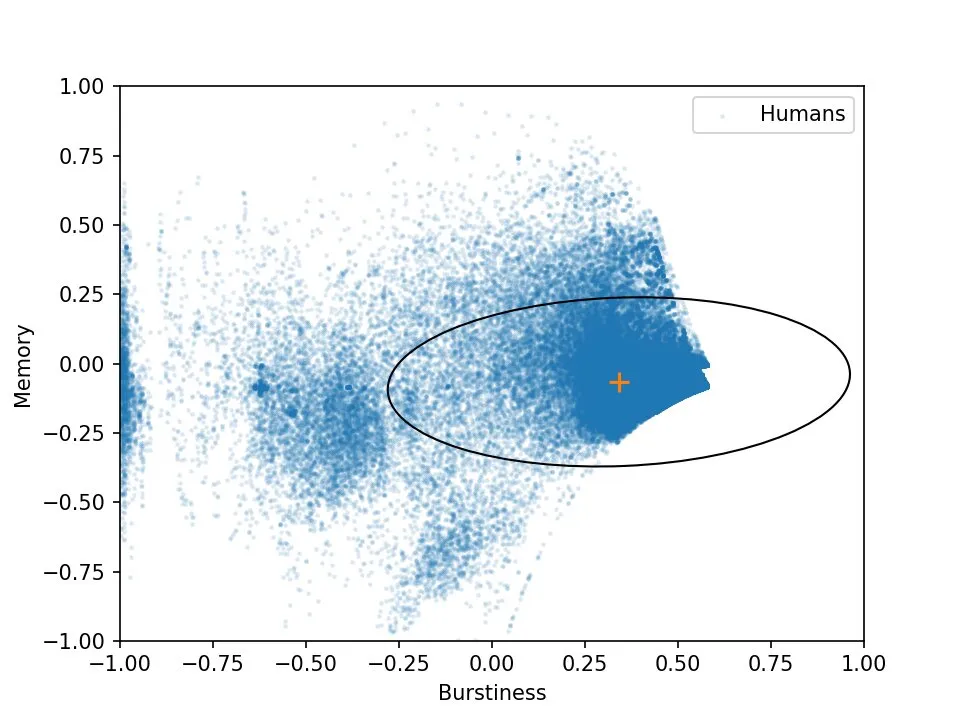
پژوهشگر با استفاده از این دو ویژگی، برای هر عامل و به ازای هر صفحه بازدید شده، یک مقدار انفجاری بودن و یک مقدار حافظه محاسبه کرد. سپس یک مدل LightGBM (که یک مدل تقویت گرادیان درخت تصمیم است) را آموزش داد تا تعاملات را صرفاً بر اساس مقادیر B و M طبقهبندی کند.
نتیجهٔ این آزمایش، صحت (Accuracy) ۷۳.۴ درصدی در طبقهبندی بود.
تحلیل نتایج
تحلیل نتایج نشان میدهد مدل در تفکیک انسان از ChatGPT Agent بیشترین مشکل را داشته است؛ چراکه این ربات انسانیترین رفتار اسکرول را در میان تمام مدلهای تستشده داشت. پژوهشگر اشاره کرد که حجم کم دادهها — حدود ۱۵۰ نقطه داده برای هر عامل — احتمالاً دقت مدل را محدود کرده و منجر به سردرگمی مدل در تشخیص بین انسان و ChatGPT شده است.
این تغییر استراتژی، میدان نبرد را از «ربات چیست» (اثر انگشت مرورگر و مشخصات فنی) به «ربات چگونه عمل میکند» (دینامیکهای رفتاری) منتقل میکند. برای سایتهای حاوی اطلاعات ارزشمند مثل ویکیپدیا یا وبلاگهای شخصی، این روش یک لایه دفاعی جدید و مؤثر در برابر استخراج تهاجمی دادهها (Aggressive Scraping) فراهم میکند.
برای توسعهدهندگان، این به معنای آن است که صرفاً استفاده از یک مرورگر Headless دیگر برای شناس نشدن کافی نیست. برای تقلید واقعی از انسان، سازندگان ربات باید الگوریتمهای اسکرول تصادفی (Stochastic) و پیچیدهای را پیادهسازی کنند که الگوهای جستوجوی شناختی انسان را بازسازی کند. در این مسیر، درک درست از تعامل با ابزارهای هوش مصنوعی ضروری است تا کاربران دچار تلههای بهرهوری در هوش مصنوعی نشوند و زمان خود را در مسیرهای نادرست هدر ندهند.
هرچند صحت ۷۳.۴ درصدی هنوز یک راهکار قطعی و آماده برای محیطهای عملیاتی (Production-ready) نیست، اما شروعی امیدوارکننده است. پژوهشگر پیشنهاد میکند ترکیب دادههای اسکرول با حرکات موس و الگوهای تایپ، میتواند یک مدل جامع و کاربردی برای حفاظت از سایتها در برابر رباتها ایجاد کند.
در آینده منتظر پژوهشهای تکمیلی درباره الگوهای حرکت موس باشید که هدف آن بهبود هرچه بیشتر این رویکرد اثر انگشت رفتاری است.
گام بعدی شما
- اگر مدیر سایت هستید، بررسی کنید آیا ابزارهای فعلی شما فقط روی اثر انگشت مرورگر متکی هستند یا رفتارهای کاربر را تحلیل میکنند.
- توسعهدهندگان ربات باید برای کاهش نرخ شناسایی، از توابع تصادفی (Stochastic) در شبیهسازی تعاملات کاربر استفاده کنند.
- دنبال کنید آیا ترکیب تحلیل موس و کیبورد میتواند دقت شناسایی رباتها را به بالای ۹۰ درصد برساند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو