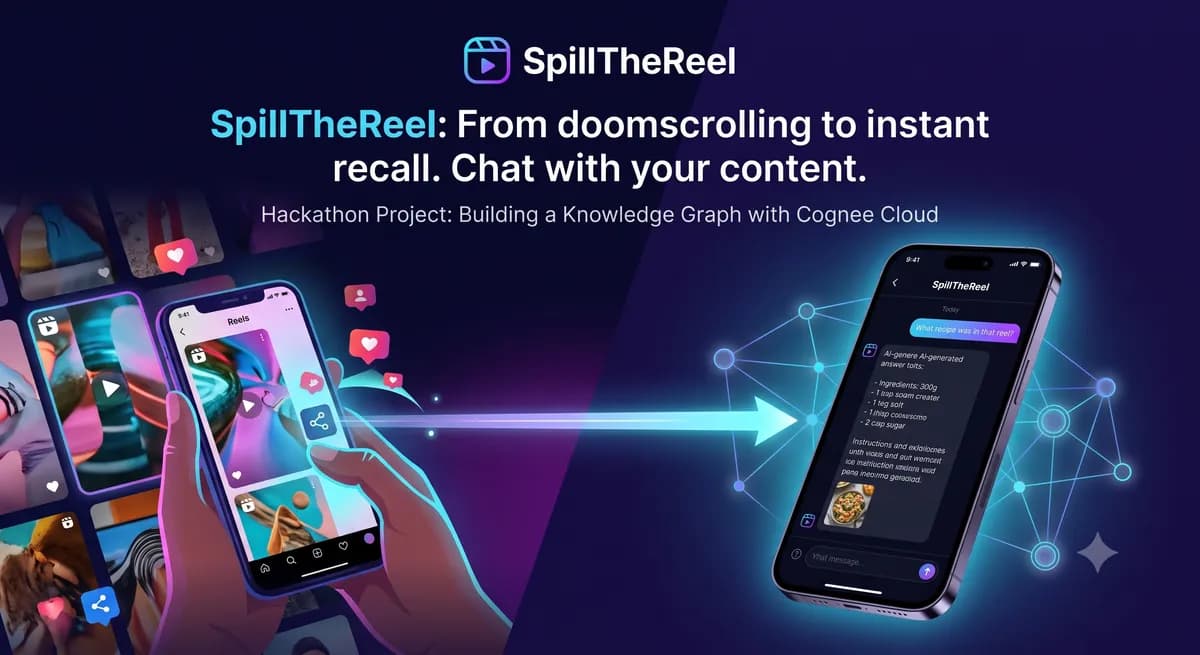
تصور کنید صدها ویدیو از ترفندهای زندگی، دستور پخت غذا و برنامههای ورزشی را در اینستاگرام ذخیره کردهاید، اما هرگز آنها را دوباره پیدا نمیکنید. SpillTheReel آمده است تا این «گورستان دیجیتال» را به یک مخزن دانش شخصی و حاکمیتی تبدیل کند. این ابزار به کاربران اجازه میدهد بهجای اینکه محتوا را به الگوریتمها واگذار کنند، از طریق یک رابط چت، ویدیوهای ذخیرهشدهی خود را مورد پرسوجو قرار دهند.
بیشتر کاربران اطلاعات ارزشمند را در پوشهی Saved رها میکنند و عملاً آنها را از دست میدهند زیرا سازماندهی دستی محتوای حجیم، بیش از حد طاقتفرسا است. تیم توسعهدهنده، پوشهی Saved معمولی را به عنوان قبرستانی دیجیتال توصیف میکند که در آن بیش از ۵۰۰ ترفند زندگی و دستور غذا دفن شدهاند و برای همیشه از دسترس خارج شدهاند. همانطور که در تحلیلهای قبلی ما دربارهی گردشکارهای «مغز دوم» و هزینههای بالای نگهداری سیستمهای مدیریت دانش دستی اشاره کردیم، چالش اصلی همواره در بازیابی سریع اطلاعات (Information Recall) بوده است، نه صرفاً ذخیره کردن آنها. این رویکرد یادآور تلاشهای گستردهتر برای بهینهسازی بازیابی اطلاعات است، مشابه آنچه در پروژه RecallOps برای کاهش زمان بازیابی در محیطهای سازمانی شاهد بودیم.
خط لولهی بدون اصطکاک
طبق گزارشی در ۵ ژوئیه ۲۰۲۶ در وبسایت dev.to، تیم توسعهدهنده برای حذف هرگونه اصطکاک، از یک اپلیکیشن React Native با قابلیت Share Intent بومی سیستمعامل استفاده کرده است. توسعهدهندگان یک «قانون طلایی» را تعریف کردند: اگر کاربر مجبور باشد لینکها را کپی کند و اپلیکیشنهای جدید باز کند، این محصول شکست خواهد خورد. بنابراین، اکنون کاربران بهسادگی دکمهی Share را میزنند و روی آیکون SpillTheReel ضربه میزنند تا محتوا را بدون ترک فید اینستاگرام ذخیره کنند.
چالشهای فنی
در مسیر ساخت این ابزار، تیم با چالشهای مهندسی جدی، بهویژه در زمینه جذب دادهها (Data Ingestion) روبرو شد:
- دیوارهای آتش متا: دیوار آتش (Firewall) سختگیرانهی اینستاگرام برای مقابله با باتها، در ابتدا دسترسیهای بکاند را مسدود میکرد و باعث میشد فایلهای رسانهای خالی بازگردانده شوند.
- راهکار: برای رفع این مشکل، یک استراتژی مبتنی بر Session-cookie پیادهسازی شد تا استخراج رسانهها بهصورت ایمن و بدون ایجاد اختلال یا کرش در سرورهای محلی انجام شود.
- پردازش چندوجهی: فرآیند پردازش دادهها بهصورت چندوجهی (Multimodal) — یعنی مدلی که همزمان متن، عکس و صدا را میفهمد — اجرا میشود. در این زنجیرهی پردازشی، صدا توسط مدل Groq's Whisper پردازش شده و تحلیل بصری توسط یک مدل Vision انجام میگیرد.
معماری حافظه
تیم توسعهدهنده استدلال میکند که پایگاههای داده برداری تخت (Flat Vector Databases) برای شبیهسازی حافظهی انسانی ناکافی هستند. برای عبور از این محدودیت، این سیستم از Cognee Cloud برای لایهی حافظه استفاده میکند. آنها بهجای برخورد با دادهها به عنوان لیستی تخت از تکههای متنی، حافظه را بهمثابه شبکهای از مفاهیم بههمپیوسته میبینند. این معماری در واقع تکراری از روشی است که حافظه ترکیبی گراف-بردار در Cognee برای حل مشکل فراموشکاری عاملهای هوش مصنوعی به کار گرفته است.
پشتهی فنی (Tech Stack) این بخش شامل موارد زیر است:
- حافظه ترکیبی گراف-بردار: استفاده از APIهای چرخه حیات حافظهی Cognee برای نقشهبرداری از موجودیتها و روابط.
- Neo4j Aura: تامین زیرساخت گراف رابطهای برای اطمینان از بازیابی محتوا با درک دقیق زمینه (Context-aware recall).
- موتور شناختی: تبدیل متن خام به یک گراف دانش (Knowledge Graph) ساختاریافته.

این رویکرد باعث میشود مکانیسم بازیابی اطلاعات از یک تطابق سادهی کلمات کلیدی به یک «پیمایش شناختی» تغییر کند. برای مثال، اگر کاربر ویدیویی درباره «مکملهای PCOS» ذخیره کند، AI تنها کلمه را به خاطر نمیسپارد؛ بلکه رابطهی خاص بین مواد تشکیلدهنده مانند روی (Zinc) و امگا-۳، دوز مصرفی مورد نیاز و نتایج سلامتی مورد انتظار را نقشهبرداری میکند. این سطح از دقت در بازیابی، گامی در جهت رفع مشکل فراموشی در مدلهای زبانی است، مشابه رویکردی که Lorekeeper با استفاده از چرخههای بازاندیشی برای کاهش فراموشی حافظه پیاده کرده است.
در نتیجه، وقتی کاربر روزها بعد سوالی بپرسد — مثلاً: «درباره آن ویدیوی راهنمای مکملهای PCOS به من بگو» — عامل هوش مصنوعی در گراف دانش Cognee پیمایش میکند. این سیستم میتواند بهسرعت ۵ مکمل خاص ذکر شده در یک کلیپ ۳۰ ثانیهای را که سهشنبه گذشته ذخیره شده بود، استخراج و بازگرداند.
برای کاربر عادی، این به معنای تغییر وضعیت از یک مصرفکننده غیرفعالِ الگوریتم به مالک یک پایگاه داده شخصی و قابل جستوجو است. این ابزار عملاً مشکل «گورستان دیجیتال» را حل میکند تا فرآیند بازیابی اطلاعات به اندازه فرآیند مصرف آنها بدون اصطکاک باشد.
گام بعدی شما
چه توسعهدهنده باشید و چه یک یادگیرندهی مادامالعمر، گام بعدی ارزیابی این موضوع است که چگونه حافظههای مبتنی بر گراف میتوانند جایگزین بوکمارکهای سنتی شوند. بررسی ادغام Cognee با سایر فیدهای اجتماعی میتواند دامنه حافظهی هوش مصنوعی حاکمیتی را بیشتر گسترش دهد.
- ارزیابی کنید که چگونه حافظههای مبتنی بر گراف میتوانند جایگزین سیستمهای بوکمارک سنتی شوند.
- بررسی کنید آیا امکان ادغام Cognee با سایر فیدهای اجتماعی برای ایجاد حافظه حاکمیتی وجود دارد یا خیر.
- مدلهای استخراج داده از رسانه را برای مدیریت دانش شخصی خود تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو