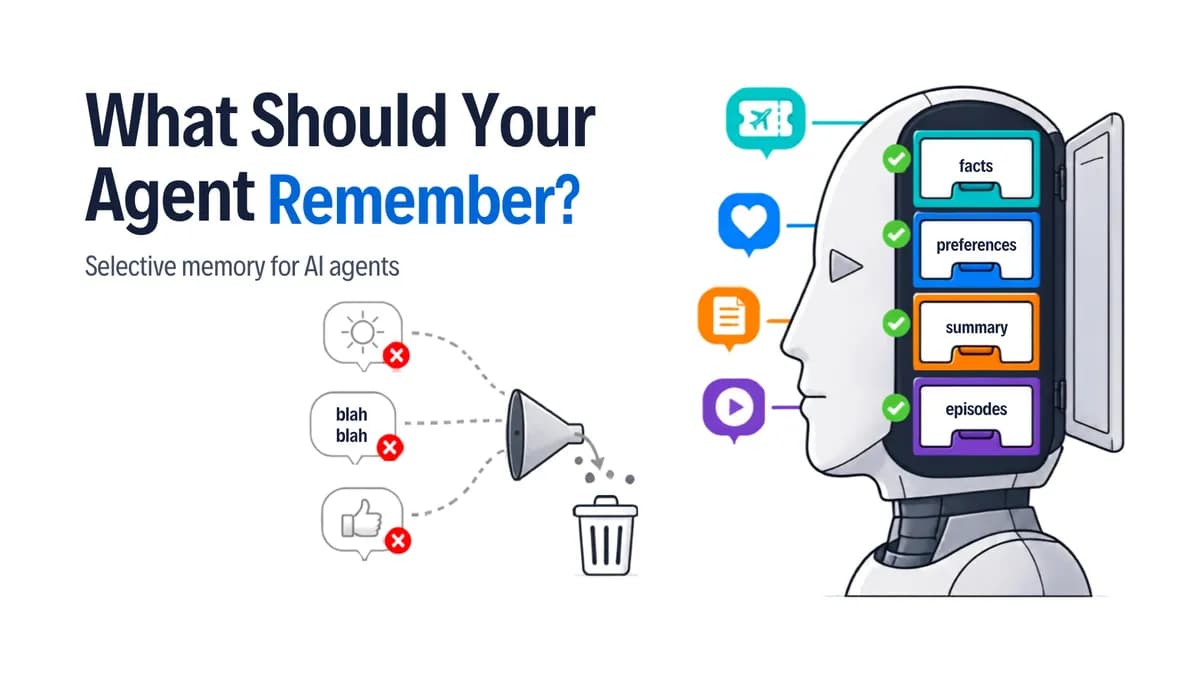
یک عامل هوش مصنوعی با کارایی بالا، نه کسی است که همه چیز را به یاد میآورد، بلکه کسی است که میداند چه چیزهایی را باید دور بریزد. در ۵ سپتامبر ۲۰۲۶، شرکت Strands Agents جزئیات یک چارچوب حافظه گزینشی را منتشر کرد که طراحی شده است تا از انباشت پنجرههای متنی (Context Windows) با گفتگوهای بیارزش و «گپوگفتهای روزمره» جلوگیری کند.
بر اساس مستندات فنی این شرکت، صنعت اکنون از رویکرد «بزرگتر کردن پنجره متنی» به سمت «استخراج هوشمندتر» حرکت میکند. همانطور که در تحلیل قبلی ما دربارهی بازیابی ترکیبی و رفع شکستهای حافظه از طریق همگرایی SQL اشاره کردیم، بسیاری از توسعهدهندگان در حال حاضر در رقابتی برای گسترش پنجرههای متنی یا ریختن هر تعاملی در یک ذخیرهساز برداری هستند. این رویکرد منجر به ایجاد «حافظه کثیف» میشود؛ حافظهای گرانقیمت، کند و پر از دادههای نامرتبط که کیفیت بازیابی را بهشدت کاهش میدهد.
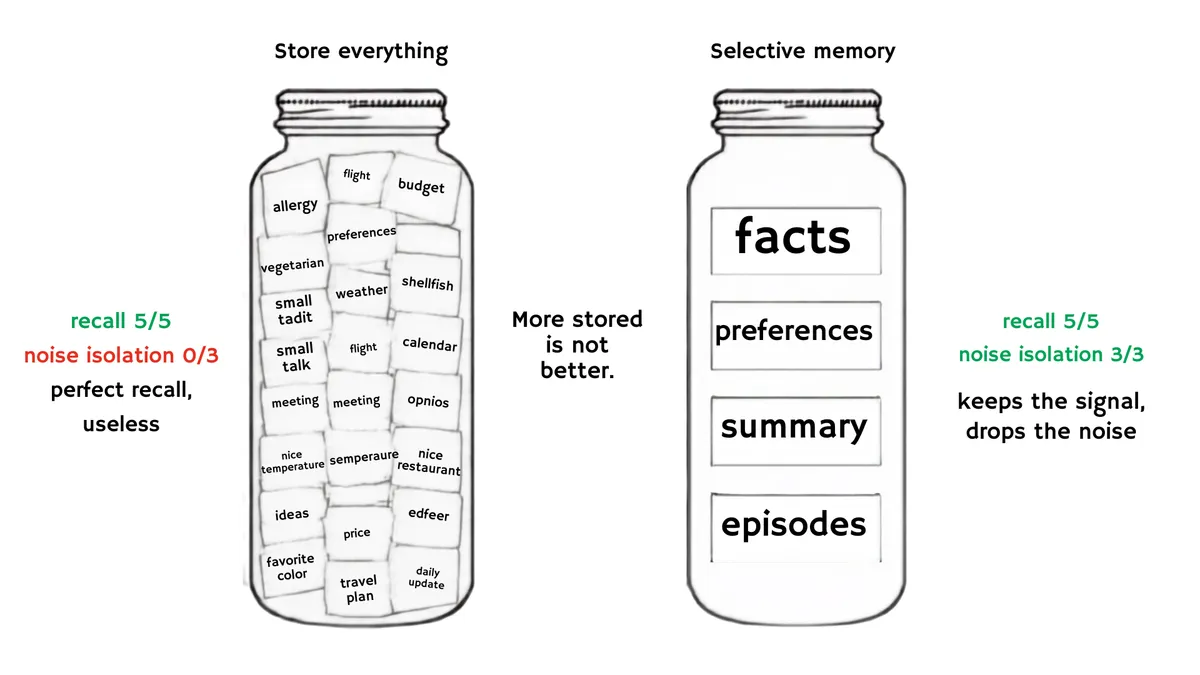
تصور کنید یک دستیار سفر را داشته باشید که حساسیت شما به غذاهای دریایی را برای سالها به یاد میآورد، اما بحثی که سه دقیقه پیش درباره وضعیت آبوهوا داشتید را فراموش میکند. هدف از استخراج حافظه — که یک گام تعیینکننده بین گفتگوهای خام و بکاند ذخیرهسازی است — فیلتر کردن مواردی است که ارزش نگه داشتن دارند. این تکامل در معماری عاملها، بخشی از روند گستردهتر تبدیل چتباتهای ساده به ابزارهای خودمختار برای اتوماسیون فرآیندهای پیچیده است که در ماههای اخیر شتاب گرفته است.
درک مکانیزم استخراج حافظه
استخراج حافظه، که به عنوان حافظه گزینشی نیز شناخته میشود، بهعنوان فیلتری بین گفتگو و مخزن حافظه عمل میکند. این یک لایه معماری مجزا است: لایه استخراج تصمیم میگیرد «چه چیزی» وارد حافظه شود، در حالی که بخش بکاند (Backend) تصمیم میگیرد این داده «کجا» قرار بگیرد.
برای استانداردسازی این فرآیند، این چارچوب از چهار نوع حافظه خاص استفاده میکند که بهطور یکبهیک با استراتژیهای داخلی ارائه شده در Amazon Bedrock AgentCore Memory مطابقت دارند:
- حقایق (Facts): واقعیتهای بادوام درباره دنیای کاربر (استفاده از
semanticMemoryStrategy). - ترجیحات (Preferences): علاقهمندیها و بیزاریهای کاربر که در طول گفتگو آشکار شدهاند (استفاده از
userPreferenceMemoryStrategy). - خلاصه سفر (Trip Summary): یک خلاصه جاری و پویا از وظیفه یا تسک فعلی (استفاده از
summaryMemoryStrategy). - رویدادها (Episodes): اتفاقات قابل توجه، بهطوری که برای هر رویداد یک ورودی ثبت شود (استفاده از
episodicMemoryStrategy).
سه مکانیزم مدیریت حافظه
به نقل از راهنمای فنی dev.to، سه روش اصلی برای پیادهسازی این منطق گزینشی با استفاده از SDK شرکت Strands و حافظه Amazon Bedrock AgentCore Memory وجود دارد:
- ذخیرهساز واحد بومی (Mechanism A): سادهترین ساختار که از یک پرامپت انتخاب کلی و یک مخزن حافظه استفاده میکند. این روش برای نیازهای پایه موثر است اما ثبات کمتری در بازیابی دارد (حدود ۳.۹ از ۵ مورد قابل حفظ). در این حالت، شما سیاست انتخاب را در سطح کلیتری مدیریت میکنید.
- ذخیرهسازهای تفکیکشده بومی (Mechanism B): رویکردی دقیق با استفاده از چهار مخزن تخصصی (حقایق، ترجیحات، خلاصهها و رویدادها). هر مخزن پرامپت اختصاصی خود را دارد که منجر به بازیابی تقریباً کامل (۵ از ۵ مورد قابل حفظ) میشود، زیرا تداخل بین انواع حافظه را حذف میکند. این تیزترین گزینه برای کسانی است که میخواهند بر هر معیار انتخاب تسلط کامل داشته باشند.
- حافظه مدیریتشده Bedrock (Mechanism C): یک سرویس کاملاً مدیریتشده از AWS که در آن Amazon Bedrock AgentCore Memory استخراج را بهصورت ناهمگام (Asynchronous) انجام میدهد. این روش به دقت ۵ از ۵ در بازیابی میرسد اما تأخیری بین ۲۰ تا ۵۵ ثانیه ایجاد میکند تا حافظهها قابل پرسوجو شوند. این گزینه برای محیطهای تولیدی چندکاربره که ترجیح میدهید AWS کل خط لوله را اجرا کند، ایدئال است. این افزایش یکپارچگی با سرویسهای ابری، همسو با رشد چشمگیر جستجوی عاملهای هوش مصنوعی در بازار نرمافزاری آمازون است که نشاندهنده تمایل توسعهدهندگان به زیرساختهای مدیریتشده است.
معماری فنی و زیرساخت
شرکت Strands این قابلیت را از طریق یک پلاگین بومی به نام MemoryManager پیاده کرده است. این مدیر سه وظیفه حیاتی را در سراسر ذخیرهسازهای ارائه شده بر عهده دارد:
- بازیابی (Recall): ابزار
search_memoryرا فراهم میکند تا عامل بتواند برای بازیابی اطلاعات آن را فراخوانی کند. - تزریق (Injection): حافظههای مرتبط را قبل از هر فراخوانی در پرامپت جای میدهد، بدون اینکه تاریخچه بادوام را تغییر دهد. اگر بازیابی شکست بخورد، سیستم بهسادگی از تزریق صرفنظر میکند تا چرخه گفتگو قطع نشود.
- استخراج (Extraction): از یک
ModelExtractorاستفاده میکند تا گفتگوها را خارج از نوبت (Off-turn) و بر اساس یک محرک خاص، به حافظه تبدیل کند.
توسعهدهندگان تنها دو اهرم کنترل دارند: پرامپت انتخاب (سیاست حفظ یا حذف) و نوع ذخیرهساز. ModelExtractor بهعنوان یک فراخوانی مدل جداگانه اجرا میشود — که اغلب از مدلی ارزانتر مانند gpt-4o-mini استفاده میکند — تا باعث حجیم شدن پرامپت اصلی گفتگو نشود.
خط لوله استخراج
برای مدیریت زمان و نحوه ذخیره حافظه، این چارچوب از چندین جزء پیکربندی استفاده میکند:
- ExtractionConfig: استخراجکننده و یک محرک را به یک ذخیرهساز متصل میکند. همچنین نویزهای مربوط به فراخوانی ابزارها (Tool-call noise) را حذف میکند تا کدهای JSON ابزارها بهطور تصادفی در حافظه دائمی ذخیره نشوند.
- IntervalTrigger / InvocationTrigger: اینها تعیین میکنند استخراج چه زمانی اجرا شود (مثلاً هر نوبت یا هر N نوبت). چون این فرآیند خارج از مسیر مستقیم گفتگو اتفاق میافتد، تجربه کاربر را مسدود نمیکند.
- پرامپت انتخاب (Selection Prompt): هسته اصلی منطق است. برای مثال، پرامپت یک دستیار سفر ممکن است به مدل دستور دهد که هویت، محدودیتهای غذایی و رزروهای تأییدشده را استخراج کند و صراحتاً گپوگفتهای روزمره و نظرات گذرا را دور بریزد. قرارداد خروجی بهطور سختگیرانه تعریف شده است: مدل باید فقط یک آرایه JSON از
{"content": string}یا در صورت نبود مورد قابل حفظ، یک آرایه خالی[]برگرداند.
انتخاب زیرساخت ذخیرهسازی
در لایه ذخیرهسازی، این چارچوب از یک قرارداد MemoryStore شامل متدهای add(content) و search(query) پشتیبانی میکند. در نسخه دموی این سیستم، این قرارداد بر روی یک شاخص برداری با استفاده از Amazon Titan Text Embeddings V2 پیاده شده است.
دو زیرساخت اصلی AWS از طریق یک متغیر محیطی (VECTOR_BACKEND) قابل انتخاب هستند:
۱. Amazon S3 Vectors: یک باکت برداری مجزا از دادههای عملیاتی. AWS این گزینه را برای ذخیرهسازی بهینه هزینه در مقیاس انبوه با دسترسی کم معرفی کرده است. تأخیر پرسوجو زیر یک ثانیه است (حدود ۱۰۰ میلیثانیه برای پرسوجوهای مکرر و تا یک ثانیه برای دادههای سرد). این گزینه را برای مجموعههای آرشیوی یا دغدغههای حافظه مستقل انتخاب کنید.
۲. Amazon DynamoDB Vector Search: شاخص برداری درون یک جدول DynamoDB قرار میگیرد، به این معنی که جاسازیها (Embeddings) در کنار دادههای عملیاتی قرار دارند. این گزینه تأخیر تکرقمی (میلیثانیه) با بازیابی بالای ۹۹٪ ارائه میدهد. این انتخاب ترجیحی برای بازیابی بلادرنگ یا زمانی است که عامل از قبل از DynamoDB میخواند. این ساختار با استفاده از APIهای CreateTable/UpdateTable با پارامتر VectorIndexes ایجاد و از طریق API SearchVectors پرسوجو میشود.
برای کسانی که نمیخواهند قراردادها را دستی پیاده کنند، دایرکتوری ادغامهای Strands بکاندهای آمادهای از جمله Amazon Bedrock Knowledge Base، Mem0، Zep، Vectorize و حافظه گرافی Neo4j را فراهم کرده است. سایر گزینههای بستهبندی شده شامل s3-vectors-memory و strands-dynamodb-storage هستند.
هزینه دقت و انضباط پرامپت
دقت سیستم از انضباط در پرامپتنویسی میآید. در رویکرد تفکیکشده (Mechanism B)، سیستم از چهار پرامپت مجزا استفاده میکند تا تضمین کند هیچ داده «کاذبی» (Decoy) به مخزن «حقایق» نفوذ نکند. انضباطِ پرامپتهای غیرمتداخل مانع از آن میشود که یک داده کاذب در لباس یک «خلاصه» تغییر شکل دهد.
نمونه سیاستهای تفکیکشده:
- حقایق: فقط حقایق بادوام (نام، فرودگاه مبدأ، حساسیتها) را استخراج کن. ترجیحات، نظرات، گپوگفتها، آبوهوا و رویدادهای یکباره را دور بریز.
- ترجیحات: فقط ترجیحات بیانشده سفر (کلاس پرواز، صندلی، قوانین توقف، بودجه) را استخراج کن. حقایقی مانند حساسیتها، رزروهای یکباره، نظرات، گپوگفتها و آبوهوا را دور بریز.
- خلاصه سفر: یک خلاصه تکجملهای از سفر تأییدشده فعلی (مسیر، خط هوایی، تاریخ پس از رزرو) را حفظ کن. گپوگفتها، آبوهوا، نظرات و هر چیزی که بخشی از سفر رزرو شده نباشد را دور بریز.
- رویدادها: فقط یک اقدام تکمیلشده و عینی (یک رزرو، یک لغو، یک تغییر تأیید شده) را ثبت کن. کامنتها، سوالات، نظرات، اظهارات درباره آبوهوا یا گپوگفتها را ثبت نکن.
یک نکته عملیاتی حیاتی، دستور flush() است. چون استخراج در پسزمینه رخ میدهد، ممکن است آخرین نوبت گفتگو قبل از پایان جلسه ذخیره نشود. فراخوانی await manager.flush() تمام پیامهای بافر شده را مجبور به ذخیره میکند تا اطمینان حاصل شود هیچ داده حیاتی در هنگام خاموشی سیستم از دست نمیرود.
جزئیات پیادهسازی Flush()
زمان فراخوانی flush() به نحوه هدایت عامل بستگی دارد:
- فراخوانیهای همگام
agent("..."): هر فراخوانی در حلقه رویداد (Event Loop) خود اجرا میشود، بنابراین چارچوب بعد از هر بار اجرا بهطور خودکار برای شما عملیات flush را انجام میدهد. حافظه تا زمان بازگشت فراخوانی، ذخیره شده است. - فراخوانیهای ناهمگام
invoke_async(...)یاstream_async(...): اینها از یک حلقه طولانیمدت مشترک استفاده میکنند و بهطور خودکار flush نمیشوند. توسعهدهندگان باید در مرز خاموشی سیستم،memory_manager.flush()را await کنند.
دو هشدار در مستندات وجود دارد: اول، flush() را در هر نوبت در کنار یک محرک دورهای صدا نزنید، زیرا این کار برنامه زمانی محرک را مختل میکند. دوم، یک توقف سخت (SIGKILL یا Timeout) همچنان میتواند آخرین نوبت ذخیرهنشده را حذف کند زیرا flush() هرگز اجرا نمیشود؛ استفاده از محرکهای مکررتر این پنجره ریسک را کاهش میدهد.
موازنه عملکرد (Trade-offs)
در تستهای رودررو با استفاده از گفتگویی شامل ۵ مورد «قابل حفظ» (۲ حقیقت، ۲ ترجیح، ۱ رویداد) و ۳ مورد «کاذب» (گپوگفت، نظر گذرا، آبوهوای زودگذر)، نتایج تفاوت آشکاری را بین تأخیر و کنترل نشان داد:
| مکانیزم | بازیابی انتخاب | جزئیات بازیابی | تأخیر هر نوبت | قابلیت پرسوجو |
|---|---|---|---|---|
| A: تکمخزن بومی | ~۳.۹/۵ | استخر ترکیبی | ~۳.۲ ثانیه | فوری |
| B: تفکیکشده بومی | ~۵/۵ | بر اساس نوع | ~۳.۵ ثانیه | فوری |
| C: مدیریتشده Bedrock | ۵/۵ | بر اساس استراتژی | ~۲.۲ ثانیه | تأخیر ۲۰-۵۵ ثانیه |
گزینههای SDK بومی (A و B) قابلیت پرسوجوی فوری دارند چون استخراج در چرخه نوبت انجام میشود، هرچند این موضوع به تأخیر پاسخدهی هر نوبت اضافه میکند. مسیر مدیریتشده AWS (گزینه C) با انتقال کار به یک خط لوله ناهمگام، تأخیر نوبت را کاهش میدهد و در عوض، در دسترس بودن فوری داده را فدا میکند.
نکات عملی برای حافظه مدیریتشده
هنگام استفاده از AgentCoreMemorySessionManager برای مسیر مدیریتشده، توسعهدهندگان باید به این جزئیات پیادهسازی توجه کنند:
- نامگذاری (Namespacing): برای هر استراتژی در هنگام ایجاد، یک فضای نام صریح تعریف کنید (مثلاً
/facts/{actorId}/یا/preferences/{actorId}/یا/summaries/{actorId}/{sessionId}/یا/episodes/{actorId}/{sessionId}/). همان فضای نامی که روی استراتژی تنظیم شده، باید درRetrievalConfigمورد ارجاع قرار گیرد. - امتیاز مرتبط بودن (Relevance Scoring): از
RetrievalConfig(relevance_score=...)استفاده کنید تا کنترل کنید چه مواردی در هنگام بازیابی بازگردانده شوند. این کار باعث میشود فقط رکوردهای بالای یک آستانه مرتبط بودن در هر فضای نام حفظ شوند. - سازگاری نهایی (Eventual Consistency): چون استخراج ناهمگام است، حقیقتی که در این نوبت نوشته شده، ممکن است در نوبت بعد قابل بازیابی نباشد. حافظههایی که در وضعیت
CREATINGهستند آماده نیستند؛ منتظر بمانید تا وضعیت آنها بهACTIVEتغییر کند و سپس رویدادها را ارسال کنید. - سفارشیسازی: با وجود مدیریتشده بودن، شما همچنان میتوانید از استراتژیهای سفارشی با بازنویسی پرامپتها (Prompt Overrides) برای شکل دادن به منطق استخراج و تجمیع استفاده کنید. این به شما اجازه میدهد منطق پیشفرض یک استراتژی داخلی را با پرامپت و مدل خودتان جایگزین کنید.
این تغییر در مدیریت حافظه، این فرض بنیادی را که «داده بیشتر برابر است با عامل بهتر» به چالش میکشد. این موضوع ثابت میکند که گلوگاه در جریانهای کاری عاملمحور، ظرفیت ذخیرهسازی نیست، بلکه هوشمندیِ فیلتر است. با تبدیل حافظه به یک دارایی گزینششده بهجای یک گزارش خام، توسعهدهندگان میتوانند عاملهایی بسازند که بدون تحمیل هزینه محاسباتی اضافی، واقعاً شخصیسازی شده به نظر برسند.
برای پیادهسازی این سیستم، توسعهدهندگان میتوانند دایرکتوری ادغامهای Strands را برای یافتن بکاندهای آماده بررسی کنند. چالش بعدی این حوزه، دفاع از این مسیر نوشتن در برابر تزریق پرامپت (Prompt Injection) و مسمومسازی حافظه (Memory Poisoning) است.



گفتگو