
تصور کنید یک عامل مسافرتی در محیط دمو تمام پروازها را بینقص رزرو میکند، اما به محض اینکه یک API در محیط واقعی دچار تأخیر میشود، با اطمینان کامل به کاربر دروغ میگوید. این شکست رایج به این دلیل رخ میدهد که عاملها معمولاً در «مسیرهای خوشبینانه» آزمایش میشوند، نه در واقعیت آشفتهی سیستمهای توزیعشده.
بر اساس مستندات Strands Evals، توسعهدهندگان میتوانند با آوردن مفاهیم مهندسی آشوب به لایهی عاملمحور، این مشکل را حل کنند. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، اعتماد کورکورانه به خروجی مدل بدون داشتن یک لایهٔ حفاظتی، ریسک عملیاتی را افزایش میدهد. در این راستا، استفاده از سازوکارهای قطعی برای کنترل خروجیها ضروری است، مشابه آنچه در راهکار Aegis-Layer برای توقف نشت دادهها مشاهده کردیم که با ایجاد یک سد ریاضی، امنیت عاملها را تضمین میکند. در دنیای نرمافزار، نتفلیکس از ابزاری به نام Chaos Monkey استفاده میکند تا سرورها را عمداً در ساعات کاری خاموش کند؛ این کار برای این است که اگر یک خرابی تصادفی کل سرویس را میگیرد، توسعهدهندگان این موضوع را در یک روز سهشنبهی آرام بفهمند، نه ساعت ۳ صبح در یک قطعی واقعی.
عاملهای هوش مصنوعی تقریباً هرگز چنین تمرینی را نمیبینند. آنها یک دموی موفق میگیرند، تأیید میشوند و مستقر میگردند. سپس یک ابزار دچار Timeout میشود یا یک API دادههای نامعتبر برمیگرداند. عامل (Agent) — که شبیه دستیاری است که دستورات شما را میگیرد و برای اجرای آنها از ابزارهای مختلف استفاده میکند — چون هرگز با ابزار خراب مواجه نشده، به کاربر میگوید کار با موفقیت انجام شد، در حالی که هیچ اتفاقی نیفتاده است. این وضعیت شکافی خطرناک بین عملکرد ظاهری و قابلیت اطمینان واقعی ایجاد میکند.
مکانیسمهای تست آشوب
تست آشوب برای عاملها شامل تزریق خطاهای کنترلشده (تأخیرها، خطاهای شبکه، پاسخهای مخدوش) در فراخوانی ابزارها حین ارزیابی است. هدف در اینجا مقاومسازی «هارنس» (Harness) یا همان معماری قطعی اطراف مدل است، نه تلاش برای حل مشکل از طریق مهندسی پرامپت (Prompt Engineering) — که هنر سؤال درست پرسیدن است، شبیه کسی که میداند چطور از یک مشاور باتجربه بهترین جواب را بگیرد.
این یک چرخش فلسفی است: ما هارنس را مقاوم میکنیم، نه اینکه مدل را نمره دهیم. شکستها و اصلاحات، بخشهای قطعی معماری هستند (مانند قلابها یا ابزارهای جایگزین) و فارغ از اینکه چه مدلی در داخل اجرا میشود، یکسان عمل میکنند. این رویکرد ساختاری به مدیریت توهمات شباهت دارد؛ برای مثال چارچوب Agent Rigor با استفاده از سلسلهمراتب دستوری توانسته است از سقوط عاملهای کدنویس در چرخههای بینهایت توهم جلوگیری کند. چون واکنش مدل به یک ابزار خراب در هر بار اجرا متفاوت است، تابآوری باید در معماری قطعی اطراف مدل باشد، نه در امید به اینکه مدل بتواند با مشکل کنار بیاید.
در یک دموی عملی، یک عامل مسافرتی با استفاده از Strands Agents و سه ابزار خاص ساخته شده است:
search_flights: جستوجوی قیمتها از محیط شبیهساز Duffel.get_weather: خواندن پیشبینی هوا از یک API عمومی.book_flight: ثبت رزرو در یک دفتر کل SQLite که به عنوان «داده مرجع» برای تأیید استفاده میشود.
به نقل از گزارش dev.to، چارچوب Strands Agents به توسعهدهندگان اجازه میدهد تا با استفاده از ChaosPlugin و تنها یک خط کد، شکستها را شبیهسازی کنند. این پلاگین از قلابهای بومی فراخوانی ابزار در Strands استفاده میکند و نیازی به ساخت Mock یا تغییر دستی ابزارها ندارد.
جزئیات پیادهسازی
برای راهاندازی محیط، اجزای کلیدی از strands و strands_evals وارد میشوند. توسعهدهندگان effect_maps را تعریف میکنند تا هر شکست را بر اساس اثر و ابزار هدف نامگذاری کنند. برای مثال، یک تأخیر در رزرو به صورت book_timeout تعریف میشود. این موارد سپس به اشیاء ChaosCase تبدیل شده و عامل با ChaosPlugin مقداردهی اولیه میشود تا ارزیابیها از طریق یک TracedHandler اجرا گردند.
Strands Evals دو خانواده متمایز از شکستها را شناسایی میکند:
اثرات خانوادهای
- شکستهای پیش-قلاب (لغو فراخوانی): شامل
TimeoutوNetworkErrorاست. در اینجا ابزار قبل از اجرا لغو میشود. نتیجه این است که هیچ دادهای ذخیره نمیشود و خطا «بلند» و شناسایی آن آسان است. - شکستهای پس-قلاب (مخدوش کردن نتیجه): شامل
CorruptValuesوRemoveFieldsاست. در اینجا ابزار با موفقیت اجرا میشود (داده ذخیره میگردد)، اما پاسخی که به عامل برمیگردد زباله است. اینها «خطاهای خاموش» و خطرناکی هستند چون عامل ممکن است به تأییدیه خراب اعتماد کند و آن را به عنوان موفقیت به کاربر گزارش دهد.
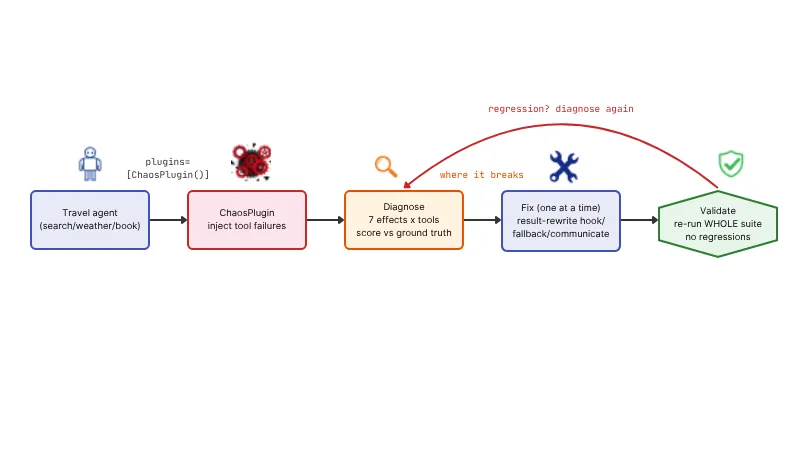
چرخه تشخیص-اصلاح-تأیید
توسعهدهندگان از یک چرخه سهمرحلهای برای حرکت از تشخیص به سمت بهبود ساختاری استفاده میکنند.
۱. تشخیص (Diagnose):
عامل ساده در معرض هر هفت اثر شکست قرار میگیرد. نتایج با استفاده از دو ارزیاب با داده مرجع (پایگاه داده) سنجیده میشوند:
- بررسی وضعیت: «آیا رزرو واقعاً ذخیره شد؟»
- بررسی صداقت: «آیا عامل رفرنسی را اعلام کرد که واقعاً وجود دارد؟»
این ساختار دوگانه تله شکستهای پس-قلاب را میگیرد؛ زیرا ممکن است داده در SQLite ذخیره شده باشد (پاس در بررسی وضعیت)، اما عامل رفرنسی غلط داده باشد (شکست در بررسی صداقت).
۲. اصلاح (Fix):
اصلاحات دقیقاً با شکل شکست تطبیق داده میشوند، زیرا تکرار ساده (Retry) اغلب شکست میخورد.
- برای فساد خاموش: یک قلاب
AfterToolCallEventپیاده میشود که نتیجه را دوباره با پایگاه داده چک کرده و با حقیقت بازنویسی میکند. - برای قطعی ارائهدهنده: یک قلاب
BeforeToolCallEventایجاد میشود تا در صورت خرابی، به یک ارائهدهنده کاملاً متفاوت (مثلاً API هواشناسی دوم) سوییچ کند. - برای شکستهای غیرقابل بازگشت: از آگاهی از شکست در پرامپت استفاده میشود تا عامل صادقانه بگوید «نتوانستم انجام دهم» به جای جعل موفقیت.
۳. تأیید (Validate):
در نهایت، کل مجموعه آشوب دوباره اجرا میشود. این مرحله حیاتی است چون پسرفتها را میگیرد. مثلاً ممکن است پرامپتی که برای خطای هواشناسی نوشته شده، به اشتباه باعث شود عامل کلاً رزرو پرواز را متوقف کند.
تابآوری ساختاری در برابر مدل
این رویکرد تمرکز را از قابلیتهای مدل به یکپارچگی معماری منتقل میکند. چون واکنش مدل به ابزار خراب تصادفی است، تابآوری باید در هارنس قطعی باشد. هر شکستی لزوماً نباید «پاس» شود؛ اگر رزرو لغو شده و جایگزینی نیست، قرمز ماندن تست یک نمایش صادقانه از شکاف ساختاری است، نه شکست مدل. اصلاح این مورد ساختاری است (افزودن ارائهدهنده پشتیبان) نه امید به اینکه مدل با آن کنار بیاید.
این چارچوب مستقل از مدل است. اگرچه در دمو از OpenAI gpt-4o-mini استفاده شده، اما همین کد روی Amazon Bedrock، Anthropic یا مدلهای محلی از طریق Ollama اجرا میشود.
گسترش الگو به سایر شکستها
این رویکرد با الگوی PALADIN (سپتامبر ۲۰۲۵) همسو است که عاملها را برای بازیابی از شکستهای تزریقی آموزش میدهد. این متدولوژی در موارد دیگر نیز کاربرد دارد:
- توهمات حافظه: استفاده از گیت write-gate برای تأیید حقیقت پیش از ذخیره در حافظه.
- تزریق پرامپت: مسدود کردن قطعی اقدامات خطرناک ناشی از محتوای غیرقابل اعتماد.
- کارهای چندمرحلهای: اجرای منطق «تأیید با داده مرجع» در هر مرحله برای جلوگیری از فساد خاموش.
- عاملهای خود-بهبودبخش: تبدیل کارهای تکراری قطعی به ابزاری که یک بار نوشته شده و دقیقاً تکرار میشود.
گام بعدی شما
- برای شروع، مخزن گیتهاب
resilient-agent-harness-sample-for-awsرا کلون کنید. - محیط مجازی را با
uv venvبسازید و نیازمندیها را نصب کنید. - با داشتن کلیدهای API مربوط به OpenAI و Duffel، نوتبوک
agent_resilience_journey.ipynbرا اجرا کنید تا چرخه تشخیص و اصلاح را تجربه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو