تصور کنید مسئول سیستمی هستید که سالهاست قلب تپنده شرکت شماست، اما حالا برای اضافه کردن یک قابلیت ساده، باید هزاران خط کد مستندنشده را بازنویسی کنید. این کابوسِ هر مدیر فنی است که میخواهد سیستمهای قدیمی را به دنیای هوش مصنوعی متصل کند. ریسک بازنویسی کامل سیستم بسیار بالاست؛ زیرا این مسیر اغلب شکست میخورد، چرا که سالها قوانین کسبوکار مستندنشده و روابط پیچیده دادهها در طول این انتقال از بین میروند. در همین راستا، برخی سازمانها برای کاهش این ریسک از راهکارهای تبدیل خودکار کدهای میراثی به معماریهای مدرن استفاده میکنند تا پیوستگی منطق کسبوکار حفظ شود.
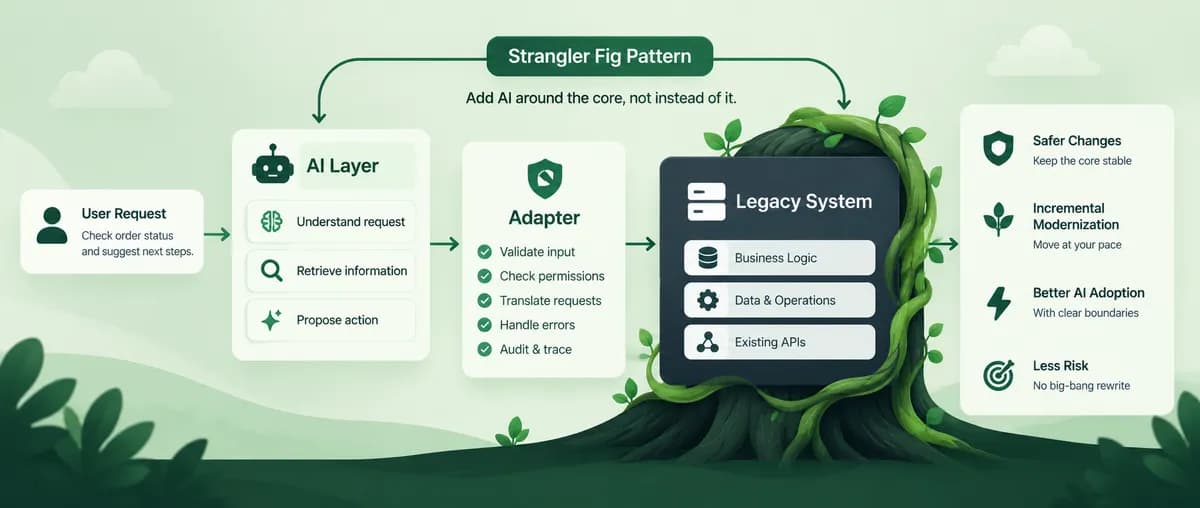
طبق راهنمای فنی منتشر شده در dev.to در ۱۷ اکتبر ۲۰۲۶، استفاده از الگوی Strangler Fig (انجیر خفهکننده) به سازمانها اجازه میدهد بدون ریسک فروپاشی عملیات حیاتی، قابلیتهای هوش مصنوعی را در اطراف هسته قدیمی سیستم پیاده کنند. این استراتژی به جای جایگزینی یکباره، بر مدرنسازی تدریجی تمرکز دارد.
بسیاری از سیستمهای قدیمی صلب هستند و تنها از طریق رابطهای قدیمی یا Batch Interface با دنیای بیرون ارتباط دارند که ادغام هوش مصنوعی مدرن را تقریباً غیرممکن میکند. همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، اتصال مستقیم مدلها به زیرساختهای حساس میتواند فاجعهبار باشد. الگوی Strangler Fig که نخستین بار توسط مارتین فاولر (Martin Fowler) معرفی شد، پیشنهاد میکند به جای تخریب هسته، «درزهایی» ایجاد کنیم تا رفتار سیستم را ذرهذره منتقل کنیم. این رویکرد نیاز به یک رویداد جایگزینی واحد و پرریسک را کاهش میدهد، هرچند که به طور موقت پیچیدگی معماری را افزایش میدهد.
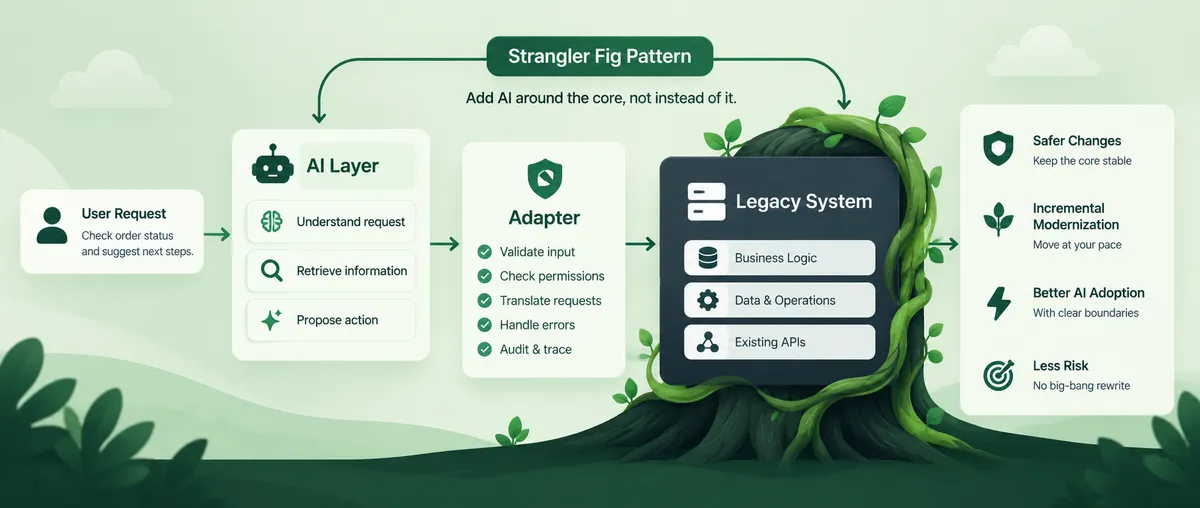
برای درک بهتر، یک سیستم مدیریت سفارشات را تصور کنید که قیمتگذاری و موجودی را عالی انجام میدهد اما کارمند باید ساعتها برای یافتن یک داده جستوجو کند. شما نیازی به تعویض کل سیستم ندارید؛ کافی است یک جریان کاری خاص — مثل طبقهبندی درخواستها — را ایزوله کنید و یک مسیر جدید مبتنی بر هوش مصنوعی زاینده (Generative AI) — شبیه به دستیاری که ابتدا درخواست را میخواند و سپس راهنمایی میکند — در اطراف آن بسازید. در این سناریو، اپلیکیشن قدیمی همچنان مرجع نهایی هویت مشتری، وضعیت سفارش و قوانین کسبوکار است و هوش مصنوعی فقط درخواستها را تفسیر کرده و اقداماتی را پیشنهاد میدهد. این رویکرد شباهت زیادی به استفاده از عوامل هوش مصنوعی برای گسترش نرمافزارهای Legacy دارد که اجازه میدهد بدون تغییر در کد اصلی، قابلیتهای جدیدی اضافه شود.
معماری مرزهای هوش مصنوعی
اتصال مستقیم یک مدل به جداول پایگاهداده، یک اشتباه استراتژیک است. این کار باعث میشود تصمیمات مدل به جزئیات داخلی وابسته شود که هرگز برای دسترسی عمومی طراحی نشدهاند. به همین دلیل، این راهنما استفاده از یک آداپتور (Adapter) — مثل یک مترجم که زبان پیچیده سیستم قدیمی را به زبان ساده هوش مصنوعی تبدیل میکند — را توصیه میکند.
یک آداپتور به عنوان مرزی کنترلشده عمل میکند که درخواستهای هوش مصنوعی را به عملیاتهای پشتیبانیشده در سیستم قدیمی ترجمه میکند. برای مثال، به جای دسترسی مستقیم به SQL، آداپتور تابعی مثل get_order_status(order_id) را ارائه میدهد. این عملیات به جای دسترسی نامحدود به دیتابیس، یک پاسخ تعریفشده شامل شناسه سفارش، وضعیت فعلی و برچسبهای زمانی مرتبط را برمیگرداند.
در عملیاتهای تغییر وضعیت (State-changing)، این مرز باید حتی سختگیرانهتر باشد. آداپتور نباید دستورات دلخواه را بپذیرد، بلکه باید دستورات اعتبارسنجیشده با فیلدهای صریح، فراخواننده احراز هویت شده و مجموعهای تعریفشده از عملیاتهای مجاز را بپذیرد. این امر تضمین میکند که هوش مصنوعی نتواند کنترلهای امنیتی مستقر در اپلیکیشن را دور بزند.
مسئولیتهای کلیدی این آداپتور عبارتند از:
- اعتبارسنجی ورودی: رد کردن شناسههای مفقود، مقادیر نامعتبر یا فیلدهای غیرمنتظره پیش از رسیدن آنها به هسته سیستم.
- احراز هویت و مجوز: اعمال دسترسیها بر اساس مجوزهای کاربر واقعی، نه بر اساس سطح دسترسیای که مدل هوش مصنوعی «حدس زده» یا از خروجی مدل استنباط کرده است.
- ترجمه قراردادها: تبدیل ساختارهای جدید درخواست و پاسخ هوش مصنوعی به رابطهای مستقر در سیستم قدیمی.
- مدیریت خطا: بازگرداندن وضعیتهای شکست صریح برای جلوگیری از توهم (Hallucination) — یعنی جلوگیری از اینکه مدل برای یک خطای Timeout، راهکاری خیالی بسازد یا حدس بزند چه اتفاقی افتاده است.
- بستر حسابرسی: حفظ شناسههای همبستگی (Correlation IDs) و هویت بازیگری که مسئول اقدام است تا یک ردپای حسابرسی شفاف حفظ شود.
جداسازی پیشنهاد از اجرا
خروجی ساختاریافته از یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — به معنای درست یا مجاز بودن آن اقدام نیست. مدل ممکن است یک JSON بینقص برای تغییر آدرس ارسال تولید کند، اما ممکن است سفارش اشتباهی را هدف قرار داده باشد یا به یک حساب غیرمجاز دسترسی پیدا کند. ساختار معتبر ثابت نمیکند که اقدام مورد نظر درست است.
برای جلوگیری از این اتفاق، مسیر اجرا باید به مراحل اعتبارسنجی مجزا تقسیم شود. مؤلفه هوش مصنوعی فقط باید اقدام را «پیشنهاد» کند و اپلیکیشن قدیمی باید آن را «اعتبارسنجی» و «اجرا» نماید. این کار مانع از آن میشود که مدل به یک پیادهسازی دوم و غیررسمی از منطق هسته کسبوکار تبدیل شود.
یک جریان اجرای امن به این ترتیب است:
۱. اعتبارسنجی ساختار خروجی و فیلدهای ضروری.
۲. شناسایی موجودیت مورد نظر از طریق اپلیکیشن فعلی.
۳. تأیید مجوز فراخواننده برای آن عملیات خاص.
۴. بررسی ناورداهای کسبوکار (مثلاً: آیا سفارش هنوز واجد شرایط تغییر است؟).
۵. اعمال قوانین تأیید مبتنی بر ریسک، که احتمالاً منجر به دخالت انسان میشود.
۶. اجرای دستور از طریق رابط قدیمی و مستقر سیستم.
۷. ثبت نتیجه و بازگرداندن وضعیت تأییدشده.
این منطق را میتوان از طریق یک مرز اجرای مفهومی تجسم کرد: سیستم یک درخواست کاربر را دریافت میکند، هوش مصنوعی اقدامی را پیشنهاد میدهد و سپس سیستم مجموعهای از بررسیها شامل schema_is_valid ،caller_is_authorized و business_rules_allow را اجرا میکند و در نهایت تابع legacy_adapter.execute را فرا میخواند. هر یک از این مراحل باید بر اساس مدل هویت واقعی و معناشناسی تراکنشی اپلیکیشن پیادهسازی شوند.
استراتژی استقرار در چهار مرحله
ترافیک باید به تدریج و از طریق یک لایه مسیریابی به مسیر جدید هوش مصنوعی منتقل شود تا پایداری سیستم به خطر نیفتد. تصمیم مسیریابی باید صریح و قابل مشاهده باشد.
مرحله اول با دستیار خواندنی (Read-only assistance) آغاز میشود. هوش مصنوعی درخواستها را طبقهبندی، رکوردها را خلاصه یا اطلاعات را از طریق رابطهای تأییدشده بازیابی میکند، اما عملیاتهای تغییر وضعیت غیرفعال میمانند.
مرحله دوم ارزیابی سایه (Shadow Evaluation) است. هوش مصنوعی در کنار جریان فعلی اجرا میشود اما تغییری ایجاد نمیکند. خروجیهای پیشنهادی آن با فرآیندهای مستقر با استفاده از موارد نماینده و معیارهای پذیرش تعریفشده مقایسه میشود.
مرحله سوم اجرای محدود (Limited execution) است. یک اقدام کمریسک و قابلبازگشت برای گروه کوچکی از درخواستها، تحت مجوزهای سختگیرانه، دسترسیهای محدود و یک سیاست تأیید تعریفشده فعال میشود.
مرحله چهارم گسترش بر اساس قابلیت (Expanding by capability) است. جریانهای کاری جدید تنها پس از اثبات پایداری مرزهای قبلی، از جمله مدیریت شکست و دید عملیاتی آنها، اضافه میشوند. در حالی که Feature Flagها میتوانند میزان مواجهه را کنترل کنند، اما آنها مکانیزم احراز مجوز نیستند؛ آداپتور باید صرفنظر از نحوه رسیدن ترافیک، مجوزها را اعمال کند.
مدیریت شکست و جریان دادهها
سرویسهای هوش مصنوعی ممکن است دچار تأخیر شوند، در دسترس نباشند یا نتایج غیرقابل استفاده برگردانند. بنابراین، یک مسیر جایگزین (Fallback) آگاهانه ضروری است. برای کارهای خواندنی، سیستم باید پاسخ استاندارد قدیمی را بدون خلاصه هوش مصنوعی برگرداند.
در عملیاتهای تغییر وضعیت، جایگزین باید کنترل را به یک فرآیند دستی بازگرداند، نه اینکه سعی کند به طور خودکار اقدام جایگزینی انجام دهد. تلاش مجدد (Retry) در اینجا بسیار خطرناک است؛ اگر یک درخواست نوشتن به سیستم قدیمی برسد اما پاسخ آن گم شود، تکرار درخواست میتواند منجر به اثرات جانبی تکراری (Duplicate side effects) شود.
برای کاهش این ریسک، توصیه میشود:
- استفاده از یک شناسه عملیاتی پایدار که در برابر تلاشهای مجدد تغییر نکند.
- پیادهسازی مکانیزمهای Idempotency که توسط اپلیکیشن گیرنده پشتیبانی شود.
- حفظ تفکیک صریح بین نتایج «رد شده»، «شکست خورده» و «نامشخص» در اجرا.
- تطبیق دادهها با سیستم مرجع زمانی که نتیجه عملیات نامشخص است.
- ارائه یک مسیر ارجاع دستی کنترلشده برای عملیاتی که به صورت خودکار حل نمیشوند.
مرزهای داده نیز باید صریح باقی بمانند. آداپتور فقط باید فیلدهایی را برگرداند که برای آن جریان کاری خاص ضروری هستند. دادههای حساس هرگز نباید صرفاً به دلیل وجود در رکورد دیتابیس زیرین، در معرض مدل هوش مصنوعی قرار گیرند.
قابلیت مشاهده (Observability) باید اطلاعات کافی برای بازسازی یک شکست را ثبت کند بدون اینکه دادههای حساس را ذخیره نماید. فیلدهای کلیدی برای ردیابی عبارتند از: شناسه همبستگی، نام جریان کاری، نتیجه سیاست، تأخیر آداپتور، وضعیت اجرا و دلیل ارجاع دستی. این امر به تیمها اجازه میدهد شکست هوش مصنوعی را از رد مجوز یا Timeout سیستم قدیمی تشخیص دهند.
زمان توقف
الگوی Strangler Fig بهانهای برای نگه داشتن ابدی کدهای قدیمی نیست. این الگو زمانی ناکارآمد میشود که ادغام نیازمند تکرار بیش از حد قوانین کسبوکار، همگامسازی مداوم وضعیتهای متضاد یا دور زدن رفتارهایی باشد که نمیتوان آنها را به طور قابل اعتمادی ایزوله کرد.
در آن نقطه، مرزها نشان میدهند که قابلیت دامنه (Domain capability) باید کاملاً استخراج شود، قراردادها بازطراحی شوند یا هسته سیستم جایگزین گردد. هدف این است که از این مرزها برای کشف محدودیتهای واقعی سیستم استفاده کنیم، نه اینکه در یک بازنویسی عظیم، بر اساس حدس و گمان پیش برویم.
هر آداپتور و قانون مسیریابی، پیچیدگی معماری را افزایش میدهد. تیمها باید مالکیت این مؤلفههای انتقالی را تعریف کنند و به طور دورهای ارزیابی کنند که آیا این مرز هنوز هدفی را دنبال میکند یا خود به یک بدهی فنی (Technical Debt) تبدیل شده است. اولین تغییر باید به اندازه کافی کوچک باشد تا قابل بازگشت باشد و تضمین کند که سازمان کنترل وضعیت کسبوکار و مالکیت عملیاتی را حفظ میکند، در حالی که قابلیت جدید به طور مستقل تکامل مییابد.
گام بعدی شما
- شناسایی یک جریان کاری کمریسک (مانند طبقهبندی تیکتها) برای پیادهسازی اولین آداپتور.
- طراحی لایه اعتبارسنجی که خروجی مدل را به دستورات صریح سیستم قدیمی تبدیل کند.
- تعریف معیارهای پذیرش برای مرحله «ارزیابی سایه» پیش از فعال کردن هرگونه تغییر در دادهها.
اما مدیریت هزینههای استنتاج در این معماری لایهای چالش دیگری است — به تحلیل ما درباره بهینهسازی هزینه GPU در مقیاس سازمانی مراجعه کنید.



گفتگو