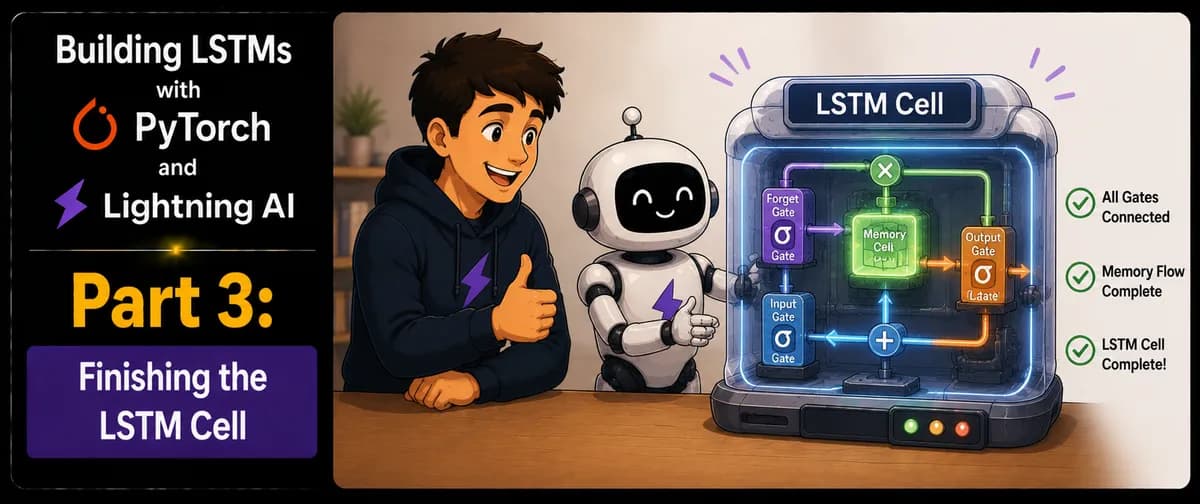
تصور کنید بخواهید دقیقاً کنترل کنید مدل شما چه بخشی از اطلاعات را فراموش کند و چه بخشی را در طول یک توالی حفظ کند؛ این همان برتری اصلی ساخت یک سلول LSTM از نقطه صفر است. طبق مستندات منتشر شده در ۲۴ ژوئن ۲۰۲۶، این پیادهسازی با استفاده از PyTorch و Lightning AI انجام شده تا برنامهنویس بتواند از لایههای آماده فاصله بگیرد و منطق ریاضی واحدهای بازگشتی را مستقیماً پیاده کند.
برای درک بهتر این معماری، یک شبکه عصبی (Neural Network) — که شبیه نقشهای از مترو است و سیگنالها را از ورودی به جواب میرساند — را در نظر بگیرید. در حالی که شبکههای عصبی استاندارد فقط لحظه حال را میبینند، LSTM مثل یک دفترچه یادداشت عمل میکند. این مدل تصمیم میگیرد کدام داده — مثلاً ریزش ناگهانی قیمت یک سهم — آنقدر حیاتی است که برای محاسبات فردا حفظ شود. این مدیریت دقیق حافظه در مدلهای کوچکتر، تضاد جالبی با چالشهای مقیاسپذیری در مدلهای عظیم دارد؛ جایی که محدودیتهای حافظه GPU اغلب به عنوان سد اصلی در مسیر تنظیم دقیق مدلهای زبانی بزرگ شناخته میشود.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی مدلهای سری زمانی اشاره کردیم، مدیریت حافظه کلید موفقیت در پیشبینی است. بر اساس آموزشهای وبسایت dev.to، تکمیل تابع lstm_unit() بر روی بهروزرسانی حافظه کوتاهمدت متمرکز است و این فرآیند طی مراحل زیر رخ میدهد:
- محاسبه درصد خروجی: مدل از یک تابع سیگموئید برای ترکیب حافظه کوتاهمدت، مقادیر ورودی و یک عبارت بایاس (
bo1) استفاده میکند تا تعیین کند چه مقدار از داده به خروجی برسد. - مقیاسبندی حالت: حافظه بلندمدتِ بهروزرسانیشده از یک فعالساز
tanhعبور کرده و در درصد خروجی ضرب میشود تاupdated_short_memoryایجاد شود. - بازگشت حالت: تابع در نهایت جفتی شامل
[updated_long_memory, updated_short_memory]را بازمیگرداند.
برای عملیاتی کردن مدل، متدی به نام forward() پیاده شده است. در این مورد خاص، مدل توالی قیمتهای سهام چهار روز گذشته را پردازش میکند. منطق برنامه ابتدا هر دو حافظه بلندمدت و کوتاهمدت را روی صفر تنظیم کرده و سپس دادهها را چهار مرتبه متوالی از lstm_unit عبور میدهد.
خروجی هر روز به ورودی روز بعد تبدیل میشود که در واقع باعث «باز کردن» (unrolling) شبکه میگردد. در نهایت، فقط مقدار آخرین حافظه کوتاهمدت به عنوان خروجی مدل بازگردانده میشود. برای بهینهسازی این وزنها، از بهینهساز Adam از طریق متد configure_optimizers() استفاده شده تا Lightning AI پارامترهای آموزش را با بیشترین بازدهی مدیریت کند. در معماریهای پیشرفتهتر، تلاشهای گستردهای برای کاهش اثرات جانبی این حافظهها صورت گرفته است، مانند آنچه در کاهش چشمگیر فشار حافظه KV در معماری FM-DS-V4 مشاهده شد.
طراحی LSTM در این سطح، نقش توسعهدهنده را از کاربرِ API به معمار حافظه تغییر میدهد. با تعریف دستی گیتها، شما میتوانید دقیقاً تشخیص دهید چرا مدل در پیشبینیهای سریزمانی، دادههای تاریخی حیاتی را فراموش میکند؛ مشکلی که در پیادهسازیهای «جعبه سیاه» غیرقابل شناسایی است.
گام بعدی شما
- متد
training_step()را پیادهسازی کنید تا مقدار زیان در مسیر پسانتشار محاسبه شود. - اثر تغییر تابع فعالساز
tanhبر روی پایداری حافظه بلندمدت را تست کنید. - این مدل را با دادههای واقعی بازار بورس ایران برای سنجش دقت پیشبینی آزمایش کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک نحوه استقرار این مدلها روی سختافزارهای لبه، به تحلیل ما دربارهی تراشههای NPU مراجعه کنید.



گفتگو