تصور کنید میخواهید یک مدل هوش مصنوعی بسازید، اما اجازه ندارید از هیچ ابزار آمادهای استفاده کنید. آیا میتوان یک خط لوله کامل آموزش — شامل گذرهای پیشرو و پسانتشار — را تنها با کتابخانه استاندارد پایتون پیاده کرد؟
به نقل از یک تحلیل فنی مفصل در وبسایت dev.to که در ۱۱ اکتبر ۲۰۲۶ منتشر شد، پاسخ مثبت است. این پروژه ثابت میکند که دوری از کتابخانههای شخص ثالث، سریعترین راه برای توقف نگاه به هوش مصنوعی بهعنوان یک «جعبه سیاه» است.
بسیاری از توسعهدهندگان امروز به انتزاعهای سطح بالا تکیه میکنند. آنها تابعی را در PyTorch یا TensorFlow فراخوانی میکنند و به محاسبات دیفرانسیلی زیرین برای بهروزرسانی وزنها اعتماد میکنند. این وضعیت شکافی دانشی ایجاد میکند؛ کاربر میداند چگونه از ابزار استفاده کند، اما نمیداند ابزار واقعاً چگونه یاد میگیرد.
برای کسانی که وارد این حوزه میشوند، این شکاف یک نقطه ضعف است. درک ریاضیات خامِ نحوه تنظیم پارامترهای داخلی مدل، همان چیزی است که یک مهندس یادگیری ماشین را از یک مهندس پرامپت متمایز میکند. این مفاهیم در واقع سه رکن تبدیل ریاضیات به هوش مصنوعی هستند که ساختار یادگیری ماشین را شکل میدهند. با حذف کتابخانهها، منطق شبکه کاملاً قابل مشاهده و بازرسی میشود.
همانطور که در بحثهای گذشته ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، شفافیت در لایههای زیرین، کلید کنترل و بهینهسازی واقعی است.
شبکه عصبی (Neural Network) — شبیه نقشهٔ مترویی است که سیگنالها را از ورودی به جواب میرساند — در این پروژه برای یک وظیفه طبقهبندی دوتایی طراحی شده است: پیشبینی قبولی دانشجو در امتحان بر اساس ساعات مطالعه.
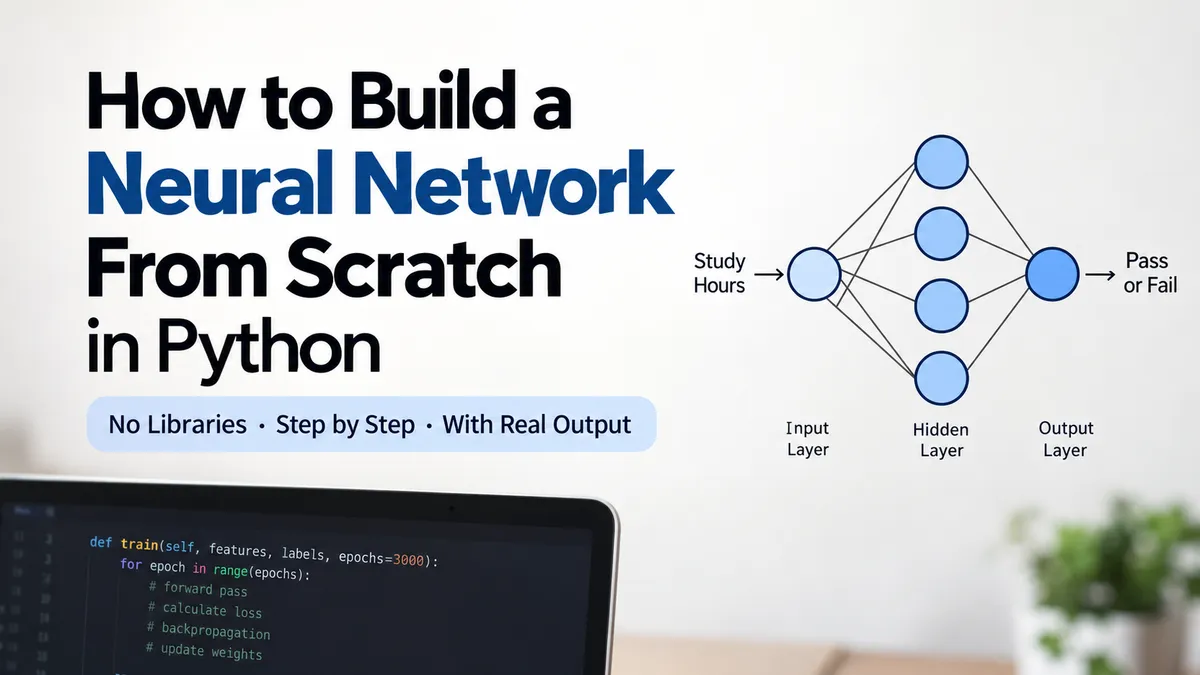
معماری شبکه برای شفافیت ریاضی، بهطور عمدی ساده و سبک نگه داشته شده است:
- لایه ورودی: یک ویژگی واحد (ساعات مطالعه) که به بازه ۰ تا ۱ مقیاس شده است. این کار از طریق تقسیم ساعات بر عدد ۸ در تابع
load_datasetانجام میشود. - لایه پنهان: چهار نورون که ورودی را با استفاده از وزنها و بایاسها پردازش میکنند. این وزنها با استفاده از
random.uniform(-1, 1)مقداردهی اولیه شدهاند و بایاسها روی مقدار ۰.۰ تنظیم شدهاند. - لایه خروجی: یک نورون واحد که یک امتیاز احتمال بین ۰ و ۱ تولید میکند.
بر اساس مستندات پروژه، مجموعه داده در فایلی به نام dataset.csv ذخیره شده است. این فایل شامل سه ستون مشخص است: study_hours (ساعات مطالعه)، passed (وضعیت قبولی که در آن ۰ به معنای مردود و ۱ به معنای قبول است) و split (که مشخص میکند هر ردیف متعلق به مجموعه آموزش است یا آزمون).
نمونههایی از این دادهها شامل دانشجویانی است که ۱، ۲، ۲.۵، ۳ و ۴ ساعت مطالعه کرده و مردود شدهاند، و کسانی که ۴.۵، ۵، ۶ و ۷ ساعت مطالعه کرده و قبول شدهاند. مجموعه آزمون (Test Set) از سه نمونه خاص تشکیل شده است: ۳.۵ ساعت (مردود)، ۵.۵ ساعت (قبول) و ۸ ساعت (قبول).
باید توجه داشت که این مثالها مصنوعی هستند. اینها رکوردهای واقعی دانشجویان نیستند و نباید برای نتیجهگیری درباره عملکرد واقعی در امتحانات استفاده شوند. مدل از ردیفهای آموزشی یاد میگیرد و سپس روی سه ردیفی که به عنوان آزمون علامتگذاری شدهاند، ارزیابی میشود.
برای بازتولید این پروژه، نویسنده از VS Code و پایتون ۳ استفاده کرده است. ساختار پروژه بسیار مینیمال است و تنها شامل یک پوشه به نام python-ai-from-scratch/ است که حاوی دو فایل dataset.csv و ai.py میباشد.
کاربران میتوانند نصب پایتون خود را در ترمینال با دستور python --version بررسی کنند. هیچ بسته خارجی مورد نیاز نیست و کد تنها بر سه ماژول داخلی پایتون تکیه دارد:
csv: برای خواندن مجموعه داده دانشجویان.math: برای محاسبات نمایی و لگاریتمی.random: برای مقداردهی اولیه وزنها و بههمریختن (Shuffle) نمونههای آموزشی جهت جلوگیری از سوگیری ترتیب. کد ازrandom.seed(42)استفاده میکند تا نتایج بازتولیدپذیر باشند.
برای فعال کردن شبکه، چندین سازوکار ریاضی کلیدی با استفاده از ماژول math پیاده شده است.
نخست، لایه پنهان از Leaky ReLU (واحد خطی اصلاحشده) استفاده میکند. برخلاف ReLU استاندارد که مقادیر منفی را صفر میکند، Leaky ReLU اجازه میدهد یک گرادیان کوچک (۰.۰۱) جریان یابد. این کار از پدیده «مرگ نورونها» که باعث توقف کامل یادگیری میشود، جلوگیری میکند. منطق آن ساده است: اگر مقدار بزرگتر از ۰ باشد، همان مقدار را برمیگرداند؛ در غیر این صورت، مقدار 0.01 * value را برمیگرداند.
دوم، لایه خروجی از تابع Sigmoid بهره میبرد. این تابع هر عدد حقیقی را به بازهای بین ۰ و ۱ میبرد که برای طبقهبندی دوتایی ضروری است. برای جلوگیری از خطاهای ریاضی (مانند سرریز)، ورودیها قبل از اعمال فرمول 1 / (1 + math.exp(-value)) بین ۵۰۰- و ۵۰۰ محدود (Clip) میشوند.
مدل از یک آستانه (Threshold) ۰.۵ برای تصمیمگیری استفاده میکند؛ امتیازی کمتر از ۰.۵ به عنوان مردود (۰) و امتیازی برابر یا بیشتر از ۰.۵ به عنوان قبول (۱) طبقهبندی میشود.
منطق پیادهسازی در یک کلاس به نام NeuralNetwork سازمان یافته است که مسئولیتهای مشخصی دارد:
load_dataset(): فایل CSV را میخواند و دادههای آموزش را از دادههای آزمون جدا میکند.forward(): خروجی شبکه را از طریق ترکیب ورودیها با وزنها و افزودن بایاسها محاسبه میکند.predict(): یک پوشش (Wrapper) است که امتیاز خروجی را برای یک ورودی given برمیگرداند.calculate_loss(): خطای پیشبینی مدل را با استفاده از آنتروپی متقاطع دوتایی اندازهگیری میکند.train(): وزنها و بایاسهای شبکه را در تعداد مشخصی از دورهها (Epochs) بهروزرسانی میکند.
فرآیند آموزش در واقع تلاش برای به حداقل رساندن زیان آنتروپی متقاطع دوتایی (Binary Cross-Entropy) است. مدل با وزنها و بایاسهای تصادفی شروع شده و طی ۳۰۰۰ Epoch (دوره آموزش) به صورت تکرار شونده بهبود مییابد.
هر گام آموزشی از یک توالی سختگیرانه پیروی میکند:
۱. گذر پیشرو: ورودی در وزنها ضرب شده، بایاس اضافه میشود و از توابع فعالساز عبور میکند. متد forward() ابتدا فعالسازهای لایه پنهان و سپس مقدار خروجی نهایی را محاسبه میکند.
۲. محاسبه زیان: تفاوت بین پیشبینی و نتیجه واقعی اندازهگیری میشود. متد calculate_loss() از یک مقدار اپسیلون کوچک (1e-7) استفاده میکند تا از محاسبه لگاریتم صفر جلوگیری کند. فرمول مورد استفاده، مجموع target * math.log(p) + (1 - target) * math.log(1 - p) را کم میکند.
۳. پسانتشار (Backpropagation): خطا به عقب رانده میشود تا مشخص شود هر وزن چقدر در اشتباه نقش داشته است. کد مقدار output_error را به صورت prediction - target محاسبه میکند. همچنین وزنهای خروجی قدیمی را حفظ میکند تا خطا را به درستی از طریق گرادیان فعالساز به لایه پنهان منتقل کند.
۴. گرادیان کاهشی (Gradient Descent): وزنها با نرخ یادگیری (Learning Rate) ۰.۱ بهروزرسانی میشوند تا مدل به سمت پیشبینی دقیقتری سوق یابد. متد train() به ترتیب output_weights ،output_bias ،hidden_weights و hidden_biases را بهروز میکند.
نرخ یادگیری یک هایپرپارامتر حیاتی است. نرخی که بیش از حد بزرگ باشد میتواند آموزش را ناپایدار کند، در حالی که نرخ بسیار کوچک باعث میشود پیشرفت آموزش بیش از حد کند شود.
طبق گزارش dev.to، مدل منحنی یادگیری واضحی داشت. زیان آموزش از ۰.۶۷۹۹ در دوره صفر به ۰.۰۰۲۶ در دوره ۲۵۰۰ رسید. نویسنده برای ردیابی این پیشرفت، زیان را هر ۵۰۰ دوره چاپ کرد:
- دوره ۰: زیان آموزش = ۰.۶۷۹۹
- دوره ۵۰۰: زیان آموزش = ۰.۰۳۸۷
- دوره ۱۰۰۰: زیان آموزش = ۰.۰۰۹۹
- دوره ۱۵۰۰: زیان آموزش = ۰.۰۰۵۳
- دوره ۲۰۰۰: زیان آموزش = ۰.۰۰۳۵
- دوره ۲۵۰۰: زیان آموزش = ۰.۰۰۲۶
هنگام آزمایش روی سه نمونه کنار گذاشته شده، مدل به صحت (Accuracy) ۱۰۰٪ دست یافت. نتایج به شرح زیر بود:
- ۳.۵ ساعت: واقعی ۰، پیشبینی ۰ (امتیاز ۰.۰۰۰۹)
- ۵.۵ ساعت: واقعی ۱، پیشبینی ۱ (امتیاز ۱.۰۰۰۰)
- ۸ ساعت: واقعی ۱، پیشبینی ۱ (امتیاز ۱.۰۰۰۰)
صحت با فرمول (Correct Predictions / Total Test Examples) * 100 محاسبه شد که در اینجا (3 / 3) * 100 = 100% شد. مقادیر امتیاز تا چهار رقم اعشار نمایش داده شدهاند، به این معنی که امتیاز ۱.۰۰۰۰ ممکن است مقداری بسیار نزدیک به ۱ باشد و نه دقیقاً ۱.
با این حال، نویسنده هشدار میدهد که اندازه مجموعه آزمون برای اثبات قابلیت اطمینان در دنیای واقعی بسیار کوچک است. تنها یک پیشبینی غلط میتوانست صحت را به ۶۶.۶۷٪ کاهش دهد. همچنین تأکید میکند که مجموعه داده مصنوعی است و نباید برای نتیجهگیریهای واقعی استفاده شود.
برای عمیقتر کردن درک کاربر، این راهنما چندین آزمایش را پیشنهاد میکند:
- نرخ یادگیری: کاهش نرخ از ۰.۱ به ۰.۰۱ برای مشاهده همگرایی کندتر و پایدارتر.
- اندازه شبکه: افزایش تعداد نورونهای پنهان (که در حال حاضر ۴ است) برای بررسی اینکه آیا مدل سریعتر با دادهها منطبق میشود یا خیر.
- گسترش مجموعه داده: افزودن نمونههای بیشتر به CSV و اختصاص یک مجموعه آزمون بزرگتر برای اعتبارسنجی بهتر.
- مهندسی ویژگی: افزودن ویژگیهای ورودی بیشتر فراتر از ساعات مطالعه.
- پایداری (Persistence): ذخیره وزنها و بایاسهای آموزش دیده برای استفاده مجدد از مدل بدون نیاز به آموزش دوباره.
نویسنده توصیه میکند در هر بار تنها یک تنظیم را تغییر دهید و نتایج را ثبت کنید تا متوجه شوید کدام تغییر خاص باعث تفاوت در عملکرد شده است.
این تمرین پلی برای درک مدلهای زبانی بزرگ (LLM) است. اگرچه LLMها میلیاردها پارامتر، توان محاسباتی عظیم و مجموعه دادههای گسترده دارند، اما چرخه بنیادی پیشبینی، محاسبه زیان و بهینهسازی دقیقاً همین است. مفاهیم پایه پارامترها، پیشبینیها، زیان و بهینهسازی، نقاط شروع ضروری برای درک هر معماری هوش مصنوعی هستند. این رویکرد آموزشی با هدف دموکراتیزه کردن دانش AI همسو است، مشابه آنچه در برنامه آموزشی رایگان و متنباز شعیب عالم برای توسعهدهندگان ارائه شده است.
برای خواننده، این بدان معناست که سد ورود به مهندسی هوش مصنوعی کمتر از آن است که به نظر میرسد. شما برای درک منطق هسته AI به خوشه GPU نیاز ندارید؛ تنها یک نصب ساده پایتون و چند خط ریاضی کافی است. این موضوع یادآور دستاوردهایی است که در آن ابزارهایی مانند Jeffy توانستند طبقهبندی متون را بدون نیاز به GPU و تنها با تکیه بر CPU اجرا کنند. با بازرسی محاسبات به جای برخورد با مدل به عنوان یک جعبه سیاه، میتوانید از یک کاربر ساده ابزار به کسی تبدیل شوید که علم پشت آنها را درک میکند.
گام بعدی شما
- کد پروژه را اجرا کنید و نرخ یادگیری را از ۰.۱ به ۰.۰۱ کاهش دهید تا اثر آن بر سرعت همگرایی را ببینید.
- تعداد نورونهای لایه پنهان را از ۴ به ۱۰ برسانید و بررسی کنید آیا مدل سریعتر یاد میگیرد یا دچار بیشبرازش (Overfitting) میشود.
- یک ویژگی جدید (مثلاً ساعت خواب) به فایل CSV اضافه کنید و معماری لایه ورودی را تغییر دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو