
تصور کنید تمام یادداشتهای پراکنده شما در اسلک، نوشن و جیمیل به جای اینکه تکههایی از یک پازل گمشده باشند، در یک مغز دیجیتال واحد و قابل جستوجو تجمیع شوند. اگر هنوز برای یافتن یک مقاله قدیمی در میان دهها پوشه بوکمارک میگردید، باید بدانید که مشکل از حافظه شما نیست، بلکه مشکل در معماری بازیابی دادههای شماست. آیا جستوجوی استاندارد هرگز میتواند واقعاً مشکل بازیابی را حل کند، در حالی که زندگی دیجیتال ما در میان اسلک، نوشن، جیمیل و فایلهای Markdown تکهتکه شده است؟
به نقل از گزارش منتشر شده در ۳۰ اوت ۲۰۲۶ در وبسایت dev.to، یک مهندس خبره راهنمایی را بر اساس اصول بنیادین منتشر کرد تا نشان دهد چگونه میتوان یک سامانه تولید بازیابیافزا (Retrieval-Augmented Generation یا RAG) — شبیه به دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — برای یکپارچهسازی سیلوهای اطلاعاتی طراحی کرد.
مسئله دانش تکهتکه شده
بسیاری از متخصصان با مشکل پراکندگی منابع در ابزارهایی مثل Logseq، مستندات ADR، فایلهای Readme پروژه و توییتر دستوپنجه نرم میکنند. نویسنده این گزارش مثالی شخصی و ملموس میزند: او مقالهای درباره مردی مبتلا به ADHD را که دو سال پیش خوانده بود، برای مدت بیش از یک سال گم کرد. او با وجود جستوجو در بوکمارکها و گوگل، نتوانست آن را بیابد تا اینکه در نهایت، مقاله را در ایمیلی که به یک لیست پستی ارسال کرده بود، یافت. یک سیستم RAG شخصی اجازه میداد با یک پرسش ساده مانند «مقاله مربوط به شخصی با ADHD»، این منبع فوراً و بدون تلاش زیاد بازیابی شود.
در حال حاضر اکثر کاربران از ابزارهایی مثل NotebookLM استفاده میکنند که نیاز به مدیریت دستی فضای کاری و زمینههای ایزوله دارند. این ابزارها باعث ایجاد اثر «سیلو» میشوند؛ یعنی اطلاعات موجود در یک دفترچه نمیتواند با اطلاعات دفترچه دیگر تعامل داشته باشد. همانطور که در تحلیلهای پیشین ما درباره مدیریت دانش دیجیتال اشاره کردیم، یک لایه دانش واقعی نیازمند سیستمی است که تمام ردپاهای دیجیتال را به عنوان یک پایگاه داده واحد و قابل پرسوجو ببیند، نه مجموعهای از فضاهای کاری ایزوله که باید به صورت دستی مدیریت شوند.
RAG چیست؟
تولید بازیابیافزا (RAG) فرآیند تکمیل پرامپتهای مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — با اطلاعات مرتبط است که از دادههای شخصی شما استخراج شده است. در این حالت، مدل به جای تکیه صرف بر دادههای عمومی آموزش دیده، بر اساس اطلاعات واقعی و خصوصی شما پاسخ میدهد. این رویکرد در واقع پاسخی به چالش توهمات مدلهاست، چرا که اتصال به دانش خارجی ریسک خطای LLM را به شدت کاهش میدهد. این فرآیند به طور معمول در سه گام رخ میدهد:
۱. محتوای مرتبط از یک مخزن داده (Datastore) از منابع مختلف بازیابی میشود.
۲. سیستم، پرسش کاربر را با این محتوای بازی شده تقویت (Augment) میکند.
۳. مدل زبانی بزرگ (LLM) پرامپت تقویتشده را دریافت کرده و پاسخی را بر اساس آن تولید میکند.
طبق مستندات این راهنما در dev.to، هدف اصلی این است که دانش از منابع خام از طریق یک خط لوله (Pipeline) مشخص به بستر قابل استفاده برای LLM منتقل شود. معماری این سیستم از چندین زیرسیستم حیاتی تشکیل شده است:
خط لوله RAG
- اتصالدهندههای منبع (Source Connectors): اجزای تخصصی که با منابع مختلف ارتباط برقرار میکنند تا دادههای خام را از اپلیکیشنهایی مانند لینکدین، توییتر و مستندات ADR استخراج کنند.
- جذب و پردازش (Ingestion & Processing): مرحله جذب، دادههای خام را وارد سیستم میکند، در حالی که پردازش، فرمتهای متنوع داده را به یک ساختار یکسان تبدیل میکند؛ درست مشابه روشی که APIها برای استانداردسازی دادهها از JSON استفاده میکنند.
- ذخیرهسازی دانش (Knowledge Storage): ذخیره دادههای پردازش شده در ساختارهایی که برای بازیابی سریع بهینه شدهاند. این بخش ممکن است ترکیبی از ذخیرهسازهای سند (Document Storage)، ایندکسهای متن کامل (Full-text indexes) و ایندکسهای برداری باشد.
- بازیابی (Retrieval): قلب سیستم که نتایج را بر اساس میزان ارتباط رتبهبندی میکند. برای مثال، اگر در مورد ADHD جستوجو کنید، سیستم یک پست وبلاگ با عنوان مشابه را «بسیار مرتبط»، یک یادداشت شخصی را «مرتبط» و یک توییتر تصادفی را «نامرتبط» ارزیابی میکند.
- آمادهسازی زمینه و تولید (Context Preparation & Generation): این همان بخش «افزونه» و «تولید» (حرف G در RAG) است. سیستم پرامپت نهایی را با ترکیب پرسش کاربر و محتوای بازیابی شده میسازد و سپس LLM از آن برای تولید پاسخی همراه با ارجاعات استفاده میکند.
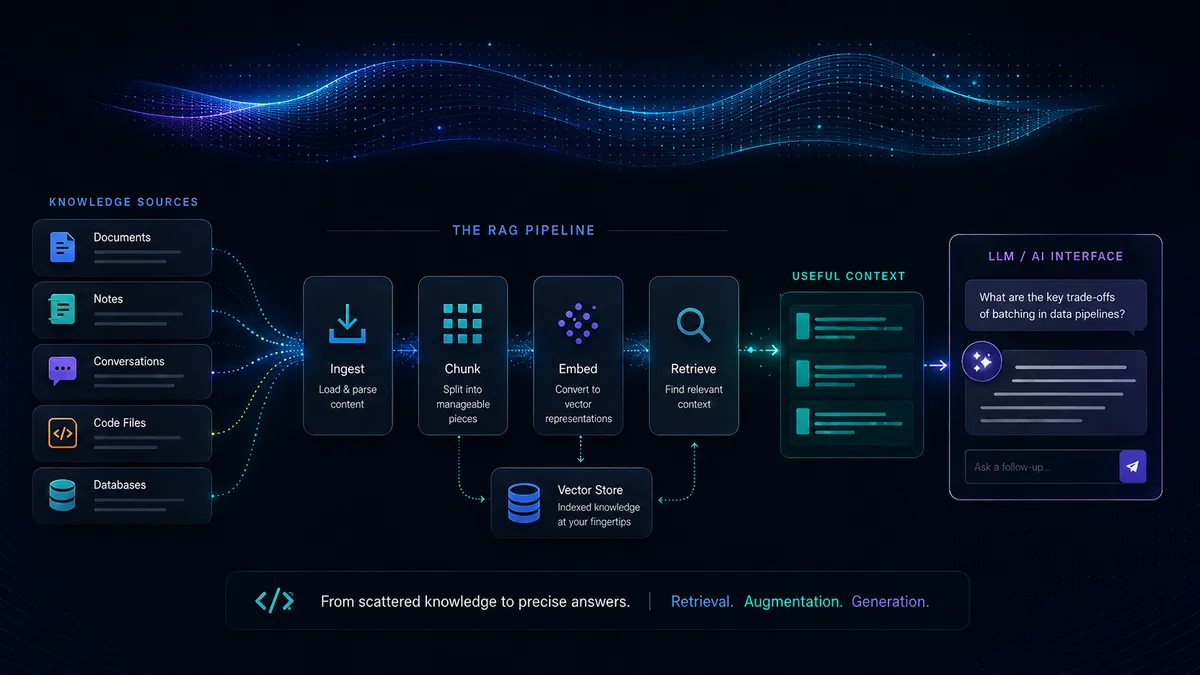
این کالبدشکافی معماری نشان میدهد که جاسازیها (Embeddings) و پایگاههای داده برداری، خودِ سیستم نیستند، بلکه صرفاً ابزارهایی برای حل زیرمسئلههای خاص هستند. با نگاه به RAG به عنوان یک چالش طراحی سیستم (System Design) به جای یک تسک «انتخاب ابزار»، توسعهدهندگان میتوانند از تله پیادهسازیهای «جعبه سیاه» رها شوند. این تفکر سیستمی همان نقطهای است که بسیاری از متخصصان در دنیای واقعی با آن دستوپنجه نرم میکنند؛ تا جایی که برخی مدیران محصول حتی در مصاحبههای فنی شرکتهای بزرگی چون تنسنت، در درک این شکافهای پیادهسازی RAG شکست میخورند. هدف این است که مسئله را چنان شفاف کنیم که معماری فنی به طور طبیعی حاصل شود.
برای یک متخصص معمولی، این تغییر به معنای گذار از «جستوجوی یک فایل» به «پرسوجو از یک زندگی» است. به جای اینکه کاربر به خاطر بیاورد مقالهای خاص درباره ADHD دو سال پیش در کدام پوشه بوکمارک ذخیره شده است، به سادگی از سیستم درباره آن اطلاعات میپرسد و خط لوله RAG عملیات بازیابی و ترکیب دادهها را مدیریت میکند.
این متدولوژی فرض بنیادین مدیریت دانش شخصی را تغییر میدهد. این رویکرد پیشنهاد میکند که ارزش واقعی هوش مصنوعی نه در دادههای عمومی آموزش دیده، بلکه در توانایی آن برای عمل کردن به عنوان یک رابط دقیق برای دادههای خصوصی و پراکنده هر فرد است.
توسعهدهندگانی که قصد پیادهسازی این سیستم را دارند، باید ابتدا منابع دادههای خود را ترسیم کرده و پیش از انتخاب پایگاه داده برداری، طرحواره نرمالسازی (Normalization Schema) خود را تعریف کنند. فاز بعدی این ساخت، بر جریان واقعی دادهها، نحوه همکاری اجزا و موازنه (Trade-off)های طراحی خاص در پیادهسازی تمرکز خواهد کرد.
گام بعدی شما
- ابتدا تمام منابع دادههای خود (ایمیل، یادداشتها، پیامها) را فهرست کنید.
- یک طرح برای نرمالسازی دادهها (Normalization Schema) تعریف کنید تا فرمتهای مختلف یکسان شوند.
- پیش از انتخاب پایگاه داده برداری، مدل بازیابی خود را بر اساس نوع دادههایتان (متنی یا ساختاریافته) طراحی کنید.
اما چالش اصلی در پیادهسازی این سیستم، مدیریت جریان دادهها و موازنه بین دقت و سرعت است — در گزارش بعدی به بررسی Trade-offهای فنی این معماری خواهیم پرداخت.



گفتگو