تصور کنید ابزاری ساختهاید که قرار است دنیا را تغییر دهد، اما هیچکس نمیتواند از آن استفاده کند چون سیستم ورود کاربر با مدل سازگار نیست. برای توسعهدهندگان، فاصله میان «کار کردن کد» و «کاربردی بودن ابزار» در پروتکل MCP بسیار بیشتر از آن است که در مستندات رسمی دیده میشود. ارسال یک سرور راه دور پروتکل زمینهٔ مدل (Model Context Protocol یا MCP) ممکن است تنها یک بعدازظهر زمان ببرد، اما کاربردی کردن آن روزها طول میکشد. در حالی که خود پروتکل ساده است، اما سربارهای عملیاتی مربوط به مجوزدهی، امنیت و توزیع، جایی است که اکثر توسعهدهندگان شکست میخورند.
ساخت مکانیسم واقعی که با MCP صحبت کند ساده است؛ اغلب تنها یک مسیر (Route) در یک بکاند موجود است که هیچ وابستگی جدیدی ایجاد نمیکند. با این حال، هر چیزی که پس از آن ساخت اولیه میآید، روزها زمان میبرد و تقریباً هیچکدام از این موارد در مستندات رسمی پروتکل پوشش داده نشده است. در ۲۸ سپتامبر ۲۰۲۶، یک تحلیل فنی مفصل در وبسایت dev.to فاش کرد که «کار» واقعی یک یکپارچهسازی MCP، بسیار فراتر از مستندات پروتکل اتفاق میافتد. برای توسعهدهندگان، اولین تصمیم حیاتی این است که آیا اصلاً به یک سرور نیاز هست یا خیر.
پروتکل زمینهٔ مدل (Model Context Protocol یا MCP) — شبیه به یک مترجم استاندارد است که اجازه میدهد مدلهای مختلف هوش مصنوعی بدون تغییر در کد، با دادههای خارجی صحبت کنند — اکنون به استانداردی برای اتصال عاملها (Agents) به ابزارهای خارجی تبدیل شده است. همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، هر نقطه اتصال جدید به دادهها، یک سطح حمله جدید برای مهاجمان ایجاد میکند. در MCP نیز اولین تصمیم حیاتی این است که آیا اصلاً به سرور نیاز دارید یا یک «مهارت» (Skill) ساده کفایت میکند. این چالشهای عملیاتی دقیقاً همان دلایلی است که باعث میشود بسیاری از سرورهای MCP در محیط عملیاتی با شکست مواجه شوند و توهمات مدلها را بهطور کامل حذف نکنند.
انتخاب میان مهارتها و سرورها
بسیاری از یکپارچهسازیها بهتر است به صورت «مهارت» تعریف شوند؛ یعنی فایلهای دستورالعمل سادهای که کاربر بهصورت محلی نصب میکند. مهارتها نیازی به میزبانی ندارند، هیچ سطح امنیتی (Security Surface) ایجاد نمیکنند و ظرافت بیشتری نسبت به توصیفات ابزار دارند؛ زیرا به جای یک خلاصه تکپاراگرافی، به صورت متنی (Prose) در زمینه (Context) عامل قرار میگیرند.
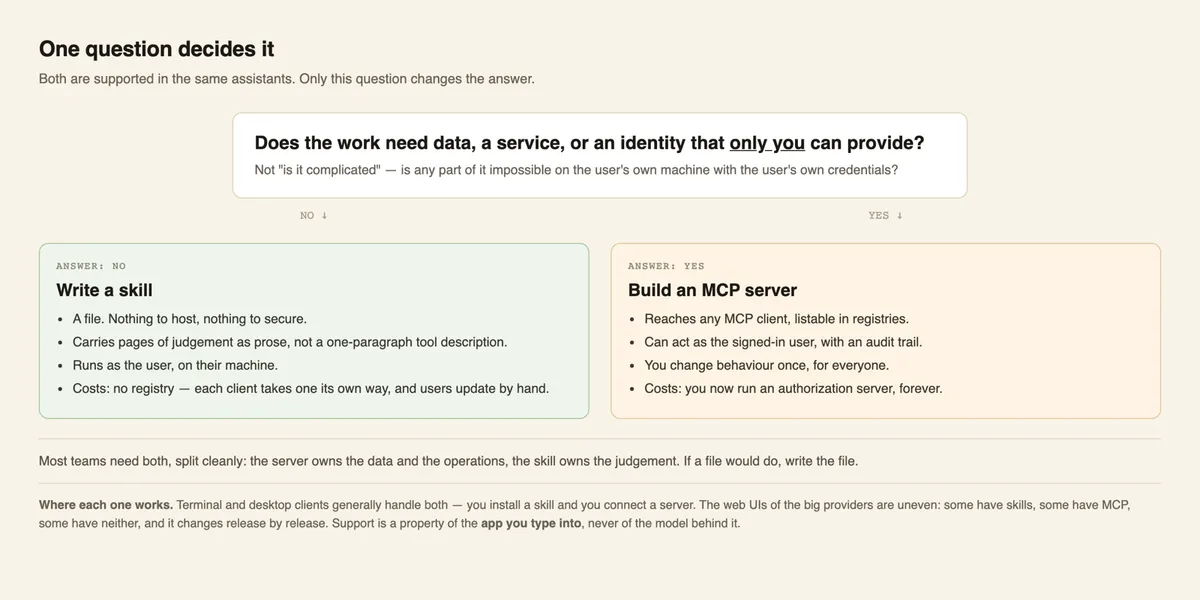
برای تصمیمگیری در مورد اینکه کدام مسیر را انتخاب کنید، توسعهدهندگان باید یک تست صادقانه بر اساس محل انجام کار اعمال کنند:
- مهارت بنویسید اگر: هر آنچه یکپارچهسازی نیاز دارد، از قبل روی دستگاه کاربر یا وب عمومی موجود است و کاربر میتواند اقدامات را با اعتبارنامههای خودش انجام دهد.
- سرور بسازید اگر: کار مورد نظر نیازمند دادهها یا سرویسی است که فقط شما میتوانید اجرا کنید؛ سرور باید به جای کاربر عمل کند (که نیازمند ورود و مجوزها است)؛ نیاز دارید رفتار را برای همه کاربران بهطور همزمان و بدون بهروزرسانی دستی فایلها تغییر دهید؛ یا میخواهید در فهرستها و دایرکتوریهای رسمی قابل کشف باشید.
یک عدم تقارن قابل توجه در اینجا وجود دارد که باید سنجیده شود: یک مهارت صرفاً یک فایل است، در حالی که یک سرور، یک سطح احراز هویت است که تا زمانی که فعال باشد، مالکیت و مسئولیت آن با شماست. قویترین ساختارها اغلب از هر دو استفاده میکنند: سرور مالک دادهها و عملیات است، در حالی که مهارت مالک قضاوت و تصمیمگیری است.
معماری نامگذاری ابزارها
نام ابزارها در MCP مانند یک «در یکطرفه» هستند؛ زیرا تغییر نام آنها پس از اسکن توسط یک فهرست (Registry)، یک مهاجرت میان سیستمهایی است که شما کنترلی روی آنها ندارید، نه یک بازنویسی (Refactor) ساده. در حالی که برخی از کارتهای امتیازدهی دایرکتوریها، مسیرهای نقطهدار (مثلاً stories.search) را برای ایجاد یک درخت قابل پیمایش تشویق میکنند — به طوری که یک لیست حتی امتیاز ۹۸ از ۱۰۰ گرفت اما دو امتیاز را به دلیل نبود این ویژگی از دست داد — این نامها توسط کلاینتهای OpenAI و Anthropic رد میشوند.
الگوی نامگذاری توابع در OpenAI به صورت ^[a-zA-Z0-9_-]{1,64} است؛ بنابراین نقاط (Dots) بهطور کامل رد میشوند. از آنجایی که نام ابزاری با نقطه توسط دقیقاً همان کلاینتهایی رد میشود که فهرستها برای رسیدن به آنها ساخته شدهاند، این معیاری است که شما باید آگاهانه در آن شکست بخورید (یعنی از آن اجتناب کنید).
توسعهدهندگان باید از ابتدا یک قرارداد گروهبندی انتخاب کرده و آن را بدون استثنا اعمال کنند و از زیرخط (Underscore) به عنوان جداکننده استفاده کنند تا ساختار خوانا باقی بماند. این موضوع باید در زمان برنامهریزی تصمیم گرفته شده و مکتوب شود، زیرا هر نام ابزار منتشر شده، پس از پذیرش توسط دایرکتوری اپلیکیشن کلاینت، دائمی میشود.
منطق ساخت سرور
یک سرور MCP از طریق یک انتقال HTTP قابل استریم (Streamable) و با فرمت JSON-RPC ارتباط برقرار میکند. کلاینت از سرور میخواهد که خودش را معرفی کند، لیست ابزارهای آن را درخواست میکند و سپس ابزارها را یکی یکی فراخوانی میکند. برای سرورهایی که از طریق اینترنت در دسترس هستند، یک نقطه انتهایی (Endpoint) همه چیز را مدیریت میکند.
در حالی که پیادهسازی فنی سادهترین بخش است، سه جزئیات خاص معمولاً نادیده گرفته میشوند:
- توضیحات عاملمحور: توضیحات ابزار را برای مدل زبانی بزرگ (LLM) بنویسید، نه برای انسان. این توضیحات تنها مبنایی هستند که مدل بر اساس آنها تصمیم میگیرد آیا از ابزار شما استفاده کند یا خیر. مدل مانند کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد.
- برچسبهای صادقانه: ابزارها را بهوضوح به عنوان «فقط خواندنی» (Read-only)، «تخریبی» (Destructive) یا «جهانباز» (Open-world) علامتگذاری کنید. کلاینتها این برچسبها را پیش از تأیید فراخوانی به کاربر نمایش میدهند.
- محتوای ساختاریافته: یک
outputSchemaتعریف کنید وstructuredContentبرگردانید تا عاملهای مصرفکننده بتوانند به جای تحلیل متن (Parsing Prose)، بر روی شکل و ساختار دادهها تکیه کنند.
تستها باید با MCP Inspector شروع شوند. این یک کلاینت تست است که بهصورت دستی هدایت میشود و هیچ مدلی در حلقه (Loop) نیست. این موضوع حیاتی است زیرا وقتی یک کلاینت واقعی در فراخوانی ابزار شکست میخورد، شما نمیتوانید از بیرون تشخیص دهید که آیا توصیفات مبهم بوده، اسکیما ناقص بوده یا سرور دچار خطا شده است. اینها سه باگ متفاوت هستند که ظاهر یکسانی دارند.
این ابزار همچنین یک بررسی قابلیت انتقال اسکیما (Schema Portability Check) انجام میدهد. در یک مورد، این ابزار اشاره کرد که فیلدهای Nullable که با یک نوع اما با دو ورودی نوشته شده بودند — در حالی که در JSON Schema قانونی بودند — توسط چندین کلاینت بهطور بیصدا (Silently) اشتباه پردازش میشدند؛ نقصی که تستهای استاندارد به دلیل اشتراک در پیشفرضهای توسعهدهنده، آن را نادیده میگرفتند.
زیرساخت و هزینهها
به دلیل ماهیت تکانشی (Bursty) درخواستها و اینکه سرورهای MCP سرویسهای HTTP کوچکی هستند که تا زمان فراخوانی توسط عامل بیکار میمانند، محیطهای Serverless برای آنها ایدهآل هستند. غریزه پیشفرض اغلب ایجاد یک مخزن (Repo) جدید، استفاده از SDK رسمی و استقرار یک کانتینر است؛ اما اضافه کردن یک مسیر (Route) به یک بکاند موجود بهینهتر است. نقطه ورود، یک شاخه (Branch) ساده در هندلر درخواستهای موجود با استفاده از کتابخانه استاندارد و SDK ابری است که از قبل در محیط اجرا (Runtime) وجود دارد، که منجر به ایجاد صفر وابستگی جدید میشود. برای مثال، پلتفرم Orivox با همین رویکرد توانست قابلیت انتشار مستقیم وبسایت را به Claude اضافه کند و تجربه کاربر را متحول کند.
تفکیک هزینههای واقعی:
- محاسبات حاشیهای: چند سنت در ماه؛ که اغلب توسط طرحهای رایگان (Free Tiers) پوشانده میشود.
- ثبت در Registry رسمی MCP: رایگان.
- ارسال به ChatGPT App: رایگان.
- فهرست Claude Connector: نیازمند یک سازمان Team است که هزینه آن تقریباً ۴۰ دلار در ماه با حداقل دو صندلی (User Seat) است.
هزینه واقعی تکرار شونده، هزینه محاسباتی نیست، بلکه مسئولیت اجرای یک سرور احراز هویت، مدیریت امنیت آن و رسیدگی به ناسازگاریهای جدیدی است که با انتشار نسخههای جدید کلاینتها ظاهر میشوند.
چهار لایه مدیریت هویت
مدیریت هویت دستکم گرفتهشدهترین بخش این فرآیند است. این موضوع به صورت یک تکلیف واحد ظاهر نمیشود، بلکه چهار مسئله متمایز است:
۱. عمل به جای شخص: وقتی یک ابزار نیاز به نوشتن داده دارد، شما فقط یک فیلد رمز عبور اضافه نمیکنید؛ بلکه در حال اجرای یک سرور کامل احراز هویت OAuth 2.1 هستید. این کار نیازمند اسناد کشف (Discovery Documents)، ثبت پویا کلاینت (Dynamic Client Registration)، PKCE و یک صفحه رضایت (Consent Screen) است. کلاینتها خودشان را ثبت میکنند، به این معنی که چیزی برای صدور پیشفرض وجود ندارد. این گرانترین مرحله فرآیند است. برای حل این پیچیدگی، راهکارهایی مانند ProxyKey معرفی شدهاند تا دسترسی به API بدون افشای کلیدها میسر شود.
۲. تصمیمگیری درباره موارد بدون نیاز به ورود: یک اشتباه رایج، قرار دادن همه چیز پشت دروازه احراز هویت است، حتی لیست ابزارهای موجود. اگر لیست ابزارها پنهان باشد، آینههای فهرست (Registry Mirrors) — که هیچ کاربری برای ورود ندارند — سرور را فقط با نام و توضیحات لیست میکنند اما بدون هیچ ابزاری. قانون این است: دقیقاً همان چیزهایی را بهصورت ناشناس نمایش دهید که در جای دیگری بهصورت عمومی در دسترس هستند و نه هیچ چیز بیشتر.
۳. ایجاد راه ورود برای غریبهها: بازبینهای اپلیکیشن (App Reviewers) باید بتوانند از سرور استفاده کنند. اگر تنها روش ورود از طریق یک ارائهدهنده اجتماعی (Social Provider) باشد، چیزی برای دادن به بازبین وجود ندارد و توسعهدهنده مجبور میشود در یک ضربالاجل تنگ، یک حساب Sandbox بسازد.
۴. داشتن توکن صحیح: انتشار تحت یک سازمان به جای نام شخصی، نیازمند توکنی است که Scope (محدوده دسترسی) خاصی را حمل کند. اگر این Scope موجود نباشد، پیامهای خطای حاصله اغلب مبهم هستند و صراحتاً به شما نمیگویند که مشکل از Scope است.
ابزارگذاری و توزیع
لاگهای استاندارد دسترسی (Access Logs) برای MCP بیفایدهاند زیرا هر فراخوانی به صورت POST /mcp میرسد و نتیجه آن ستونی از خطوط یکسان است. برای درک اینکه کدام ابزار، برای چه کسی و با چه ترتیبی اجرا شده است، توسعهدهندگان باید لاگگذاری آگاه از MCP (MCP-aware logging) را در Dispatcher بنویسند، نه در هر هندلر بهصورت جداگانه.
این لاگگذاری باید ساختاریافته و بهطور عمدی کوتاه شده باشد: شناسهها و طول دادهها را ثبت کنید، اما هرگز محتوای واقعی که کاربران ارسال میکنند را ذخیره نکنید. ابزارگذاری زودهنگام میتواند شکستهای خاموش بحرانی را شناسایی کند؛ برای مثال، یک سرور متوجه شد که کلاینتی در حال فراخوانی یک متد پیادهنشده است و بهطور بیصدا پنج بار در طول دو روز به حالت Fallback بازگشته است — اتفاقی که در لاگهای دسترسی عمومی یا داشبوردهای APM نامرئی بود.
توزیع بسته به مخاطب متفاوت است:
- کاربران ترمینال/IDE: برای ابزارهای داخلی یا مخاطبان شناخته شده، صرفاً نقطه انتهایی (Endpoint) و یک خط نصب در README منتشر کنید (مثلاً
claude mcp add --transport http <name> <url>). این کار ده ثانیه زمان میبرد و از بازبینها و فرمها اجتناب میکند. - کاربران فهرست اپلیکیشن: برای اینکه توسط غریبهها پیدا شوید، باید کوهی از متون را ارائه دهید: سیاستهای حریم خصوصی، شرایط استفاده، یک URL مستندات عمومی، یک فایل تأیید دامنه، توجیهات ابزار به ابزار، پرامپتهای نمونه و اعتبارنامههای تست.
یک قانون حیاتی برای ارسال: اسناد باید بازتابدهنده سرور در وضعیت فعلی آن باشند. سیاست حریم خصوصی که برای چهار ابزار «فقط خواندنی» نوشته شده است، اگر نقطه انتهایی زنده به شش ابزار با دسترسی «نوشتن» تکامل یافته باشد، منجر به رد فوری درخواست میشود. بازبینها متن را با نقطه انتهایی زنده تطبیق میدهند و چون این اسناد در زمان بازبینی واکشی (Fetch) میشوند و نه آپلود، باید بهروز نگه داشته شوند.
واقعیت کشف شدن (Discovery)
وارد شدن به فهرست رسمی، یک ورودی در پایگاه داده است، نه تضمینی برای دیده شدن. برخی دایرکتوریها «آینه» هستند که فهرست رسمی را میخوانند اما هرگز به نقطه انتهایی زنده متصل نمیشوند. اگر لیستی توضیحات و URL شما را نشان میدهد اما ابزاری را نمایش نمیدهد، متوجه میشوید که به یک آینه نگاه میکنید.
در نهایت، تنها معیاری که اهمیت دارد، نسبت فراخوانیهای پروتکل به فراخوانیهای واقعی ابزار است. در یک لاگ ۲۴ ساعته، نویسنده ۹۳ فراخوانی پروتکل (اتصال و لیست کردن ابزارها) ثبت کرد اما تنها یک فراخوانی واقعی از ابزار صورت گرفت. این موضوع شکاف عمیق میان یک کاربر «متصل شده» و یک کاربر «استفادهکننده» را برجسته میکند.
گام بعدی شما (خلاصه درسهای آموخته شده)
برای اجتناب از تلههای استقرار MCP، توسعهدهندگان باید:
۱. نام ابزارها را در سند برنامهریزی تثبیت کنند، نه در کد.
۲. لاگگذاری درخواستها را در اولین استقرار پیاده کنند، نه در پنجمین نسخه.
۳. بلافاصله پیش از ارسال، هر سند عمومی را با لیست ابزارهای زنده بازخوانی و تطبیق دهند.
۴. پیش از انجام کارهای سخت مورد نیاز، از خود بپرسند آیا حضور در یک فهرست (Directory Listing) واقعاً هدف نهایی است یا خیر.
این تغییر دیدگاه، توسعه MCP را از یک تمرین کدنویسی به یک چالش مدیریت محصول تبدیل میکند. مانع فنی پایین است، اما موانع توزیع و عملیاتی بودن بسیار بالا هستند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو