
اگر امروز تسکهای کدنویسی را به یک عامل هوش مصنوعی میسپارید، احتمالاً بیشتر از آنکه زمان بخرید، در حال مدیریت ریسک هستید. سپردن یک تغییر در کد به عامل (Agent) — شبیه به استخدام یک کارآموز سریع اما بیتجربه است که ممکن است در یک ثانیه هزار خط کد بنویسد، اما ساعتها وقت شما را برای پیدا کردن یک غلط املایی کوچک بگیرد — تا زمانی که ریسک نتیجه را کمیسازی نکنید، چیزی جز قمار نیست. بسیاری از تیمها تفویض کار به هوش مصنوعی را یک انتخاب دوگانه میبینند: یا مدل انجام میدهد یا انسان. اما این نگاه، هزینه پنهان «تایید» را نادیده میگیرد. یک عامل میتواند سریعاً یک پچ بزرگ تحویل دهد، اما توسعهدهنده همچنان باید تغییرات را بفهمد، نتیجه را تایید کند، موارد فراموش شده را اصلاح کند و تصمیم بگیرد که آیا این پچ برای محیط عملیاتی امن است یا خیر. طبق گزارشهای منتشر شده، اگر زمان بازبینی و تایید بیشتر از زمان اجرای دستی تسک باشد، هوش مصنوعی بهجای کاهش هزینه، بار کاری را افزایش داده است. این موضوع با تحلیلهای پیشین ما درباره مدلهای رایگان در برابر میزبانی شخصی همسو است که نشان میدهد کاهش هزینه ظاهری لزوماً به معنای افزایش بهرهوری نیست.
این چالش دقیقاً زمانی رخ میدهد که تیمها از دستیارهای سادهی چتمحور به سمت عاملهای خودگردانی میروند که قادر به تغییر کل مخازن کد هستند. در حالی که ابزارهایی مثل Explyt اکنون با ادغام عمیق در IDEها ساختار کد را میفهمند، گلوگاه دیگر توانایی مدل نیست، بلکه توانایی انسان در تایید خروجی بدون صرف ساعتها وقت در diff viewer است. تعداد درخواستها، خطوط تولید شده و توکنهای مصرفی، فعالیت و هزینه مدل را توصیف میکنند، اما ارزش ایجاد شده را اندازه نمیگیرند. برای اندازهگیری ارزش واقعی، تیمها به دو سیگنال قویتر نیاز دارند: تغییر در «زمان فعال توسعهدهنده» و میزان تطابق نتیجه با معیارهای پذیرش از پیش تعریف شده.
به نقل از مستندات این چارچوب عملیاتی که در ۲۵ اوت ۲۰۲۶ منتشر شد، یک سیستم امتیازدهی سه پارامتری برای تعیین «حالت کاری» (Work Mode) هر تسک معرفی شده است. هدف این است که از احساسات ذهنی درباره قابلیت اطمینان هوش مصنوعی فاصله بگیریم و به یک خط پایه قابل تایید از زمان توسعهدهنده برسیم.
سه ستون تفویض
در این سیستم، هر تسک در سه بعد مستقل از ۱ تا ۳ امتیاز میگیرد. ترکیب این امتیازها در یک عدد واحد ممنوع است، زیرا یک امتیاز ترکیبی ارزیابی را مخدوش میکند؛ برای مثال، تاییدپذیری بالا لزوماً هزینه خطا را کاهش نمیدهد و داشتن الزامات شفاف، به معنای وجود یک روش بررسی مستقل نیست.
قطعیت نتیجه (Certainty of Result): این پارامتر پاسخ میدهد که آیا تیم میتواند قبل از شروع پیادهسازی، دقیقاً توصیف کند چه چیزی باید تغییر کند و چه چیزی نباید تغییر یابد؟
- سطح ۱ (پایین): زمانی اختصاص مییابد که مالک محصول هنوز رفتار مورد نظر را انتخاب نکرده باشد، تسک چندین مسیر معماری داشته باشد بدون اینکه معیاری برای انتخاب وجود داشته باشد، یا مستندات با کد موجود در تضاد باشند. مثال: تعیین مرزهای تفکیک یک Monolith در حالی که روابط تراکنشی بین ماژولها ناشناخته است.
- سطح ۲ (متوسط): رفتار اصلی مورد توافق است، اما موارد خاص (Edge Cases) تعریف نشدهاند، یا لیست دقیق فایلهای متأثر تنها پس از تحلیل مشخص میشود. مثال: افزودن مکانیزم Retry در جایی که روش ذخیره وضعیت (State-storage) باید بعد از بررسی زیرساخت انتخاب شود.
- سطح ۳ (بالا): تمام شرایط برقرار است: نتیجه توسط یک قرارداد (Contract) یا سناریوهای دقیق توصیف شده، مرزها تعریف شدهاند و دو توسعهدهنده مختلف انتظار نتیجه یکسانی را دارند. مثال: رفع یک نقص سریالسازی بازتولیدپذیر در یک ماژول در حالی که اسکیمای عمومی حفظ شود.
تاییدپذیری نتیجه (Verifiability of Result): این پارامتر بررسی میکند که آیا تیم میتواند نتیجه را مستقل از توضیحات خودِ عامل تایید کند؟ یک بررسی مستقل باید بر مبنایی متفاوت از پیادهسازی عامل استوار باشد.
- سطح ۱ (پایین): صحت کار تنها با خواندن یک تغییر بزرگ (Large Change) قابل ارزیابی است؛ هیچ سناریوی بازتولیدپذیری وجود ندارد یا معیارهای موفقیت ذهنی (Subjective) هستند. مثال: تغییر در یک فرآیند توزیعشده که خطاها بهندرت رخ میدهند و تشخیص آنها از طریق لاگهای ناقص صورت میگیرد.
- سطح ۲ (متوسط): رفتار اصلی قابل بررسی است اما کنترل دستی همچنان لازم است. تستهایی برای سناریوی اصلی وجود دارد، اما موارد خاص بهصورت دستی چک میشوند. مثال: یک اصلاح محلی با یک Unit Test شکستخورده که ادغام آن باید بهصورت دستی در محیط تست بررسی شود.
- سطح ۳ (بالا): یک معیار پذیرش مستقل وجود دارد که میتوان نشان داد قبل از تغییر «برآورده نشده» و بعد از آن «برآورده شده» است. بیلد و تستها بازتولیدپذیر هستند. مثال: رفع نقص در یک ماژول ایزوله که در آن یک تست موجود قبل از پچ شکست میخورد و بعد از آن پاس میشود.
هزینه خطا (Error Cost): این پارامتر پیامد رسیدن یک نقص به کاربر نهایی را توصیف میکند. اندازه Diff پیشبینیکننده تاثیر نیست؛ یک خط تغییر در بررسی دسترسیها (Access-rights) میتواند خطرناکتر از صدها خط در یک ابزار داخلی باشد. ارزیابان بدترین پیامد محتمل را امتیازدهی میکنند.
- سطح ۱ (پایین): تاثیر بر مخاطبان محدود داخلی؛ بدون ریسک از دست رفتن داده، ضرر مالی یا تخلف امنیتی. بازگشت به حالت قبل (Rollback) سریع است و نیازی به بازیابی وضعیت دادهها ندارد. مثال: پیشنویس مستندات داخلی یا ابزارهای محلی توسعهدهنده.
- سطح ۲ (متوسط): پیامدها محدودند اما بازیابی آنها نیازمند تلاش محسوس است. دادهها قابل محاسبه مجدد یا بازیابی هستند. ریسک مستقیم برای امنیت یا پرداختها وجود ندارد. مثال: شکست در یک قابلیت جانبی که با Feature Flag غیرفعال شده است.
- سطح ۳ (بالا): احتمال ضرر مالی، محاسبات غلط پرداخت یا افشای دادهها وجود دارد. بخشهای احراز هویت، مجوزها یا APIهای عمومی حیاتی متأثر میشوند. بازگشت به حالت قبل ممکن است سیستم را به وضعیت اولیه برنگرداند. مثال: مهاجرت دادههای Production یا تغییر در محاسبات کمیسیون.
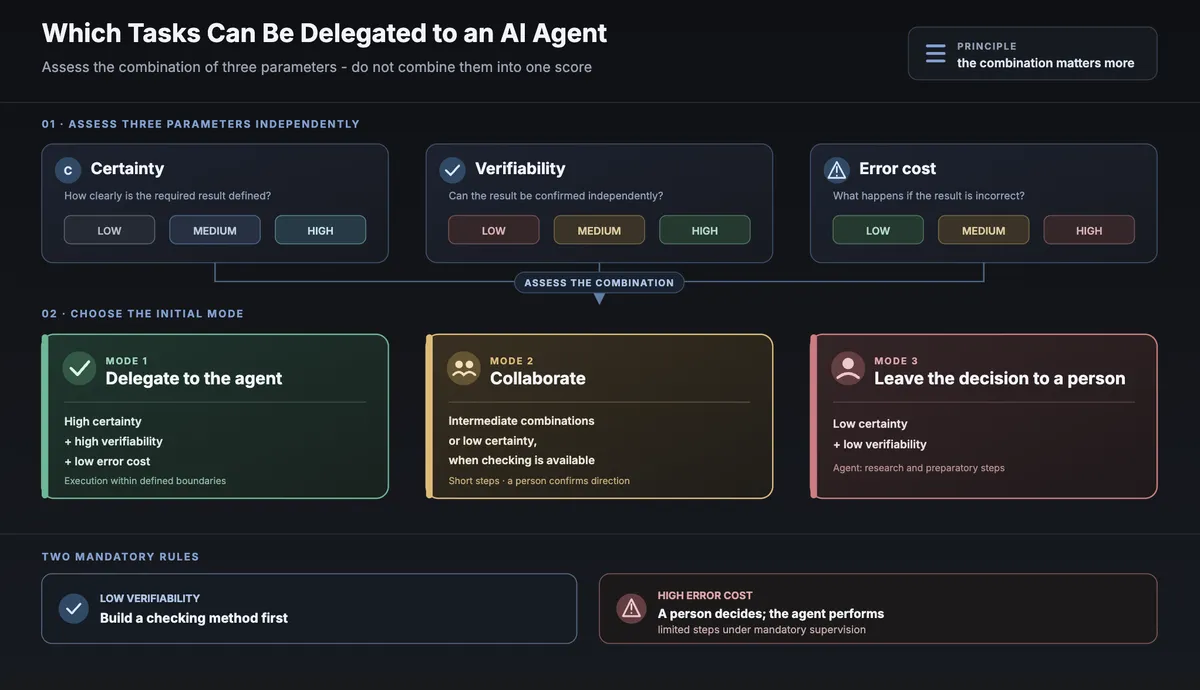
ماتریس تفویض و حالتهای کاری
برای جلوگیری از تداخل، این چارچوب از یک ماتریس اولویتمحور استفاده میکند. قوانین از بالا به پایین اجرا میشوند؛ به محض اینکه یک شرط برقرار شود، ردیفهای پایینتر نادیده گرفته میشوند. این ساختار تضمین میکند که هزینه بالای خطا همیشه بر سایر پارامترها اولویت داشته باشد. این رویکرد سختگیرانه یادآور مکانیسمهای گیره ایمنی گیتهاب است که برای جلوگیری از اشتباهات مطمئن عاملها، آستانههای اعتماد خاصی را تعریف کرده است.
قوانین اولویت برای انتخاب حالت:
- قانون ۱ (هزینه خطا = ۳): انسان مالک تصمیم و پذیرش است. عامل فقط گامهای محدود و از پیش تایید شده را انجام میدهد. بازبینی مستقل و داشتن یک برنامه انتشار امن (Safe-release plan) اجباری است.
- قانون ۲ (تاییدپذیری = ۱): ابتدا باید روش تایید (Checking Method) ساخته شود. عامل فقط مسئول تحقیق، بازتولید خطا و آمادهسازی تستهاست.
- قانون ۳ (قطعیت = ۱): کار در گامهای کوتاه اکتشافی پیش میرود. انسان بعد از هر گام، مسیر حرکت را تایید میکند.
- قانون ۴ (قطعیت/تاییدپذیری = ۲ و هزینه خطا ۱ یا ۲): تفویض یک مرحله محدود با نقطه بازرسی (Checkpoint) اجباری و بازبینی گسترده.
- قانون ۵ (قطعیت = ۳، تاییدپذیری = ۳، هزینه خطا = ۲): کار مشارکتی؛ عامل یک مرحله محدود را انجام میدهد و انسان نقاط بازرسی را تایید کرده و نتیجه را پس از بررسی مستقل میپذیرد.
- قانون ۶ (قطعیت = ۳، تاییدپذیری = ۳، هزینه خطا = ۱): اجرای خودگردان. عامل چرخه کامل را تا رسیدن به نتیجه آماده پذیرش انجام میدهد. انسان در نهایت شواهد و diff نهایی را بررسی میکند.
تعریف جریان کاری
برای عملیاتی کردن این حالتها، یک جریان کاری ششمرحلهای تعریف شده است:
۱. جمعآوری زمینه پروژه و یافتن نقاط متأثر.
۲. شفافسازی الزامات و محدودیتها.
۳. پیشنهاد طرح تغییر.
۴. تغییر کد، تستها، پیکربندی یا مستندات.
۵. اجرای تستها و رفع مشکلات یافت شده.
۶. پذیرش نتیجه و تایید برای ادغام یا انتشار.
در تفویض خودگردان، عامل مراحل ۱ تا ۵ را مدیریت میکند. در سایر حالتها، تیم بین «مشارکت گامکوتاه» (عامل بخش کوچکی را تغییر میدهد و انسان مسیر را چک میکند) یا «کمک تحضیری» (عامل اطلاعات و وابستگیها را جمعآوری میکند در حالی که انسان تصمیم میگیرد) انتخاب میکند. این تفکیک مانع از آن میشود که کارهای مقدماتی بهاشتباه بهعنوان تفویض خودگردان ثبت شوند.
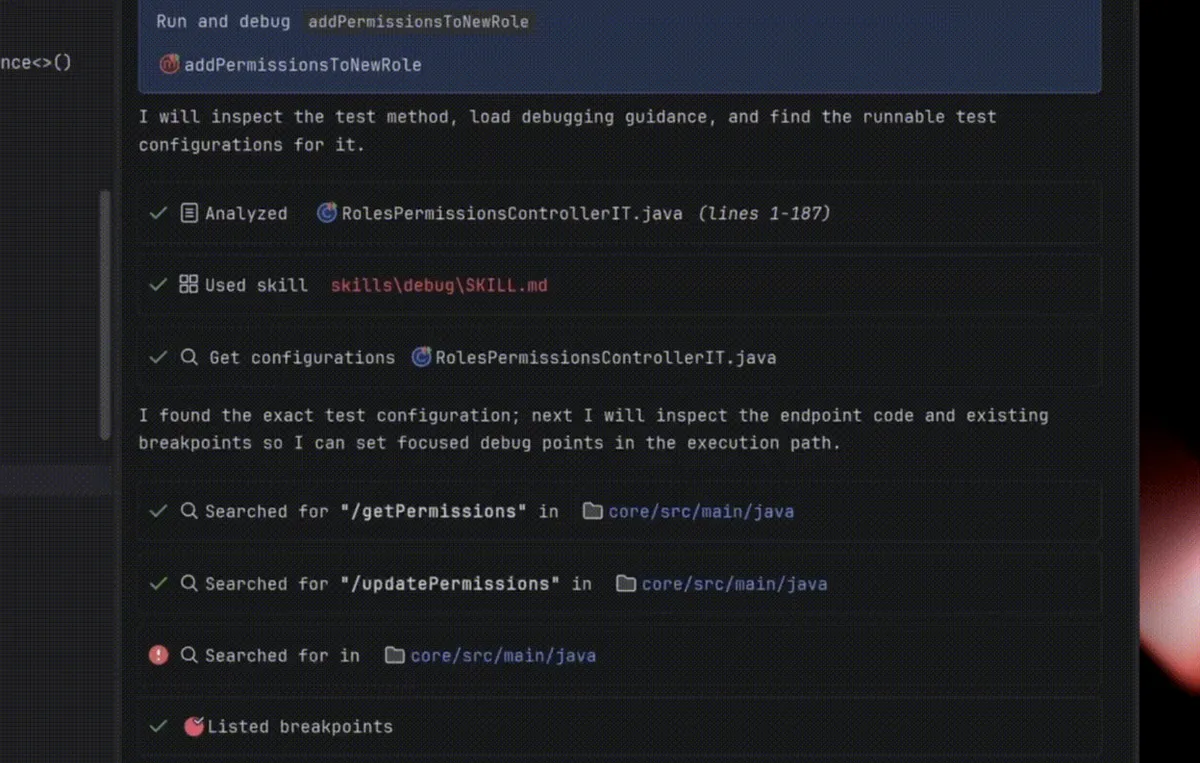
ادغام با هوش IDE
در پروژههایی که از JetBrains IDE استفاده میکنند، تاییدپذیری با مدلهای ساختاری کد تقویت میشود. ابزارهایی مثل Explyt فاکتهایی نظیر لینکهای نمادین (Symbol links)، پیکربندیهای اجرا، نتایج تست، پیامهای Inspection و وضعیت دیباگر را دریافت میکنند. عامل میتواند کاربردهای معنایی (Semantic usages) را حل کرده و عملیات IDE را فراخوانی کند.
با این حال، این چارچوب هشدار میدهد که فاکتهای IDE محدودند. کامپایل موفق تنها ناحیه بیلد را تایید میکند، نه معنای محصول را. یک تست سبز فقط سناریوی کدگذاری شده را تایید میکند. دیباگر تنها یک اجرای بازتولید شده را نشان میدهد، به این معنی که همچنان به یک مجموعه تست رگرسیون نیاز است. هر کارت تسک باید هر تاییدیه و محدودیت آن را نام ببرد؛ گزارشی که صرفاً میگوید «همه چیز پاس شد»، برای پذیرش نهایی ضعیف تلقی میشود.
اجرای یک پایلوت سختگیرانه
برای اثبات ارزش عاملها، پیشنهاد میشود پایلوتی بر اساس «زمان فعال توسعهدهنده» (Active Developer Time) اجرا شود، نه تعداد توکنها. این مقدار با مقایسه تسکهای کمکگرفته از AI در برابر یک خط پایه (Baseline) از تسکهای دستی مشابه در همان دستهبندی، ماژول و گروه پیچیدگی اندازهگیری میشود.
گامهای اجرای پایلوت:
- گام ۱: ساخت نمونه معرف. شامل ترکیبی از رفع خطا، ویژگیهای جدید، تستها، بازسازی کد (Refactoring) و مستندات با نسبتهای واقعبینانه. تعیین حداقل تعداد تکرار برای هر دسته ضروری است تا درصدها از روی مجموعههای کوچک و نادر استخراج نشوند.
- گام ۲: کالیبراسیون ارزیابان. دو ارزیاب بهطور مستقل به یک نمونه مشترک کوچک امتیاز میدهند. آنها سهم تطابق را محاسبه میکنند (توافق ارزیابان = کارتهای با ارزیابی یکسان / کل کارتها). پایلوت تنها پس از رسیدن به حد نصاب توافق تعریف شده آغاز میشود.
- گام ۳: تعیین مرزها. مشخص کردن دایرکتوریهای مجاز، ماژولها و دستورات مجاز. تعریف «شرایط توقف» (Stop Conditions) — مانند نیاز به تغییر در یک قرارداد عمومی یا کشف نیاز به مهاجرت دادهها — که بلافاصله کار خودگردان را متوقف میکند.
- گام ۴: ثبت معیار برآوردهنشده. برای رفع یک نقص، باید ابتدا شکست را قبل از اعمال پچ بازتولید کرد. برای یک ویژگی جدید، سناریویی اجرا شود که هنوز پاس نمیشود. این کار ثابت میکند که روش بررسی، حالتهای قبل و بعد از کار را تشخیص میدهد.
- گام ۵: اجرای تسک در حالت تعیینشده. اطمینان حاصل شود که تسکهای کمقطعیت به جلسات طولانی خودگردان تبدیل نشوند. تسکهای با هزینه خطای بالا نباید بدون بازبینی تعیینشده وارد مرحله Merge شوند.
- گام ۶: اندازهگیری چرخه کامل. زمان توصیف تسک، تعامل فعال، بررسی و اصلاحات دستی ثبت میشود. زمان فعال توسعهدهنده = توصیف تسک + تعامل فعال + بررسی + اصلاحات دستی + بازیابی بعد از نقصها. زمان ماشین در حالت خودگردان بهطور جداگانه ذخیره میشود.
- گام ۷: بازبینی مستقل شواهد. توسعهدهنده معیار برآوردهنشده اولیه، diff نهایی و دامنه تستها را بررسی میکند. عبارت «تسک تکمیل شد» توسط عامل، تاییدیه نیست.
- گام ۸: مقایسه با خط پایه. مقایسه اصلاحات محلی با اصلاحات محلی و غیره. استفاده از میانه (Median) برای زمان فعال توسعهدهنده و گزارش سهم نتایجی که بدون بازسازی اساسی پذیرفته شدهاند.
- گام ۹: تحلیل خطاهای پیشبینی. شناسایی اینکه چرا یک تسک «مناسب» باعث ایجاد کار بیشتر شد (مثلاً به دلیل الزامات ضمنی) یا چرا یک تسک «نامناسب» موفق بود (مثلاً یک آرتیفکت خاص عدم قطعیت را کاهش داد).
اندازهگیری «سهم تایید شده»
موفقیت با یک درصد کلی از تسکهای انجام شده اندازهگیری نمیشود، بلکه از چهار شاخص مجزا برای «تسکهای واجد شرایط» (آنهایی که حداقل تعداد مشاهده را دارند) استفاده میشود:
۱. سهم پیشبینی (Forecast Share): تسکهای واجد شرایط که تحت قانون ۶ ماتریس قرار میگیرند تقسیم بر کل تسکهای ارزیابی شده واجد شرایط. این شاخص پتانسیل را بر اساس کارتها قبل از اجرا نشان میدهد.
۲. سهم تایید شده (Confirmed Share): تسکهای پذیرفته شده در حالت خودگردان (که زمان فعال آنها کمتر از خط پایه بوده و نقص ردکننده رخ نداده است) تقسیم بر کل تسکهای پایلوت واجد شرایط. نقص ردکننده میتواند یک Rollback یا نادیده گرفتن یک بررسی اجباری باشد.
۳. سهم کار مشارکتی (Collaborative-Work Share): تسکهای پذیرفته شده از قوانین ۳، ۴ و ۵ (با کاهش زمان فعال و بدون بازسازی اساسی) تقسیم بر کل تسکهای پایلوت واجد شرایط.
۴. سهم وزنی بر اساس تلاش (Effort-Weighted Share): مجموع زمان انسانی خط پایه برای تسکهای تایید شده تقسیم بر مجموع زمان انسانی خط پایه برای تمام تسکهای نمونه واجد شرایط. این کار مانع میشود که اصلاحات کوچک، شکست در ادغامهای پیچیده و طولانی را بپوشانند.
متریکهای داشبورد
برای نظارت مستمر، هشت گروه شاخص پیشنهاد شده است:
- پوشش (Coverage): توزیع تسکها بر اساس دستهبندی.
- حالتها (Modes): سهم پیشبینی خودگردان در مقابل سهم تایید شده خودگردان و مشارکتی.
- پذیرش (Acceptance): سهم نتایجی که بدون بازسازی اساسی پذیرفته شدهاند.
- زمان انسانی (Human Time): میانه زمان فعال نسبت به خط پایه.
- بررسی (Checking): میانه زمان بازبینی و لیست بررسیهای نادیده گرفته شده.
- تلاش مجدد (Retries): تعداد اجراهای مجدد مورد نیاز قبل از پذیرش.
- کیفیت (Quality): نقصهای یافت شده قبل از ادغام، نقصهای بعد از ادغام و حوادث (Incidents).
- اقتصاد (Economics): هزینه مدل به ازای هر تسک پذیرفته شده و به ازای هر ساعت ذخیره شده از زمان فعال.
این تغییر رویکرد، هوش مصنوعی را از یک «ابزار جادویی» به یک منبع مدیریتشده تبدیل میکند. با تبدیل تفویض به یک مسئله مدیریت ریسک، تیمها میتوانند بدون به خطر انداختن پایداری سیستم، دامنه کارهای خودگردان را گسترش دهند.
گام بعدی شما
- ۱۰ تسک آخر تکمیل شده در تیم خود را لیست کنید و آنها را بر اساس ماتریس قطعیت-تاییدپذیری-هزینه امتیازدهی کنید.
- بررسی کنید چند درصد از این تسکها واقعاً صلاحیت اجرای خودگردان (قانون ۶) را داشتند و کجاها ریسک پذیرفته شده است.
- برای تسکهای بعدی، ابتدا «معیار پذیرش مستقل» (تست شکستخورده) را ثبت کنید و سپس آن را به عامل بسپارید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو