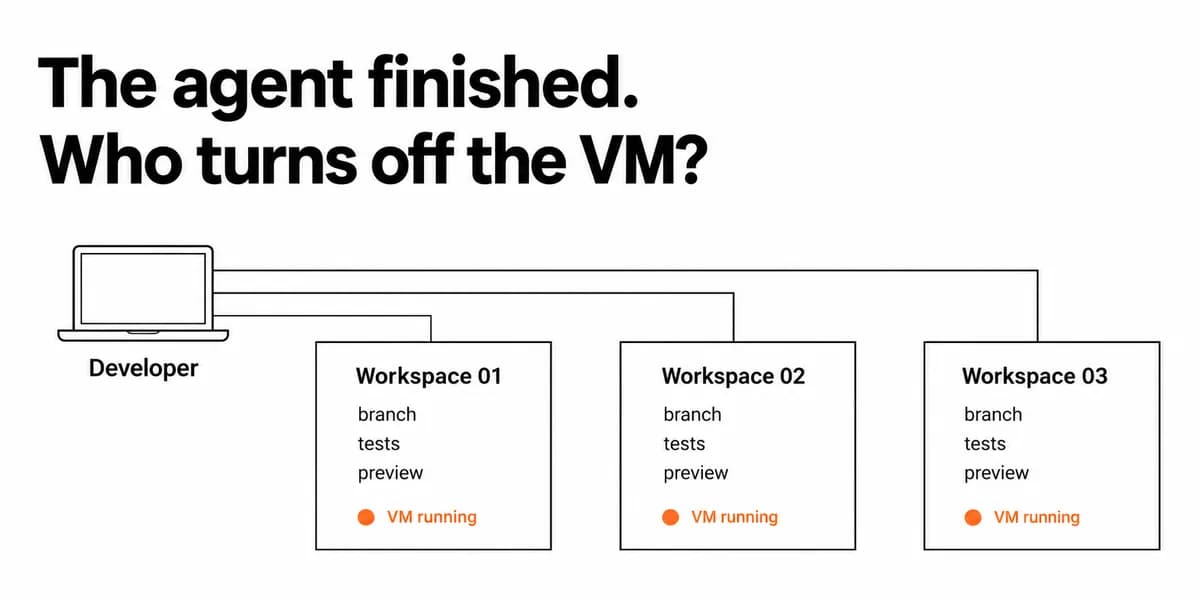
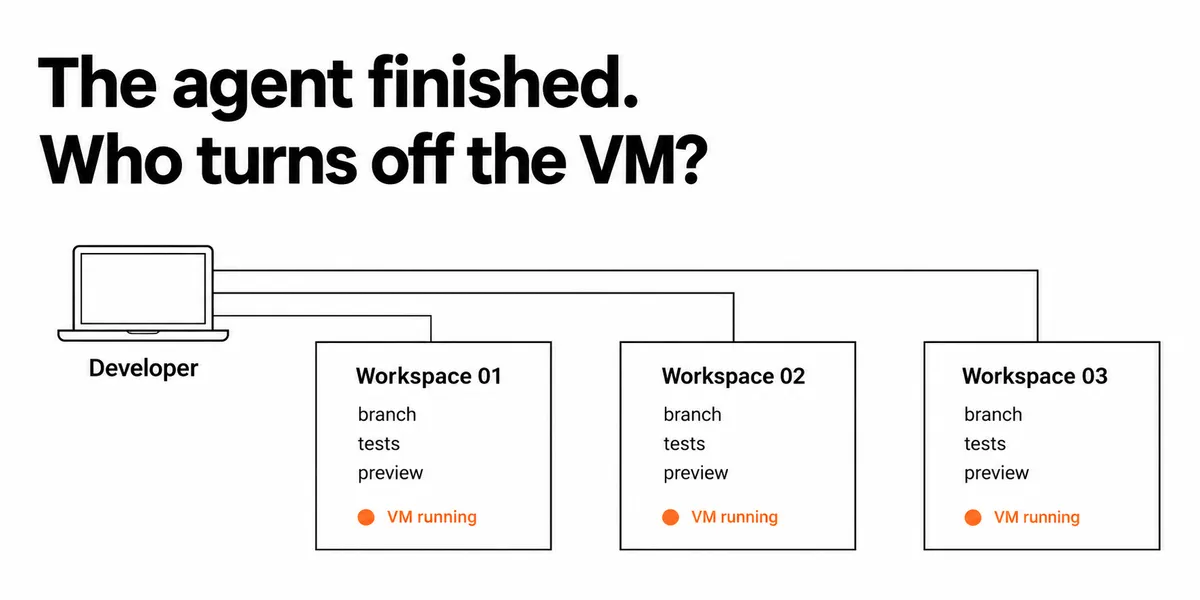
تصور کنید یک عامل کدنویس ساعت ۶ عصر یک Pull Request را نهایی میکند، اما نمونهٔ AWS EC2 که برای این کار ساخته شده، تمام شب فعال میماند و هزینهها را بدون نظارت هیچ انسانی بالا میبرد. این مشکل «ماشینهای شبانه» به این دلیل رخ میدهد که عاملها معمولاً سیگنال قطعی برای تخریب زیرساخت خود پس از اتمام منطقیِ وظیفه ندارند. ماشین ممکن است صرفاً به این دلیل در حالت بیکاری (Idle) بماند که کسی به آن دستور توقف نداده است، یا شاید هنوز در حال ارائه یک پیشنمایش برای بازبینیکنندهای باشد که مدتهاست از سیستم خارج شده است.
مدیریت این محیطها نیازمند تغییر نگاه ما به چرخهٔ حیات عاملها است. اکثر توسعهدهندگان پایان کار عامل را نقطهٔ پایانی میبینند، اما در یک فضای کاری دورکار — شبیه به آنچه در آموزشهای Coder دیدیم — زیرساخت چرخهٔ حیات مستقلی دارد. اگر عامل تنها موجودی باشد که میتواند دستور خاموشی صادر کند، هرگونه کرش یا حلقهٔ تکرار، ماشین مجازی را برای همیشه زنده نگه میدارد. همانطور که در تحلیلهای قبلی ما دربارهی مدیریت منابع در سیستمهای عاملمحور اشاره کردیم، جداسازی لایهٔ اجرا از لایهٔ نظارت تنها راه جلوگیری از اتلاف بودجه است. در واقع، برای پایداری این زیرساختها، باید سیستمهای خودترمیمشوندهای طراحی کرد که توقفات ناگهانی عاملها را به حداقل برسانند تا چرخهٔ حیات ماشینها به درستی مدیریت شود.
سه لایه کنترل
برای حل این بحران، باید سه لایه کنترل مجزا پیاده کنید. محدودیت در یک لایه، لزوماً لایههای دیگر را کنترل نمیکند؛ برای مثال، یک تایماوت در سطح تست، فقط همان تست را پوشش میدهد و لزوماً جلسهٔ (Session) کلی عامل را نمیبندد.
اول، سطح دستورات باید یک محدودیت سخت داشته باشد. برای یک پروژه Node.js، استفاده از GNU timeout میتواند یک فرآیند را پس از مدتی مشخص مجبور به خروج کند. طبق مستندات GNU، یک اسکریپت حفاظتی میتواند به این شکل باشد:
#!/usr/bin/env bash set -u if timeout --kill-after=30s 10m npm test >test.log 2>&1; then printf 'Tests passed. Output: test.log\n' else status=$? printf 'Tests failed or timed out (exit %s). Output: test.log\n' "$status" >&2 exit "$status" fi
در این ساختار، دستور ۱۰ دقیقه فرصت دارد تا به پایان برسد. اگر ۳۰ ثانیه پس از ارسال سیگنال پایان، فرآیند هنوز فعال باشد، یک سیگنال Kill ارسال میشود. طبق مستندات GNU، یک تایماوت معمولی معمولاً کد خروجی ۱۲۴ را برمیگرداند، در حالی که یک کشتن اجباری (Forced Kill) میتواند کد ۱۳۷ را بازگرداند.
دوم، جلسهٔ عامل به یک «بودجهٔ تلاش مجدد» (Retry Budget) مجزا نیاز دارد. در حالی که تایماوت در سطح اسکریپت، شکستهای تکی را مدیریت میکند، یک ناظر (Supervisor) باید یک ضربالاجل جهانی (Global Deadline) برای کل وظیفه تعیین کند. این کار مانع از آن میشود که عامل در حلقهٔ بیپایان «اصلاح-تست-شکست» گیر کند؛ جایی که هر تلاش تکی محدود است، اما کل وظیفه به صورت کلی تا ابد ادامه مییابد. برای جلوگیری از قطع ارتباطات حیاتی در این جلسات، میتوان از مکانیزمهای اجارهٔ دسترسی برای حفظ پیوستگی ارتباط عاملها استفاده کرد.
سوم، خودِ فضای کاری باید تایمر عدم فعالیت داشته باشد. بر اساس مستندات زمانبندی Coder، عاملهای فعال میتوانند ضربالاجل خاموشی را تمدید کنند تا وقفه ایجاد نشود. اما این یعنی یک عامل گیرکرده میتواند به طور مؤثری با ارسال سیگنالهای ضربان قلب (Heartbeat)، ماشین مجازی را برای همیشه آنلاین نگه دارد. یک سیاست سختگیرانه باید جلسه را بلافاصله پس از تحویل نتیجه ببندد و یک زمان انقضای صریح برای پیشنمایش تعیین کند.
حفظ شواهد پیش از پاکسازی
خاموش کردن ماشین مجازی زمانی خطرناک است که تنها نسخهٔ کد یا لاگها روی همان ماشین باشد. برای جلوگیری از دست رفتن دادهها، از Git worktrees برای جداسازی وظایف عامل استفاده کنید. این روش به شما اجازه میدهد:
- برای هر وظیفه یک دایرکتوری مجزا با استفاده از دستور
git worktree add -b "agent/${task_id}" "$task_dir" HEADبسازید (مثلاًagent-issue-142). - دادههای مخزن را به اشتراک بگذارید اما فایلهای کاری را ایزوله کنید، هرچند این روش اعتبارنامهها (Credentials) یا منابع ابری را ایزوله نمیکند.
- کامیتها را بهصورت دوردست (Remote) حفظ کرده و نتایج تست، شامل دستور اجرا شده و هرگونه شکست، را به Pull Request پیوست کنید.
- پیش از اجرای
git worktree removeتأیید کنید که کامیتها حتماً Push شدهاند.
بدون پرچم --force، گیت از حذف شاخههایی که تغییرات ثبتنشده یا فایلهای ردیابینشده — مانند test.log — دارند، خودداری میکند. پاکسازی زیرساخت باید گامی مجزا از پایان جلسه باشد. طبق مستندات EC2، متوقف کردن (Stopping) یک نمونه با تخریب (Terminating) آن متفاوت است؛ برای توقف کامل صورتحساب برای آن منبع، تخریب الزامی است. در کنار این نظارتهای زیرساختی، تحلیل ترافیک شبکه میتواند لایهی تکمیلی برای شناسایی فعالیتهای پنهان عاملها پیش از تخریب ماشین باشد.
این رویکرد، فرض بنیادین استقرار عاملها را از «پرتاب و فراموشی» به «چرخهٔ حیات نظارتشده» تغییر میدهد. با جداسازی دستور، جلسه و ماشین مجازی، تضمین میکنید که یک عامل شکستخورده به یک ردیف دائمی در صورتحساب ابری شما تبدیل نشود.
برای کسانی که این سیستم را در ۸ اکتبر ۲۰۲۶ پیاده میکنند، هدف این است که لپتاپ خود را ببندید و دقیقاً بدانید چرا یک منبع فردا هنوز در حال اجراست. مطمئنترین راه تست این است که عمداً وظیفهای اجرا کنید که نمیتواند به پایان برسد و بررسی کنید آیا ضربالاجل واقعاً باعث خاموشی میشود یا خیر. این آزمایش را با یک وظیفه موفق نیز تکرار کنید، در حالی که بازبینیکننده تا روز بعد در دسترس نیست، تا مطمئن شوید پیشنمایش برای بازه زمانی وعده داده شده در دسترس میماند، بدون اینکه عامل به کار خود ادامه دهد.
مراقب ارائهدهندگان ابری «عاملمحور» (Agent-native) نوظهور باشید که ممکن است این قلابهای چرخهٔ حیات را مستقیماً در API خود ادغام کنند و نیاز به اسکریپتهای دستی Bash را از بین ببرند.
گام بعدی شما
- پیادهسازی لایهٔ GNU timeout برای تمام اسکریپتهای تست عاملها.
- جایگزینی متد حذف دایرکتوریهای موقت با Git worktrees برای حفظ لاگها.
- بررسی تنظیمات Heartbeat در پنل ابری برای جلوگیری از تمدید خودکار ماشینهای مجازی.



گفتگو