تصور کنید OpenAI Codex تمام سهمیه API شما را میبلعد بدون اینکه حتی یک خط کد سالم تولید کند. وقتی یک عامل (Agent) — شبیه کارآموزی که بدون فکر کردن، یک دستور اشتباه را صد بار تکرار میکند — بدون هیچ فرضیه جدیدی یک فرمان شکستخورده را اجرا میکند، با نقص مدل روبرو نیستید، بلکه با شکست در گردشکار مواجه شدهاید که منجر به ایجاد حلقههای تست بینهایت شده است. این موضوع تایید میکند که بسیاری از شکستهای سامانههای هوش مصنوعی ریشه در نقص فرآیندها دارند تا محدودیتهای ذاتی مدلها.
توسعهدهندگان معمولاً زمانی با این مشکل روبرو میشوند که دستورات بیش از حد مبهم باشند؛ مثلاً وقتی از هوش مصنوعی میخواهند «اپلیکیشن را مقاوم (Robust) کن». این هدف باز و نامحدود، عامل را دعوت میکند تا برنامه تست را بهطور نامحدود گسترش دهد. به نقل از راهنمایی که در ۱۷ سپتامبر ۲۰۲۶ منتشر شد، راهکار این مشکل در تغییر رویکرد از «اهداف کلی» به «نتایج مشاهدهپذیر» نهفته است.
همانطور که در تحلیلهای قبلی ما دربارهی مدیریت توکنها و بهینهسازی استنتاج اشاره کردیم، هر تکرار بیهدف در محیطهای عاملمحور، هزینهای مستقیم بر روی کیف پول توسعهدهنده دارد.
درک مکانیسم حلقه
برای شکستن یک حلقه، باید فرآیند را متوقف کرده و آخرین تغییرات (Diff) را بررسی کنید. باید بسنجید که آیا عامل واقعاً کد را تغییر داده یا صرفاً یک خطای محیطی را با باگ کد اشتباه گرفته است. پیش از تغییر مدل، آخرین دستور و نتیجه آن را بررسی کنید تا بفهمید آیا فرآیند هنوز خروجی تولید میکند یا در انتظار یک درخواست شبکه، دریافت مجوز یا اجرای یک مجموعه تست بهطور غیرمعمول بزرگ است. اگر تست شکستخورده با کد بدون تغییر تکرار شد، پیش از اجازه برای اجرای مجدد، از مدل بخواهید یک فرضیه جدید و مشخص ارائه دهد. برای تحلیل دقیقتر این رفتارها، تغییر رویکرد از لاگهای متنی به کارتهای اجرا (Run Cards) در دیباگینگ عاملها توصیه میشود.
تشخیص و مشاهده
بر اساس مستندات منتشر شده، هنگام تشخیص یک حلقه، باید خطاها را در دستههای زیر قرار داد تا گام بعدی مشخص شود:
- عدم خروجی از دستور در حال اجرا: بررسی وضعیت فرآیند و وابستگیهای خارجی.
- شکست جدید پس از تغییر واقعی: بررسی رگرسیون؛ در این حالت اجرای مجدد تست توجیهپذیر است.
- توقف به دلیل محدودیت مصرف: بررسی بازه زمانی واقعی محدودیت (Limit Window) پیش از تحلیل کد.
- گسترش بیرویه برنامه تست توسط عامل: بازنویسی خروجی مورد نیاز و تعیین محدوده (Scope) دقیق.
استراتژیهای پیشگیری از حلقه
برای پیشگیری از این حلقهها، استراتژیهای زیر توصیه میشود:
- تعیین خط پایان: درخواستهای مبهم را با معیارهای پذیرش (Acceptance Criteria) جایگزین کنید. بهجای «اصلاح جستوجو»، بگویید «جلوگیری از خطای جستوجوی خالی و تایید هر دو مسیر خالی و غیرخالی».
- اجرای مبتنی بر فرضیه: به عامل دستور دهید پیش از ویرایش، کوچکترین بررسی پذیرش مرتبط را نام ببرد. تکرار تست تنها پس از یک تغییر معنادار یا زمانی که یک شکست جدید دلیل تغییر را توضیح دهد، مجاز است. اگر همان شکست بدون فرضیه جدید تکرار شد، فرآیند را متوقف و گزارش کنید. در این راستا، پروتکلهای سختگیرانهتری مانند متد سه-مرحلهای MonkeyCode میتوانند مانع از تکرار باگهای پنهان شوند.
- حفظ نقاط بازرسی (Checkpoint): برای فرار از حلقه، درخت کاری (Working Tree) را دور نریزید. ابتدا یک نقطه بازرسی ذخیره کنید تا در صورت شروع مجدد، کارهای قبلی تکرار نشوند. راهنمای بازنشانی Codex اشاره میکند که حلقه تست و سهمیه هفتگی، دو مشکل کاملاً مجزا هستند.
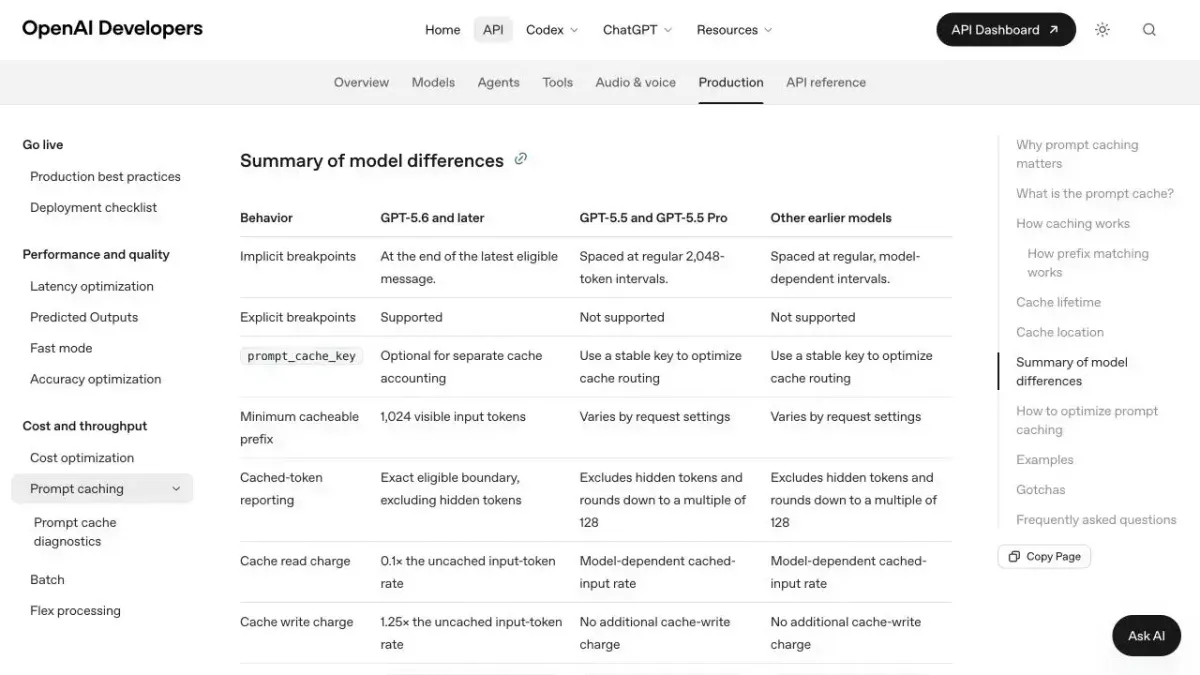
مدیریت هزینهها مستلزم تفکیک نرخهای مختلف API است. طبق گزارش مستندات رسمی OpenAI در ۱۶ سپتامبر ۲۰۲۶، خواندن از حافظه پنهک (Cache) و ورودیهای بدون کش، ساختارهای قیمتگذاری متفاوتی دارند. تعداد بالای توکن (Token) — تکههای کوچکی از متن که مدل تکهتکه میخورد — همیشه به معنای گران بودن تسک نیست و ممکن است صرفاً نتیجه نحوه مدیریت کش در API باشد.
برای کارهای مربوط به API، راهنمای رسمی کش توضیح میدهد که چرا دستههای ورودی باید از هم جدا شوند. توجه داشته باشید که محدودیت اشتراک ChatGPT با صورتحساب API یکسان نیست؛ برای درک نحوه مصرف طرحها به راهنمای قیمتگذاری Codex در OpenAI مراجعه کنید.
این تغییر رویکرد، نقش توسعهدهنده را از یک ناظر غیرفعال به یک بازبین فعال تبدیل میکند. شما دیگر فقط برای دریافت نتیجه پرامپت نمینویسید، بلکه منطق اعتبارسنجی عامل را مدیریت میکنید. با متصل کردن هر اجرای تست به یک تغییر مشخص، مانع از ممیزیهای گسترده و غیرضروری مدل میشوید.
برای مقایسه مدلها، توصیه میشود از مقایسه Astra در برابر Sol برای هزینههای هر ارائهدهنده استفاده کنید. هرگز برتری یک مدل را بر اساس یک اجرای «خوششانس» قضاوت نکنید؛ بلکه از یک اسنپشات یکسان از مخزن کد شروع کرده و مجوزهای مشابه بدهید. زمان سپری شده، نتایج پذیرش، تعمیرات دستی و هرگونه تلاش مجدد هزینهبر را ثبت کنید تا به مقایسهای دقیق برسید.
اگر دستوری به دلیل مجوزهای محیطی مسدود شد، آن را جدا از تستهای شکستخورده گزارش کنید. هرگز از عامل نخواهید که حفاظهای امنیتی را دور بزند یا نتیجهای جعلی برای پایان سریعتر کار بسازد، زیرا این کار منجر به ایجاد بدهی فنی و ریسکهای امنیتی میشود.
مراقب دستورات متداخل در راهنمای پروژه و مجموعه مهارتها (Skill sets) باشید. یک دستور ممکن است اصلاح محدود را بخواهد، در حالی که دستور دیگر بهطور ضمنی تسک را به یک ممیزی کامل تبدیل کند و دقیقاً همان حلقههایی را ایجاد کند که سعی در اجتناب از آنها دارید. شفاف کنید که کدام بررسیها برای تغییر فعلی ضروری هستند و کدام موارد به عنوان کارهای آینده تعیین شدهاند.
گام بعدی شما
- تمام پرامپتهای «بهبود» یا «اصلاح» را به «معیارهای پذیرش مشاهدهپذیر» تبدیل کنید.
- پیش از هر اجرای مجدد تست توسط عامل، درخواست یک «فرضیه تغییر» (Change Hypothesis) کنید.
- سیستم ذخیره خودکار نقاط بازرسی را در گردشکار توسعه با Codex ادغام کنید.
اما مدیریت این هزینهها در مقیاس سازمانی پیچیدهتر است — به تحلیل ما درباره استراتژیهای کاهش هزینه استنتاج در مدلهای پیشرو مراجعه کنید.



گفتگو