لحن منحصربهفرد شما در نویسندگی دقیقاً از همان لحظهای از بین میرود که اجازه میدهید یک مدل زبانی عبارت «بهتری» را به شما پیشنهاد کند. اکثر نویسندگان با مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — مانند یک نویسندهٔ سایه برخورد میکنند، اما این رویکرد متن را به «دره وهمی» میبرد؛ جایی که نوشته بیشتر شبیه به یک خروجی ماشینی است تا یک بیان انسانی.
نوشتن دربارهی نویسندگی ذاتاً دشوار است. این کار میتواند بهراحتی شبیه به خودستایی به نظر برسد و این implication را داشته باشد که نویسنده لزوماً خوب مینویسد. در واقعیت، تقریباً به طور قطع گروهی از منتقدان در اینترنت وجود دارند که معتقدند شما در نوشتن افتضار هستید. این ناامنی بخشی جهانی از فرآیند نویسندگی است، اما ریسک استفاده از LLMها این است که خوانندگان میتوانند کلمات تولیدشده توسط هوش مصنوعی را حتی در مقیاس «بخش در تریلیون» تشخیص دهند. هر چقدر هم سعی کنید متن را انسانی کنید یا لبههای آن را بتراشید، یک پاراگراف تولیدشده توسط مدل برای مخاطب نه به عنوان «نوشته»، بلکه به عنوان «خروجی» ثبت میشود.
ما اکنون با پدیدهای به نام «خزش مدلهای زبانی» (LLM-creep) روبرو هستیم؛ وضعیتی که در آن مدلهای پیشرو بهطور پیشفرض سبکی شبیه به تیترهای مجلات را انتخاب میکنند که صیقلخورده اما توخالی است. این تغییر، بازتابی از نگرانیهای گستردهتر دربارهی اصالت محتواست؛ مشابه همان اتفاقی که در مورد نشانگذاری متنی (text watermarking) رخ میدهد و میتواند بهطور ناخواسته رفتار مدل را تغییر دهد، همانطور که در پوشش پیشین ما از مطالعهی Lasso دیدیم.
برای مقابله با این وضعیت، در ۱۷ سپتامبر ۲۰۲۶، متدولوژی عملی جدیدی در وبسایت sockpuppet.org منتشر شد که یک سیستم سختگیرانه با دو قانون را پیشنهاد میدهد. هدف این است که از هوش مصنوعی برای کارهای مکانیکی ویراستاری استفاده شود، بدون اینکه اجازه دهیم متن را «پاستوریزه» کند یا آن را با «شربت ذرت» (کلیشههای شیرین اما بیمحتوا) پر کند.
قانون اول: ممنوعیت کلمات
اولین و حیاتیترین قانون مطلق است: شما نباید حتی از یک کلمه یا عبارت پیشنهادی مدل استفاده کنید. شکستن این قانون دقیقاً همان جایی است که نویسنده دچار مشکل میشود. مدلهای پیشرو در انتخاب عبارتهای خوشآهنگ فوقالعادهاند؛ در واقع، تمام هدف طراحی آنها همین است.
مشکل اینجاست که مدلهای پیشرو در حالتی قرار دارند که هر چه مینویسند شبیه تیتر مجله است. در حالی که تیترها برای هدف خاص خود مؤثرند، مقالهای که از دهها تیتر تشکیل شده باشد، آزاردهنده و ناهماهنگ است. برای جلوگیری از این اتفاق، نویسنده پیشنهاد میکند از این قانون به عنوان یک نوع «تجهیزات حفاظتی فکری» (intellectual PPE) استفاده کنید.
حتی اگر یک عبارت پیشنهادی بهطور عینی بهتر به نظر برسد، باید رد شود. فرض بر این است که انسانها نمیتوانند تمام نشانههای ظریف متون تولیدشده توسط هوش مصنوعی را تشخیص دهند — همان روشهایی که مدلها نوشته را به «پنیر ولویتا» (یک محصول صنعتی و یکدست) تبدیل میکنند — اما خوانندگان این الگوها را در مقیاس «بخش در تریلیون» حس میکنند.
قانون دوم: ممنوعیت تشویق
مدلهای زبانی از طریق «کمپینهای نفوذ» نیز به نوشتهها آسیب میزنند. این مشکل ظریفتر از انتخاب کلمات است اما به همان اندازه مخرب است. وقتی متنی را به مدل میدهید، معمولاً با تعریف و تمجید پاسخ میدهد و به نویسنده میگوید: «این طلاست، جری!» (اشاره به تایید بیچون و چرای مدل).
این بازخورد خطرناک است زیرا پیشنویسهای اول معمولاً نقص دارند. اکثر پاراگرافها ضعیفاند، جریان موضوعی اغلب نامنظم است و معمولاً حداقل ۷۵۰ کلمه وجود دارد که اصلاً مورد نیاز نیستند. وقتی مدل ساختار کلی، انتقالها (transitions) یا ارجاعات فرهنگی عامه را تشویق میکند، در واقع تکانههای اشتباه نویسنده را تأیید و اعتبار میبخشد.
خطر حلقهی بازخورد
اگر به تعریفهای هوش مصنوعی گوش دهید، روی اشتباهات پیشنویس اول خود پافشاری میکنید. در حالت عادی، نویسنده ویراستاری میکند، بازاندیشی میکند و پاراگرافها را جایگزین میکند. این لحظات بازاندیشی، «بخشهای تحملکنندهٔ بار» (load-bearing parts) در صدای یک نویسنده هستند. بدون آنها، نوشته طعمی مصنوعی میگیرد و خواننده هرچند نتواند دقیقاً انگشت بگذارد روی اینکه چه چیزی اشتباه است، فقدان اصالت را حس میکند.
به نقل از نویسنده، او پیشتر سعی کرده بود با دروغ گفتن به مدل (ادعای اینکه ویراستار یک نشریه آنلاین است که مقالات را برای پذیرش بررسی میکند) این مشکل را حل کند. اما مدل اغلب در این مسیر زیادهروی کرد و دچار بیشبرازش (Overfitting) شد — شبیه به دانشآموزی که فقط جوابهای امتحان را حفظ کرده و نمیتواند آنها را تحلیل کند — و بیش از حد روی اهداف احتمالی آن نشریه متمرکز گشت. بهترین توصیه عملی این است که صراحتاً مدل را از تشویق کردن منع کنید و نسبت به هرگونه تمجیدی که ارائه میدهد، فوقالعاده هوشیار بمانید.
هوش مصنوعی به عنوان ابزار مکانیکی
اگرچه مدلها نباید بنویسند، اما در شناسایی مشکلات فوقالعادهاند. آنها برخلاف ویراستاران انسانی، از کارهای خستهکننده و ملالآوری که ویراستاران را فرسوده میکند، خسته نمیشوند. بهطور مشخص، مدلها در شناسایی موارد زیر برتری دارند:
- حالت مجهول: شناسایی جاهایی که بیش از حد (یا کمتر از حد لازم) از ساختارهای مجهول استفاده شده است.
- مشکلات فعلی: شناسایی افعالی که به اسم تبدیل شدهاند (nominalized verbs) یا جاهایی که کنش اصلی در متن دفن شده است.
- تکرار: یافتن عبارتها یا انتخابهای کلامی تکراری.
- کلمات پرکننده: شناسایی کلماتی مثل «خیلی»، «متأسفانه»، «واقعاً» و «در حقیقت» که مثل «خاکاره روی میز کار» در سراسر پیشنویس پخش شدهاند.
- شفافیت ساختاری: شناسایی ۲ یا ۳ پاراگراف که با جابهجایی به جای دیگر، کیفیت متن را فوراً بهبود میبخشند.
پیادهسازی گردش کار فنی
برای کسانی که به دنبال رویکردی سیستماتیک هستند، مطالعه کتاب «Style: Lessons In Clarity And Grace» توصیه میشود. برای یک برنامهنویس، این کتاب مانند یک نقشه (schematic) برای ویرایش است، مشابه همان کاری که کتاب «C Interfaces And Implementations» اثر هانسون برای زبان C انجام میدهد. نویسنده ادعا میکند این روش، ویراستاری را شبیه به کدنویسی جاوا میکند: همان اندازه خستهکننده، اما همان اندازه مؤثر. این رویکرد به نوعی تقابل میان سرعت در اجرا و عمق درک فنی است، موضوعی که در بررسی ما دربارهی فرسایش مهارتهای مهندسان نرمافزار به دلیل اتکای بیش از حد به LLMها به آن پرداختیم.
با استفاده از این اصول، نویسنده میتواند لیستی از پرامپتها را برای بررسیهای متوالی روی سند اجرا کند. برای جلوگیری از تلهٔ «تشویق» در بازنویسیها، یک گردش کار مجزا (decoupled workflow) پیشنهاد میشود:
۱. از مدل بخواهید مشکلات را شناسایی کند.
۲. پاراگراف یا بخش را خودتان بازنویسی کنید.
۳. نسخه اصلی و جدید را به یک نمونهٔ مجزا (instance) از مدل ارائه دهید.
این کار ضروری است زیرا مدلی که بداند شما چیزی را بازنویسی کردهاید، احتمالاً نسخه جدید را بهتر میداند، صرفاً چون میخواهد شما این را بشنوید. استفاده از مدلی بدون پیشزمینه از فرآیند ویرایش، نظری بیطرفانه را تضمین میکند.
ساخت ابزار کارگاه شخصی
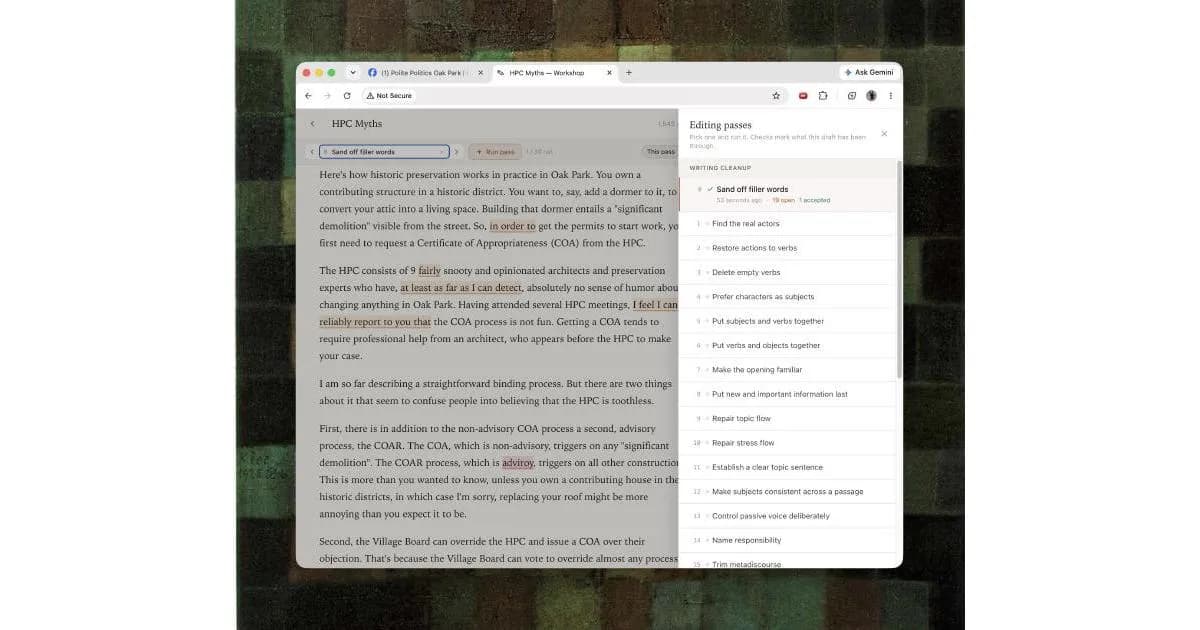
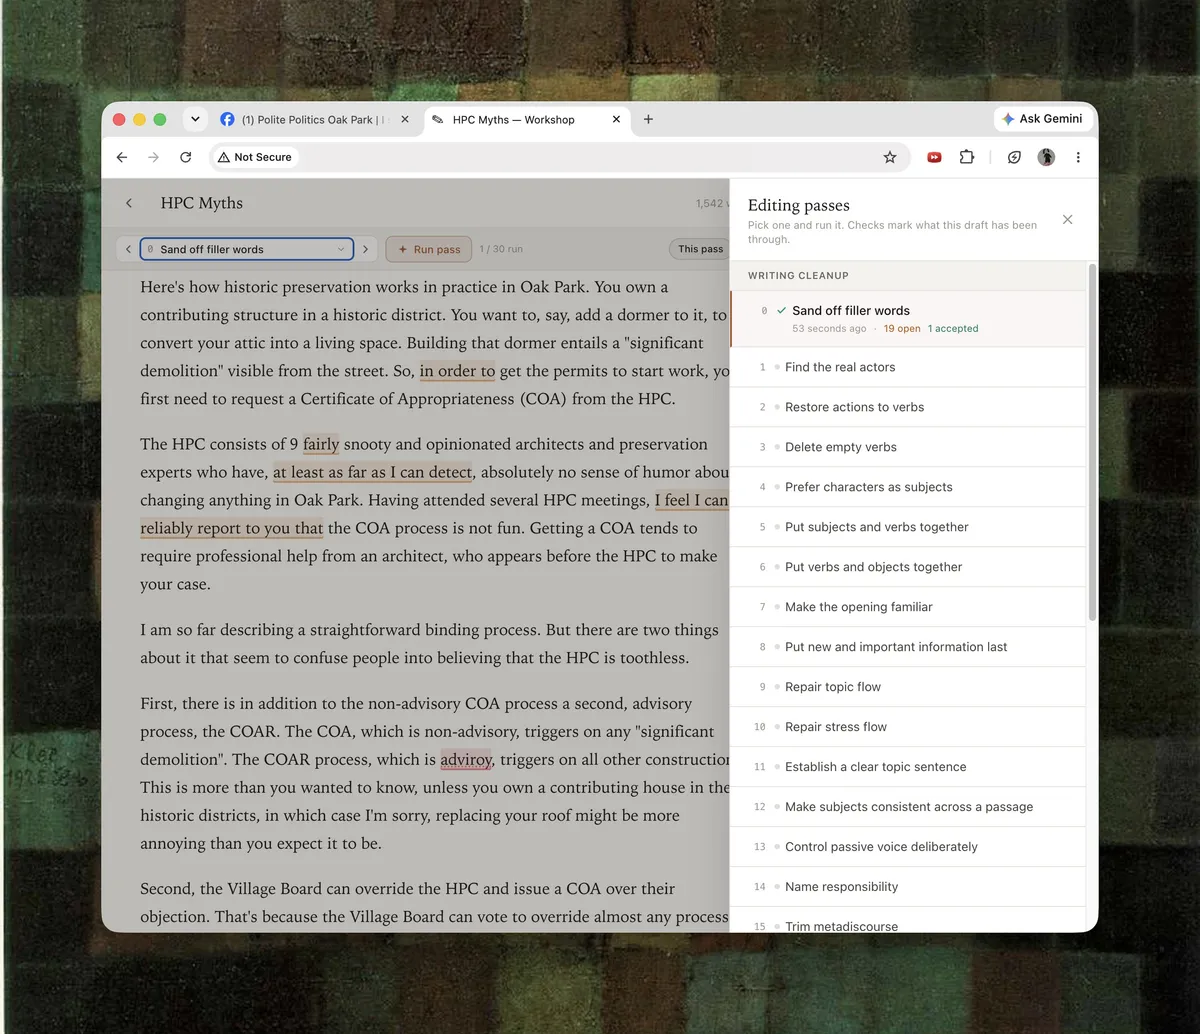
کاربران پیشرفته میتوانند این فرآیند را برای جلوگیری از جابهجایی بین تبهای مرورگر، خودکار کنند. نویسنده ابزاری با این ساختار فنی ساخته است:
- بکاند: پایتون و SQLite.
- فرانتاند: Tailwind (نسخه بیلد محلی، نه CDN) و HTMX برای تعاملات.
- رابط کاربری: ویرایشگری شبیه Notion با قابلیت هایلایت برای مراحل ویرایش و کامنتهای کناری شبیه به Genius.
- عملکرد: قابلیت پیمایش (tick forward and back) بین پیشنهادات، ردیابی بازبینیها در چندین سند و علامتگذاری تغییرات کلی.
این ابزار پرامپتهای ویراستاری را از طریق رابطهای خط فرمان (CLI) مدلهای Codex، Claude یا Antigravity اجرا میکند. نویسنده اشاره میکند که هر راهکار شخصیسازیشدهای که کاربر برای خود بسازد، به دلیل متناسب بودن با نیازهای خاص او، بهتر از ابزارهای عمومی خواهد بود. این تمایل به ساخت ابزارهای تخصصی به جای استفاده از رابطهای چت ساده، یادآور آن است که چگونه مدلهای زبانی در نقشهای تخصصیتر مانند مترجم سختافزار بسیار موفقتر از نقش یک چتبات عمومی عمل میکنند.
این رویکرد نقش هوش مصنوعی را از یک «خالق» به یک «ابزار تشخیص» تغییر میدهد. با برونسپاری خستهکنندهترین بخشهای ویراستاری، صدای نویسنده حفظ شده و سرعت تولید افزایش مییابد.
در نهایت، انسان باید تصمیمگیرنده نهایی باشد. حتی وقتی مدلی مثل GPT-5 پیشنهاد میکند که متن ۲۰٪ طولانیتر از حد لازم است، تصمیم برای نگه داشتن آن بخشها، مسئلهای مربوط به هویت و صدای نویسنده است، نه بهینهسازی. همانطور که نویسنده میگوید: «من فقط میخواهم خودم باشم».
اگر میخواهید نوشتههایتان شبیه به پاسخ یک پرامپت نباشد، با این شروع کنید که با هوش مصنوعی خود مانند یک ویراستار سختگیر و نابینا برخورد کنید که از نوشتن حتی یک کلمه از داستان شما منع شده است.
گام بعدی شما
- در پرامپت بعدی خود، صراحتاً به مدل دستور دهید که از هرگونه تعریف و تمجید بپرهیزد و فقط روی نقاط ضعف متمرکز شود.
- یک لیست از «کلمات ممنوعه» (مانند کلمات پرکننده) تهیه کنید و از مدل بخواهید فقط آنها را هایلایت کند، نه اینکه جایگزین پیشنهاد دهد.
- برای بازبینی نهایی، متن خود را به یک مدل متفاوت از مدلی که برای شناسایی خطاها استفاده کردید بدهید تا سوگیری تأییدی ایجاد نشود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو