تصور کنید پنج عامل کدنویس هوش مصنوعی را روی یک ماشین لینوکس اجرا کنید؛ نتیجه یک جنگ تمامعیار بر سر منابع سختافزاری است که هیچ پرامپتی نمیتواند آن را حل کند. برای پایان دادن به این هرجومرج، یک توسعهدهنده در ۱۷ اکتبر ۲۰۲۶ معماری Worktree Control را منتشر کرد؛ سامانهای متنباز که طراحی شده است تا مانع از بازنویسی بستر پروژه و کرش کردن سرورهای توسعه توسط عاملها شود.
بسیاری از برنامهنویسان ابتدا با استفاده از یک ابزار تکعاملی برای تولید کدهای تکراری (Boilerplate) شروع میکنند. نویسنده این پروژه ابتدا با یک طرح کوچک در Codex شروع کرد و وظایفی ایزوله را به مدل میسپرد: نوشتن یک تابع واحد، پیادهسازی یک کلاس یا رفع یک باگ خاص. اما با پیشرفت مدلها، وسوسهٔ واگذاری کل ویژگیهای یک محصول به چندین عامل به صورت همزمان بیشتر شد. اینجاست که یک مشکل زیرساختی پنهان ظاهر میشود: اگر سه عامل مختلف بخواهند همزمان یک سرور توسعه را روی یک پورت خاص اجرا کنند یا یک پایگاهداده مشترک را ریست کنند، کل جریان کاری فرو میپاشد.
عاملهای هوش مصنوعی را شبیه تیمی از برنامهنویسان تازهکار تصور کنید که همگی از یک میز و یک کامپیوتر مشترک استفاده میکنند. بدون مدیری که کلیدها را توزیع کند و زمانبندی داشته باشد، آنها صرفاً بر سر کیبورد میجنگند. نویسنده اشاره کرد که او شروع به ایفای نقش مدیری کرد که عاشق مدیریت ذرهبینی (Micromanaging) است، هرچند که معمولاً از انجام چنین کاری بیزار است. این تغییر رویکرد در واقع بخشی از یک روند گستردهتر است که در آن نقش برنامهنویس برای دستیابی به مقیاسپذیری بیشتر به یک ناظر تبدیل میشود. Worktree Control دقیقاً نقش همان مدیر را ایفا میکند و سیستمی برای رزرو منابع بر اساس مفاهیم کلاسیک «سمافور» (Semaphore) پیادهسازی کرده است؛ مفهومی که نویسنده آن را از دوران دانشجویی خود به یاد آورده است.
پایان جنگ منابع
این سیستم یک ماشین لینوکس با ۶ پردازنده (CPU) و ۱۸ گیگابایت رم (RAM) را مدیریت میکند. هدف این بود که پیش از هزینه برای خرید یک ماشین بزرگتر و گرانتر، حداکثر بهرهوری از سختافزار موجود گرفته شود. برای جلوگیری از اتمام حافظه و تداخل پورتها، کنترلکننده چندین مکانیزم سختگیرانه را اجرا میکند:
- رزرو سرور: هر پروژه یک سرور روی یک پورت ثابت اختصاص داده شده دارد. عاملها میتوانند این سرور را بین درختهای کاری (Worktrees) مختلف جابهجا کنند. آنها باید پیش از استفاده، حق دسترسی (Claim) پروژه را درخواست کنند و پس از اتمام کار، آن را آزاد کنند. نکته این است که آزاد کردن حق دسترسی باعث توقف سرور نمیشود؛ بنابراین یک رزرو آزاد لزوماً به معنای خالی بودن یک اسلات سرور نیست.
- اولویت انسانی: کاربر انسانی — که «مهمترین عامل» توصیف شده — میتواند پروژه را از طریق یک داشبورد قفل کند. این کار باعث میشود تمام عاملها مجبور شوند به رزرو موجود احترام بگذارند، در حالی که توسعهدهنده در حال بررسی موردی در مرورگر است.
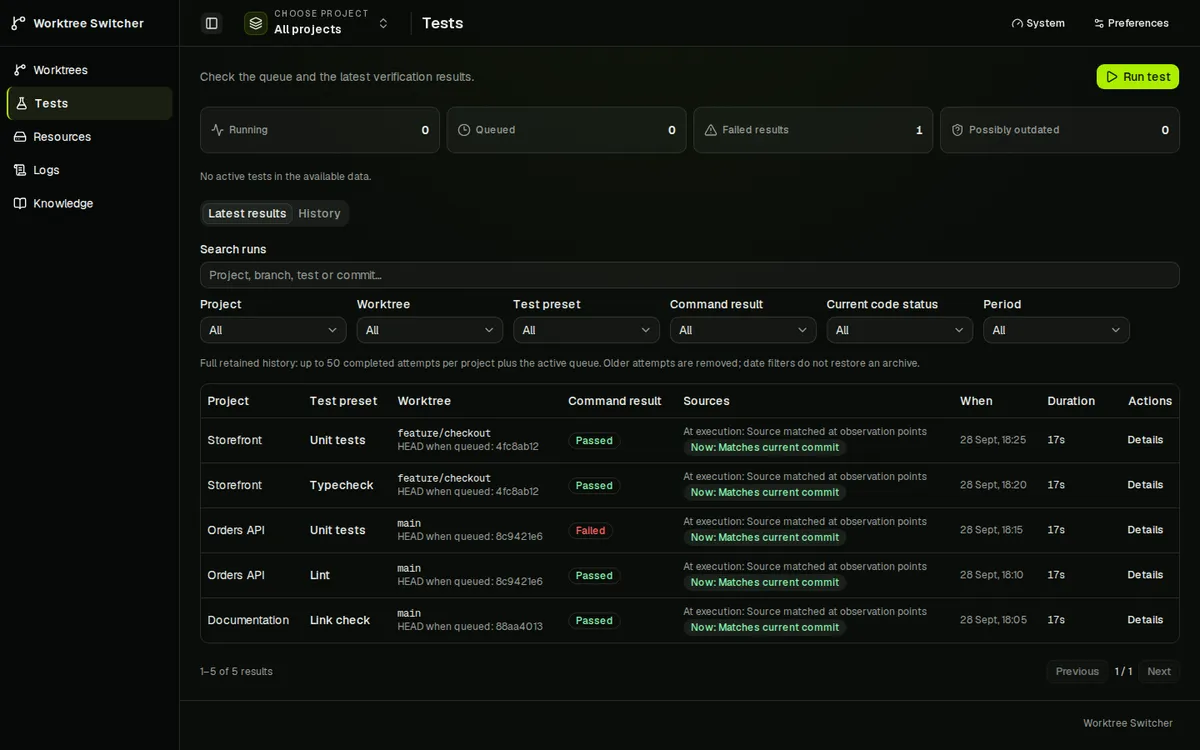
- صف تأییدات: اجرای بیلدها و تستها وارد یک صف مجزا میشوند. سیستم تعداد اجراهای همزمان را محدود کرده و در هر درخت کاری، حداکثر یک بررسی فعال را اجازه میدهد.
- منطق اجرا: ارسال یک تست به معنای تغییر خودکار سرور توسعه نیست. اگر یک تست مرورگر به آن سرور نیاز داشته باشد اما عامل دیگری حق دسترسی را در اختیار داشته باشد، تست باید منتظر بماند. همچنین، استارت زدن یک سرور متوقف شده، مستلزم وجود فضای خالی تحت سقف محدودیت سرورها است.
مدیریت وابستگیهای پیچیده
تفکیک بین سرور و صف برای معماریهای خاص پروژه حیاتی است. در یکی از پروژههای نویسنده، پیشنیازهای تست (Test Fixtures) مشترک باید در داخل همان Job صفبندی شده آماده شوند. اگر سیستم پایگاهداده را پیش از ورود به صف ریست کند، ممکن است تستی را که در حال حاضر در حال اجراست مختل کند.
علاوه بر این، کنترلکننده میزان مصرف منابع و فضای دیسک درختهای کاری را رصد میکند. از آنجایی که دایرکتوریهای .next میتوانند انباشته شده و فضای قابل توجهی را مصرف کنند، داشبورد به کاربر اجازه میدهد پس از تأیید، حافظه موقت (Cache) Next.js مربوط به یک درخت کاری متوقف شده و باز (Unlocked) را پاک کند.
تستهای مبتنی بر شواهد
یکی از بزرگترین ریسکها در کدنویسی عاملمحور، «مثبت کاذب» (False Positive) است؛ یعنی وقتی عاملی ادعا میکند «تستها پاس شدند» در حالی که کد در واقع پس از شروع تست تغییر کرده است. Worktree Control این مشکل را با ثبت مشاهدات گیت (Git) در اطراف هر اجرا حل میکند و نتیجه دستور را از شواهد منبع آن جدا میسازد.
این سیستم کامیت دقیق، وضعیت «کثیف» بودن درخت کاری (داشتن تغییرات ثبتنشده) و خلاصهای (Digest) از ورودیهای وضعیت گیت برای مسیرهای تغییر یافته را رصد میکند. این مشاهدات هم قبل و هم بعد از اجرا ثبت میشوند. اگر در این فاصله HEAD تغییر کند، سیستم نتیجه را علامتگذاری میکند. اگرچه این بررسیهای محلی، اسنپشاتهای تغییرناپذیر نیستند و نمیتوانند هر وابستگی محیطی را ثبت کنند، اما یک ردپای قابل بازرسی (Audit Trail) ایجاد میکنند تا کاربر به جای اعتماد به یک ادعا در چت، به شواهد فنی استناد کند.
خلق یک مغز مشترک
از دست رفتن زمینه (Context) دومین مانع بزرگ است. نویسنده ابتدا سعی کرد فایلهای JSON و Markdown را در مخزن گیت به عنوان یک بکلاگ مشترک نگه دارد. اما با معرفی شاخهها و درختهای کاری، هر عامل در نهایت نسخه خاص خود از بکلاگ را داشت و همگامسازی دشوار و ناخوشایند شد.
وقتی از Codex به Claude Code یا OpenCode سوییچ میکنید، عامل جدید معمولاً هیچ ایدهای ندارد که عامل قبلی چه تصمیمی گرفته است. برای حل این مشکل، توسعهدهنده یک لایه «دانش» (Knowledge) به کنترلکننده اضافه کرد. این لایه به عنوان یک مخزن متمرکز برای موارد زیر عمل میکند:
- بکلاگ پروژه: لیستی مشترک از وظایف و بحثهای فعال.
- حافظه پروژه: تصمیمات معماری و سوابقی که منابع و تاریخچه بازبینی خود را حفظ میکنند.
- زمینه تحویل (Handoff Context): مجموعهای خاص از حافظههای لینکشده و بازبینیهای منبع که به عامل بعدی میگوید از کجا شروع کند.
این رویکرد برای حل مشکل پراکندگی نشستها مشابه راهکاری است که در معماری TaskHandoff برای مدیریت انتقال وظایف بین عاملها پیشنهاد شده است. در این سیستم، ذخیره یک ورودی حافظه و تأیید آن دو اقدام مجزا هستند. عاملها از طریق رابط خط فرمان (CLI) یا پروتکل زمینه مدل (MCP) به این حافظه مشترک دسترسی پیدا میکنند. این امر تضمین میکند تصمیمی که در یک جلسه چت گرفته شده، بدون نیاز به کپیبرداری دستی، در دسترس عامل بعدی باشد.
پشته فنی فعلی
محیط عملیاتی کامل فعلی شامل یک ماشین لینوکس است که Codex، Claude Code و OpenCode روی آن اجرا میشوند. دسترسی از راه دور به جلسات کدنویسی توسط T3 Code مدیریت میشود، در حالی که n8n اتوماسیون بررسیهای PR را بر عهده دارد.
در حال حاضر Worktree Control پنج پروژه ثبتشده در زمان اجرا (Runtime) را روی آن ماشین مدیریت میکند و نویسنده حتی از آن برای سازماندهی توسعه خودِ Worktree Control استفاده میکند. معماری فنی کنترلکننده شامل موارد زیر است:
- بکاند: یک پردازش واحد Node.js که از SQLite استفاده میکند.
- فرانتاند: رابط کاربری Next.js که به صورت فایلهای استاتیک خروجی گرفته شده است تا نیازی به سرور مقیم (Resident Server) نداشته باشد.
- وضعیت: پروژه در حال حاضر در نسخه پیش از ۱.۰ است. در حالی که امروز روی یک ماشین لینوکس اجرا میشود، توسعهدهنده در حال کار روی توزیع (Dispatching) بررسیها به ماشینهای لینوکس مجزا و متصل است.
چرخش از «پرامپتنویسی» به «ارکستراسیون» (Orchestration) حقیقتی حیاتی را درباره وضعیت فعلی هوش مصنوعی آشکار میکند: گلوگاه دیگر هوش مدل نیست، بلکه پایداری محیطی است که مدل در آن زندگی میکند. وقتی از یک عامل به پنج عامل میرسید، دیگر یک کدنویس نیستید، بلکه تبدیل به یک مدیر سیستم (SysAdmin) میشوید.
برای یک توسعهدهنده معمولی، فاز بعدی بهرهوری نه یک مدل زبانی بزرگتر، بلکه ابزارهای بهتری برای مدیریت «سربار عاملها» (Agentic Overhead) است. این نیاز به ابزارها در واقع نتیجهی تفکیک استراتژی از کدنویسی است تا از توهمات مدل در لایههای اجرایی کاسته شود. مشغول نگه داشتن هر عامل را به راحتی میتوان با پیشرفت اشتباه گرفت؛ هدف واقعی این است که بتوانید به یک وظیفه بازگردید و دقیقاً ببینید چه چیزی تغییر کرده و چه مواردی هنوز نیاز به توجه انسان دارد.
اگر شما هم چندین عامل را روی یک ماشین اجرا میکنید، میتوانید سورسکد این پروژه را در گیتهاب بررسی کنید تا ببینید چگونه صفهای رزرو مشابهی را برای پشته فنی خود پیاده کنید. وبسایت پروژه: https://pioootrek.github.io/worktree-control/



گفتگو