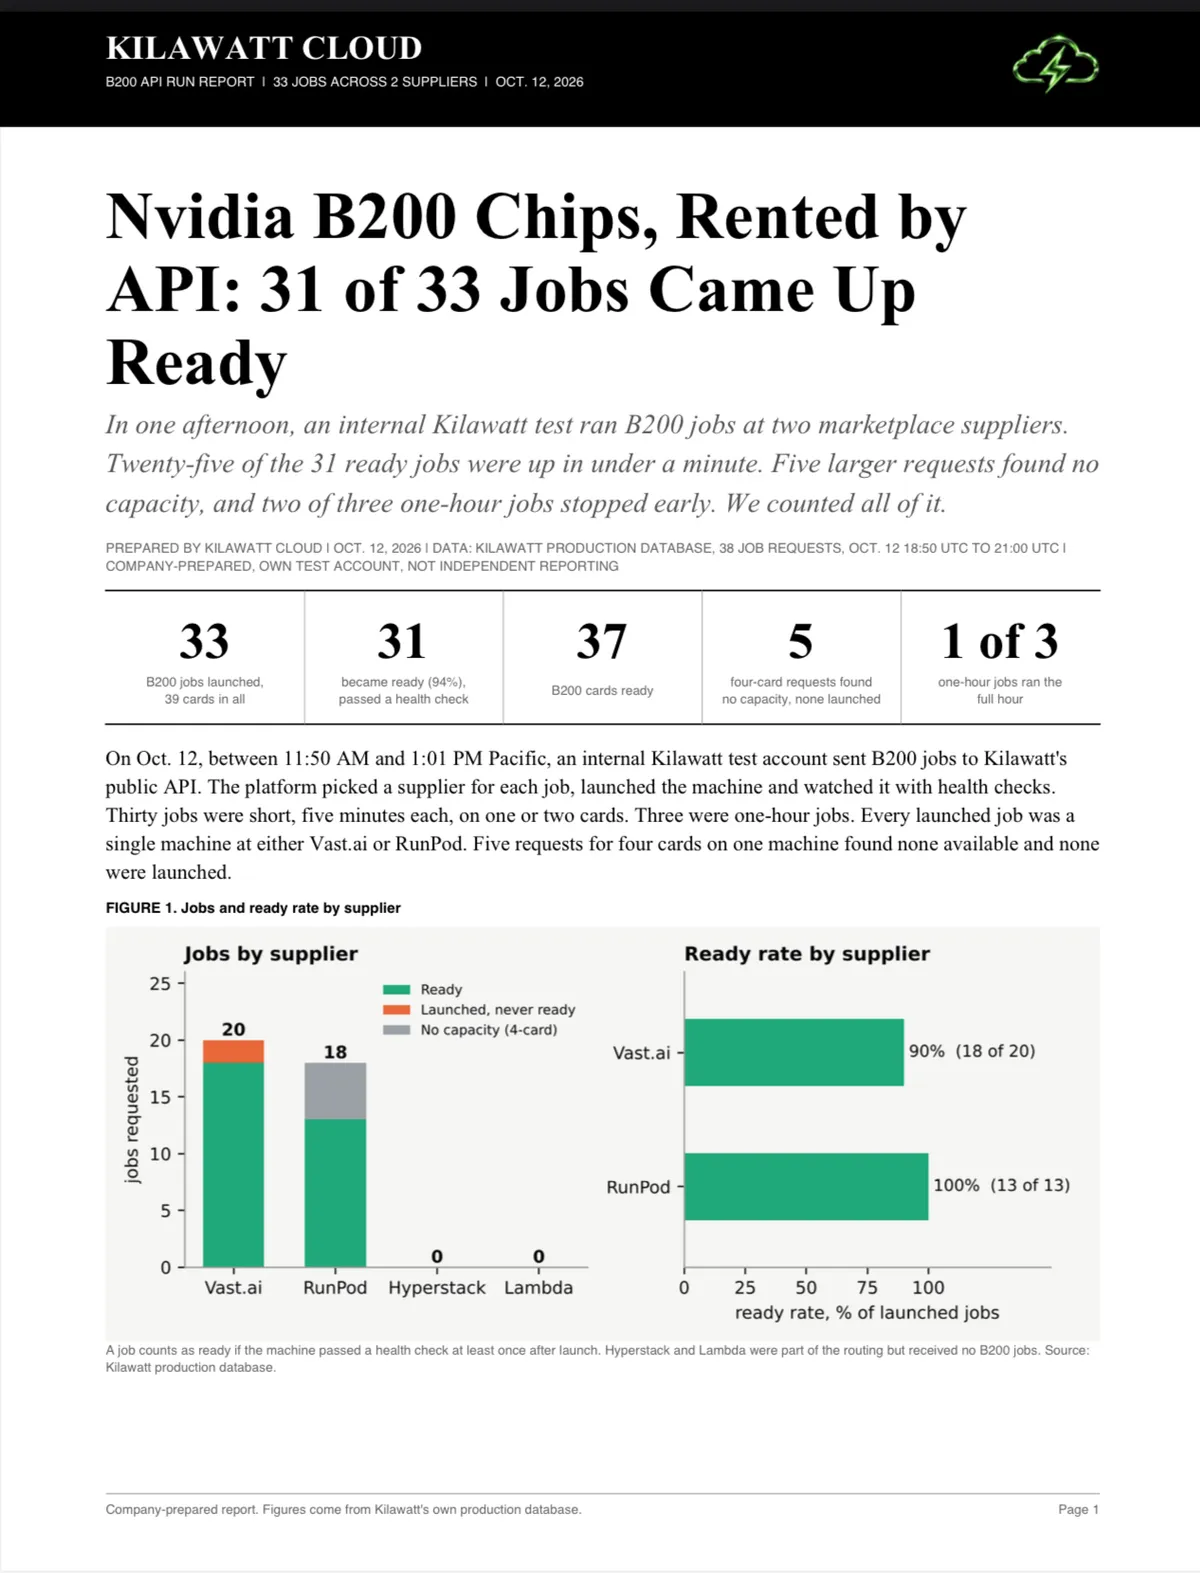
اگر امروز برای دسترسی به قدرتمندترین پردازندههای گرافیکی جهان رقابت میکنید، باید بدانید که فاصله بین «درخواست API» و «دریافت سختافزار» هنوز یک متغیر پیشبینیناپذیر است. طبق گزارش منتشر شده در ۱۳ اکتبر ۲۰۲۶، شرکت Kilawatt Cloud در یک تست استرس نشان داد که ۳۱ مورد از ۳۳ تلاش برای راهاندازی واحد پردازش گرافیکی (GPU) — که شبیه به اجاره کردن یک ابرکامپیوتر کوچک برای پردازشهای سنگین است — با موفقیت به وضعیت «آماده» رسیدند.
مدیریت محاسبات سطح بالا اغلب شبیه رزرو هتل در تعطیلات است؛ شما رزرو دارید، اما لزوماً وقتی میرسید اتاق آماده نیست. Kilawatt Cloud در اینجا نقش یک پیشخوان یا کانسیرژ را ایفا میکند و درخواستها را به جایی میفرستد که ظرفیت واقعی وجود داشته باشد تا توسعهدهنده مجبور نباشد هنگام پر شدن یک خوشه (Cluster)، بهصورت دستی تأمینکننده را عوض کند. این رویکرد در واقع پاسخی به چالشهای اتوماسیون در زنجیره تأمین است، مشابه آنچه در تلاشهای اخیر برای مدیریت خودکار خرید سختافزار توسط عاملهای هوش مصنوعی مشاهده کردیم. همانطور که در تحلیلهای قبلی ما دربارهی زیرساختهای محاسباتی ابری اشاره کردیم، پایداری لایه توزیع به اندازه خودِ سختافزار اهمیت یافته است.
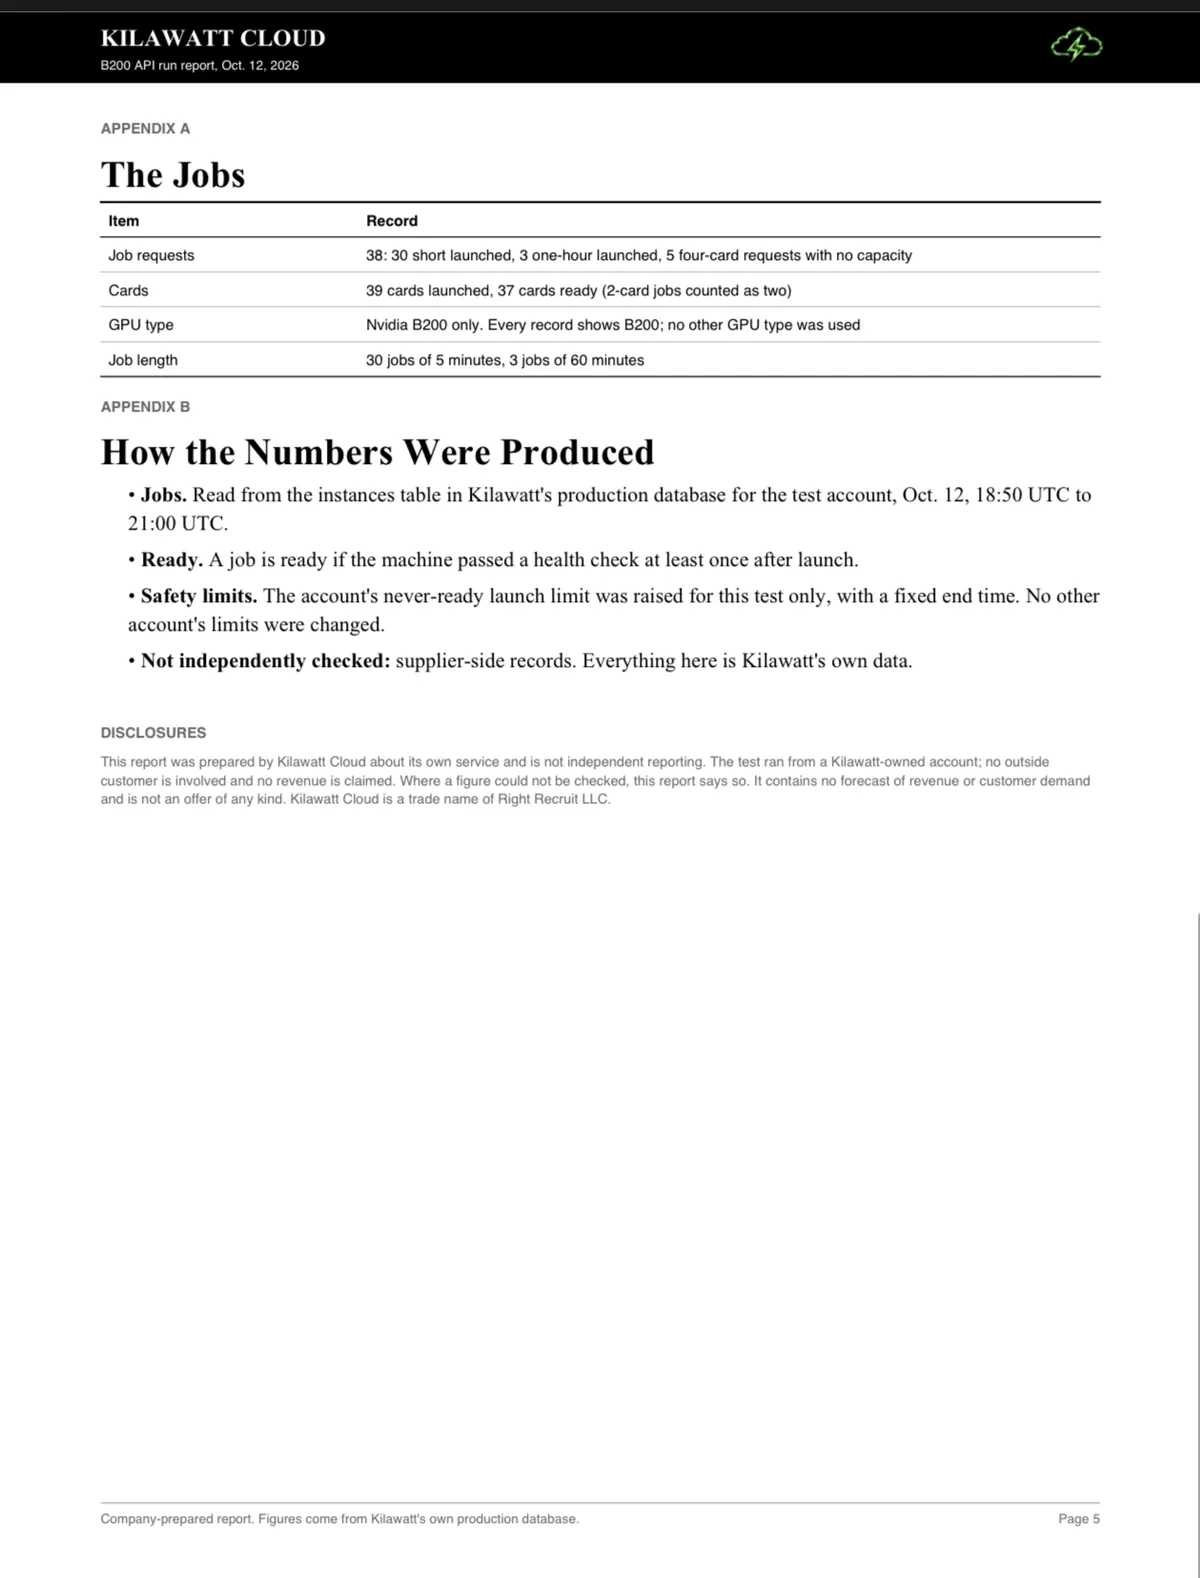
بر اساس مستندات این گزارش، این روتر ۳۸ درخواست برای تراشههای Nvidia B200 ارسال کرد که منجر به راهاندازی ۳۳ شغل روی ۳۹ کارت گرافیکی شد. نتایج بهتفکیک تأمینکننده تفاوتهای چشمگیری داشت:
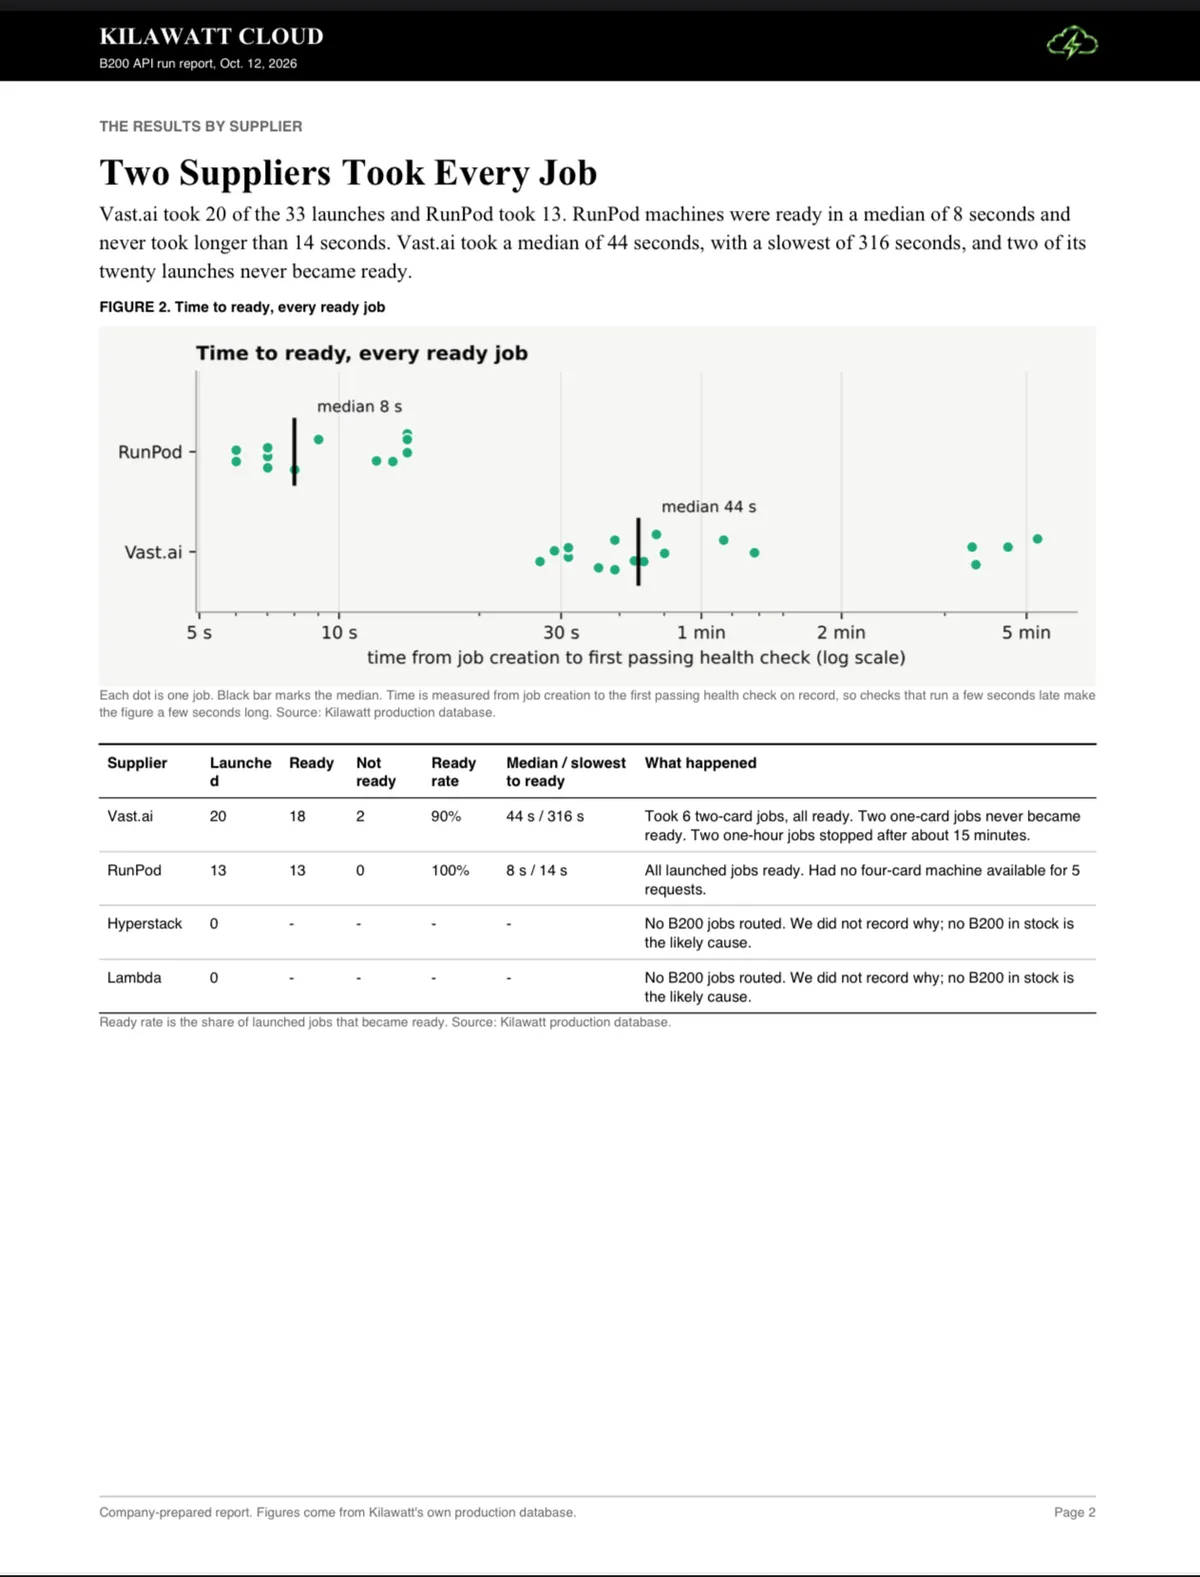
- RunPod: ۱۳ شغل راهاندازی شد (۱۰۰٪ موفق). میانگین زمان رسیدن به وضعیت آماده ۸ ثانیه و کندترین مورد ۱۴ ثانیه بود.
- Vast.ai: ۲۰ شغل راهاندازی شد (۹۰٪ موفق). میانگین زمان آمادهسازی ۴۴ ثانیه بود، اما کندترین مورد تا ۳۱۶ ثانیه طول کشید.
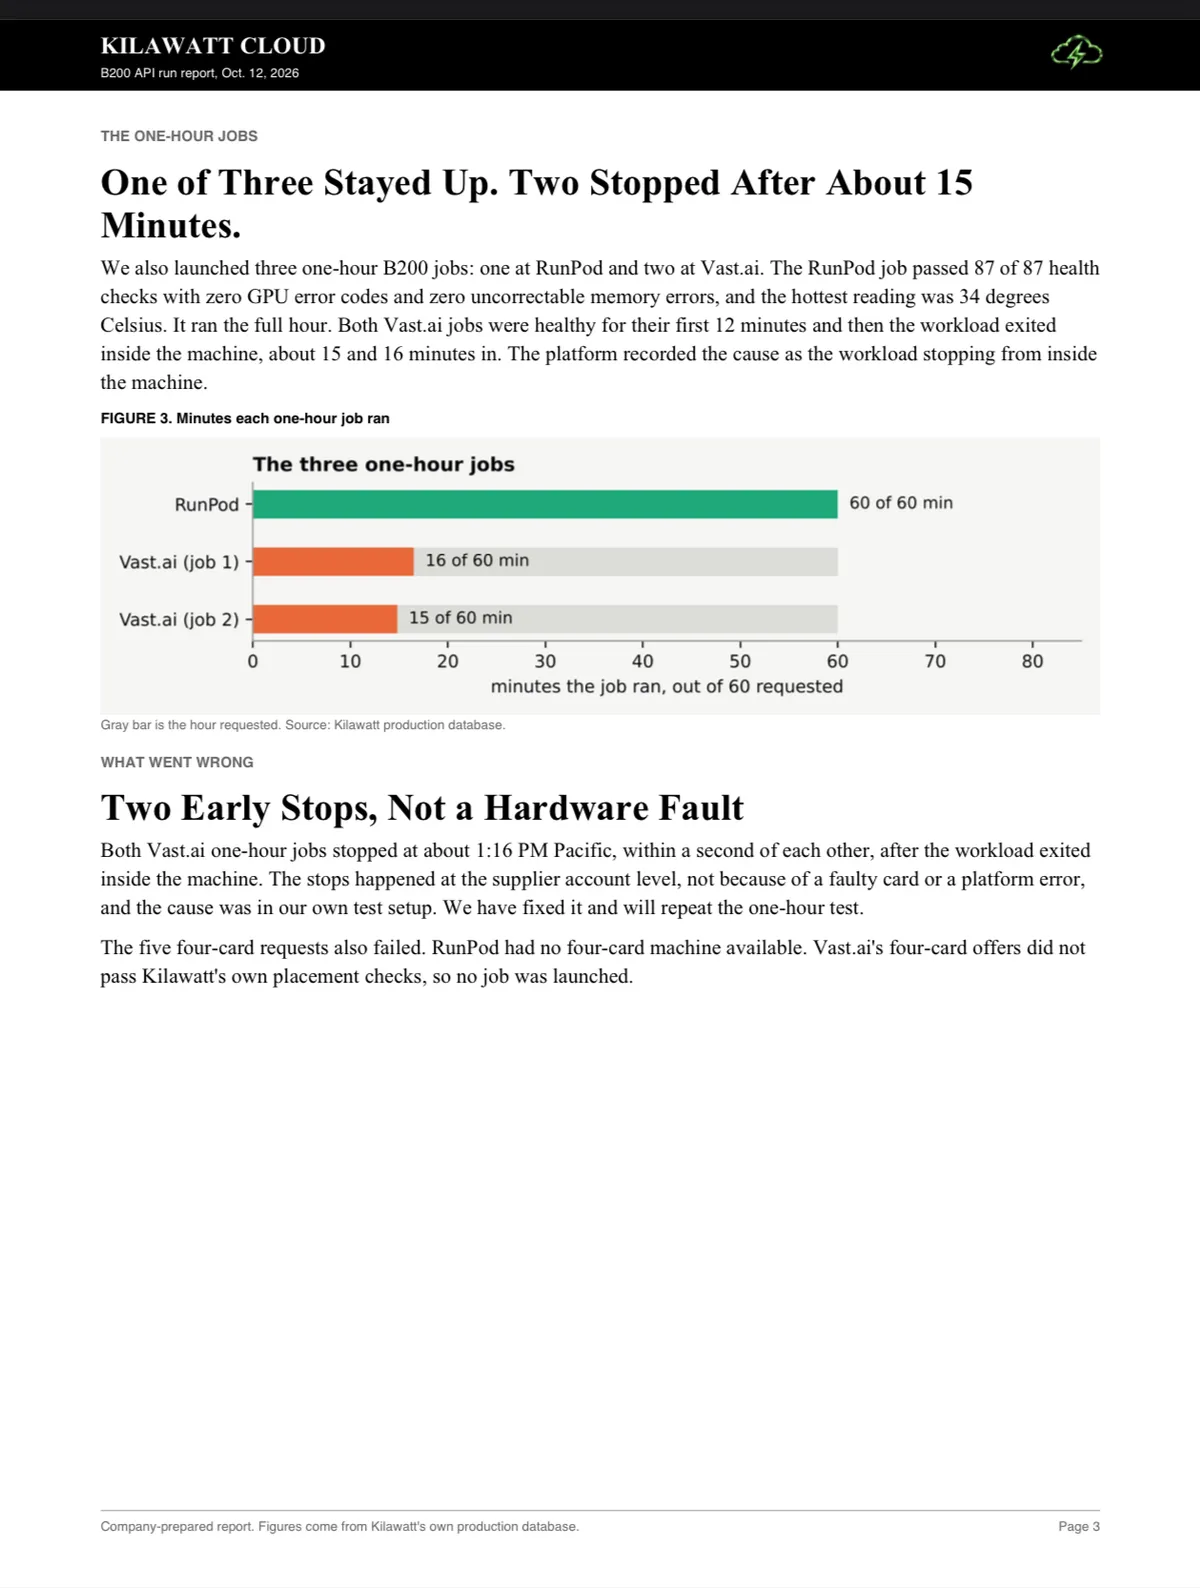
در یک تست پایداری یکساعته، نمونههای RunPod تمام ۸۷ بررسی سلامت را بدون هیچ خطای XID یا ECC و با حداکثر دمای ۳۴ درجه سانتیگراد پشت سر گذاشتند. در مقابل، هر دو شغل یکساعته در Vast.ai پس از ۱۵ تا ۱۶ دقیقه متوقف شدند؛ به نقل از گزارش، این توقفها ناشی از مشکلات سطح حساب کاربری بود، نه نقص سختافزاری.
این دادهها ثابت میکند که اگرچه B200 در دسترس است، اما «مایل آخر» استقرار — یعنی فاصله زمانی بین فراخوانی API و دسترسی به GPU — همچنان ناپایدار است. برای توسعهدهندگان، این یعنی انتخاب لایه ارکستراسیون اکنون به اندازه انتخاب خودِ سختافزار حیاتی است تا از تأخیرهای هزینهبر در شروع پروژه جلوگیری شود. در این راستا، بهینهسازی لایههای نرمافزاری برای بهرهوری بیشتر، مانند افزایش توان عملیاتی توکنها در پلتفرم DSX انویدیا، مکمل این زیرساختهای توزیع است.
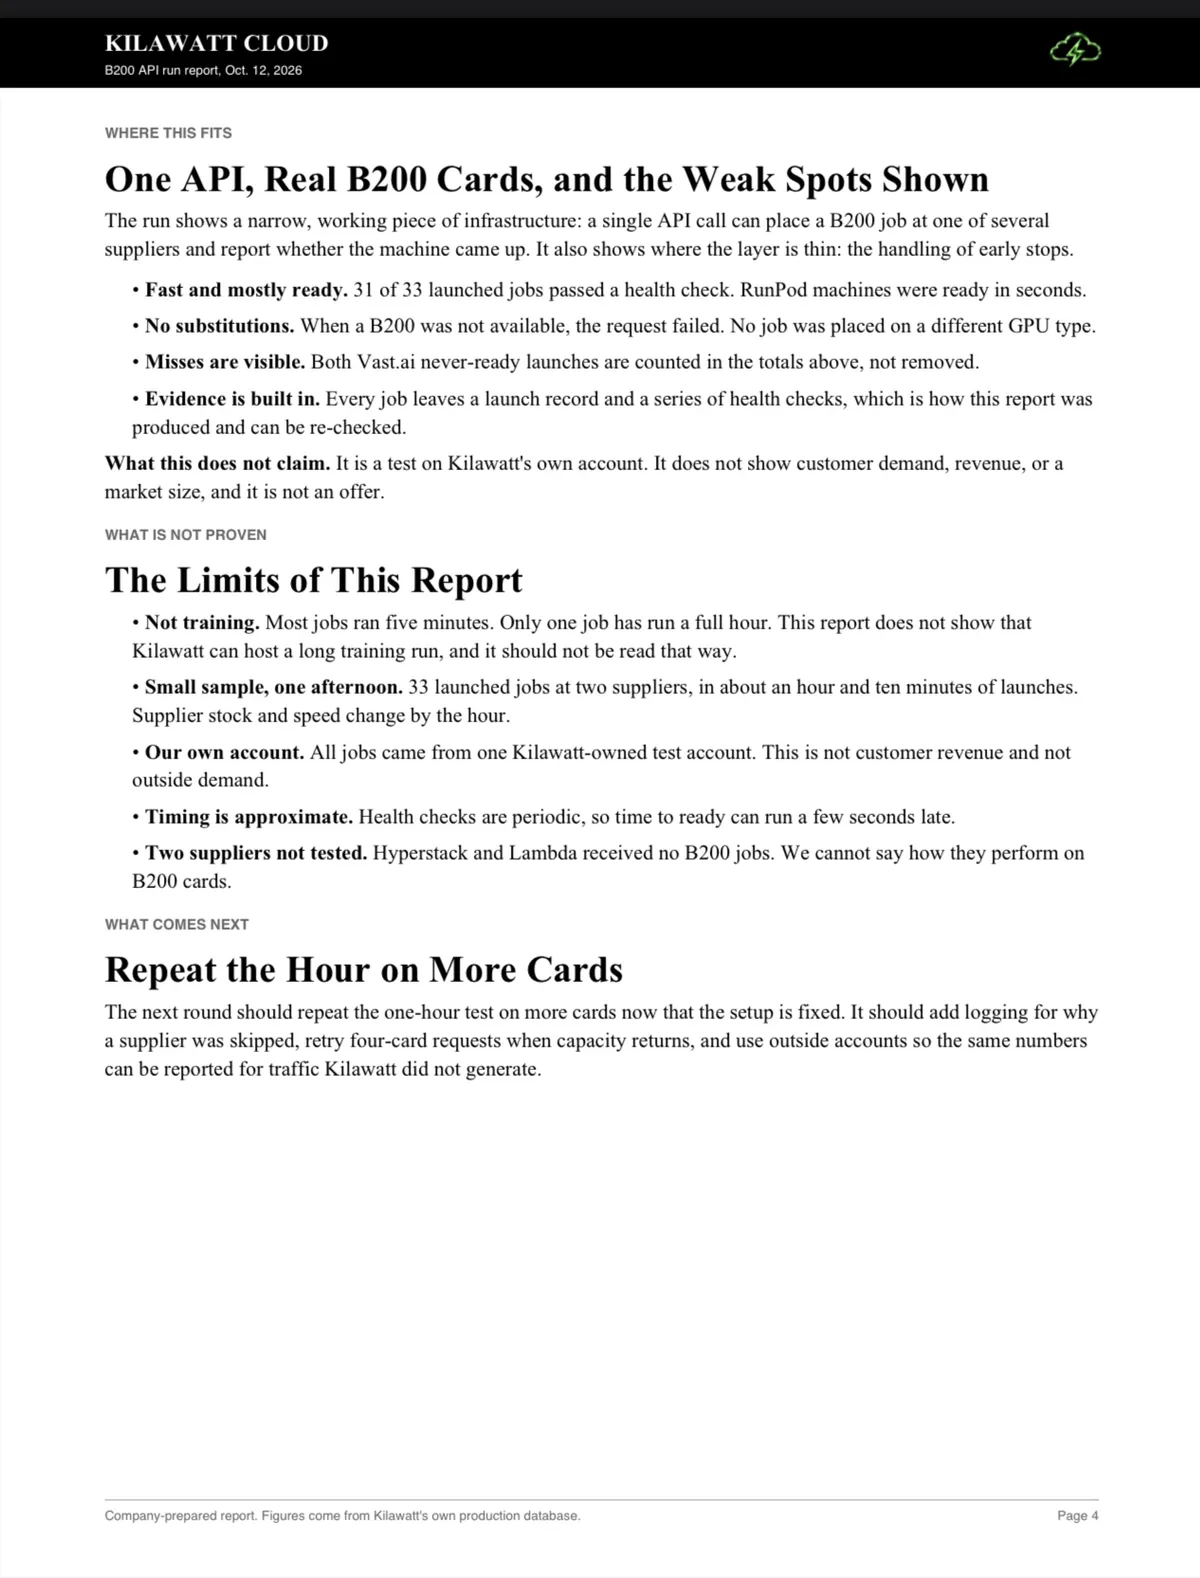
شرکت Kilawatt Cloud اکنون در حال توسعه قابلیت «شغلهای آگاه به نقطه بازرسی» (Checkpoint) است تا اگر یک میزبان در میانه کار از دسترس خارج شد، پردازش بهطور خودکار روی تأمینکننده دوم از سر گرفته شود. این مدل از دسترسی منعطف به سختافزار، جایگزینی مدرن برای مدلهای سنتی است که در آن سرمایهگذاریهای کلان برای خرید سیستمهای GB200 تنها راه دستیابی به قدرت پردازشی بالا بود.
گام بعدی شما
- اگر از چندین تأمینکننده GPU استفاده میکنید، زمان «راهاندازی سرد» (Cold Start) هر کدام را اندازهگیری کنید.
- برای پروژههای حساس به زمان، اولویت را به تأمینکنندگانی با میانگین تأخیر زیر ۱۰ ثانیه بدهید.
- منتظر گزارش بعدی Kilawatt درباره زمان بازیابی پس از شکست در میانه پردازش باشید تا میزان استواری این سیستم را بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو