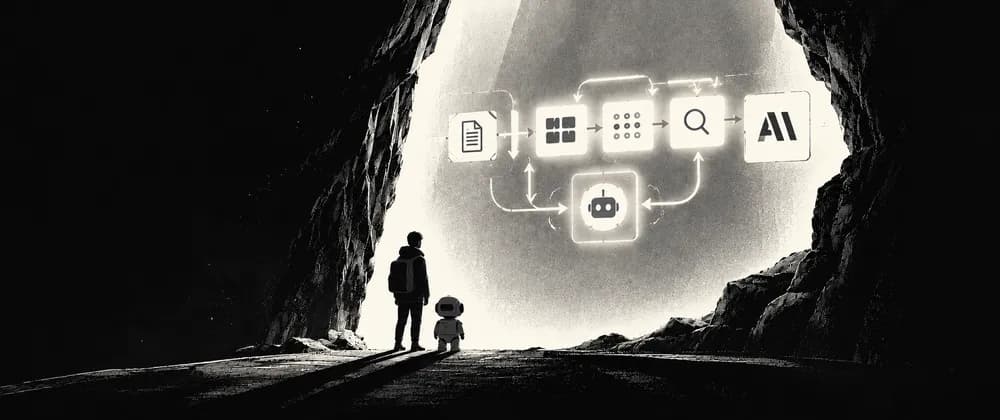
اگر فکر میکنید ساخت یک عامل هوش مصنوعی تنها به نوشتن چند پرامپت دقیق ختم میشود، احتمالاً با اولین برخورد با دادههای واقعی غافلگیر خواهید شد. توسعهدهندهای به نام Aeron با به اشتراک گذاشتن تجربه ساخت یک دستیار پژوهشی کریپتو، ثابت کرد که حتی سادهترین ابزارها برای رسیدن به قابلیت اطمینان، به یک زیرساخت پیچیده نیاز دارند. این عامل خاص برای یک وظیفه بسیار ساده طراحی شده بود: دریافت سؤالی درباره کریپتو و پاسخ به آن، یا اعلام اینکه اگر پاسخ در منابع ارائه شده وجود ندارد، آن را نمیداند.
بسیاری از کاربران هنگام تعامل با مدلهایی مثل Claude، Hermes یا ChatGPT، تنها «نوک کوه یخ» را میبینند. زبان طبیعی — که شبیه به یک ویترین زیباست و پیچیدگیهای پشت صحنه را میپوشاند — روشی راحت برای استفاده از فناوری است، اما این انتزاع باعث میشود نحوه اجرای ماشین در پشت صحنه پنهان بماند. برای کارهای عمومی، این سطح از انتزاع مناسب است، اما برای کاربردهای تخصصی، درک عمیق مکانیسمهای داخلی ضروری است.
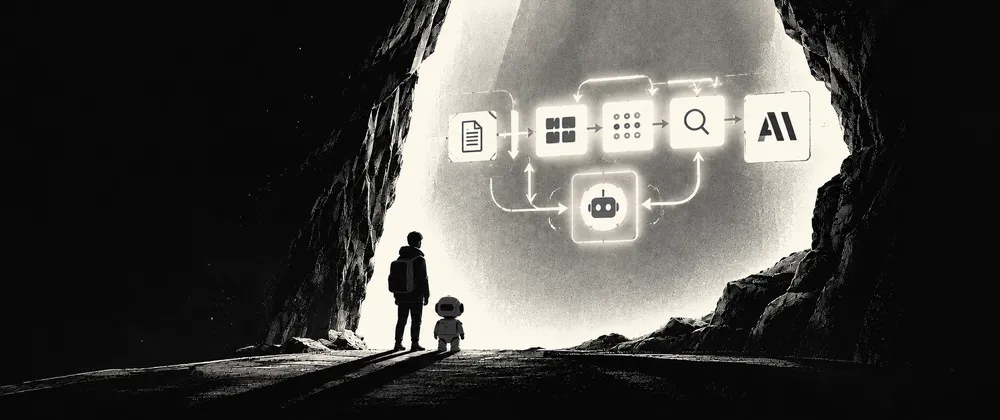
به نقل از Aeron، این سامانهها برخلاف ظاهرشان، پاسخهای فوری نمیدهند، بلکه در یک «حلقه مرکزی عامل» (Core Agent Loop) عمل میکنند. در واقع، هیچ عاملی در اولین پاسخ خود جواب نهایی را نمیدهد؛ بلکه فرآیند به این صورت است که مدل چندین ابزار را فراخوانی میکند، نتایج را دریافت میکند و سپس آن نتایج را چندین بار به مدل بازمیگرداند تا زمانی که اطلاعات کافی برای پاسخدهی جمع شود، این چرخه ادامه مییابد. این پیچیدگی در طراحی، تفاوت میان یک چتبات ساده و استقرار عاملهای هوشمند برای اتوماسیون وظایف پیچیده است که نیازمند استراتژیهای دقیقتری برای اجراست.
خط لوله RAG
برای مدیریت دادههای خاص، این توسعهدهنده یک خط لوله تولید بازیابیافزا (RAG) پیادهسازی کرد. این ساختار هسته اصلی برای جذب منابع و یافتن پاسخها است. این فرآیند از چهار مرحله سختگیرانه میگذرد:
- تکهبندی (Chunking): خرد کردن متن منبع به قطعات کوچکتر.
- بردار معنایی (Embedding): تبدیل متن به بردارهای عددی — مثل کارت معرفی عددی برای هر واژه که همسایگی آن با کلمات دیگر را مشخص میکند.
- بازیابی (Retrieval): یافتن تکههای مرتبط با پرسش کاربر.
- تولید (Generation): خلق پاسخ نهایی بر اساس تکههای بازیابی شده.
این خط لوله سپس به عنوان یکی از ابزارهای متصل به حلقه مرکزی عامل عمل میکند تا اطمینان حاصل شود که هوش مصنوعی بر اساس منابع ارائه شده مبنیسازی (Grounding) شده است و از تخیل استفاده نمیکند.
استک فنی (Technical Stack)
برای تبدیل این اسکریپت محلی به یک اپلیکیشن کاربردی، از یک استک ابری خاص استفاده شد. اولویت کلیدی این بود که اسناد منبع هنگام استقرار در فضای ابری، به صورت عمومی منتشر نشوند:
- ذخیره کد: یک مخزن عمومی در GitHub که تنها شامل کدهای منبع بود و هیچگونه کلید امنیتی یا سند خصوصی در آن قرار نداشت.
- ذخیره اسناد: یک باکت Amazon S3 که از طریق یک کلید IAM با دسترسیهای حداقلی (Least-privilege) قابل دسترسی بود.
- رابط کاربری: Streamlit Community Cloud که از مخزن عمومی مستقر شده بود و برای محدود کردن دسترسیها، دارای سیستم رمز عبور بود.
چالش ارزیابیها (Evals)
سختترین مرحله، پیادهسازی «ارزیابیها» (Evals) برای جلوگیری از توهم (Hallucination) بود. از آنجایی که کاربران همیشه با دادههای منبع آشنا نیستند، سیستمی لازم است تا دو حالت شکست اصلی را بررسی کند:
- نشت (Leak): بررسی اینکه آیا پاسخ عامل واقعاً از منابع است یا مدل بر اساس حافظه داخلی خود در حال حدس زدن است.
- امتناع بیش از حد (Over-refusal): بررسی اینکه آیا عامل از پاسخ دادن خودداری میکند، حتی زمانی که پاسخ در منابع موجود است.
Aeron اشاره میکند که دستیابی به نرخ موفقیت ۱۰۰٪ در ارزیابیها تقریباً غیرممکن است و حفظ آن در درازمدت دشوار است. او ابتدا سعی کرد با اصلاح پرامپتهای سیستمی و توصیفات ابزارها، به بنچمارکی برسد که در آن سه بار متوالی موفقیت ۱۰۰٪ حاصل شود. اما چون پاسخهای مدل زبانی بزرگ (LLM) هر بار تغییر میکند — حتی بدون تغییر در پرامپت — این مسیر به یک «چاه بیانتها» تبدیل شد. استراتژی پیشنهادی این است که یک هدف ارزیابی خاص را انتخاب کنید و هر بار تنها یک مورد را برای بهبود تغییر دهید.
مدیریت توکن و دادهها
مصرف توکن (Token) به دلیل هزینهها و عملکرد، بهویژه در زمان تستهای A/B برای ارزیابیها، به یک عامل حیاتی تبدیل میشود. برای مدیریت این موضوع، توسعهدهنده سه راهکار خاص را پیشنهاد میکند:
- تعیین یک سقف سخت (Hard Cap) برای مصرف توکنها.
- ارائه آخرین پاسخ به عنوان زمینه (Context) به عامل تا از اجرای مجدد کل فرآیند در هر بار درخواست جلوگیری شود.
- تست تنها همان ارزیابی خاصی که در حال اصلاح است، به جای اجرای کل مجموعه ارزیابیها.
چالش تکهبندی (Chunking)
تکهبندی متون متلاطمترین بخش کل فرآیند ساخت عامل بود. توسعهدهنده با یک توازن دشوار روبرو بود: تکهها نباید خیلی بلند باشند چون با محدودیت توکن در هر فراخوانی برخورد میکنند، اما نباید آنقدر کوتاه باشند که لیست تکهها بیش از حد پراکنده شود و مدل نتواند اطلاعات دقیق مورد نیاز را بیابد.
Aeron با خطر بیشبرازش (Overfitting) مواجه شد. او ابتدا تکهبندی را به گونهای ساخت که یک مقاله خاص را بر اساس محتوای آن تقسیم کند، که این کار رتبه میانگین (Mean Rank) را به شدت بهبود بخشید. اما این تکهبند در هنگام جذب چندین سند مختلف (Multi-doc ingestion) به طور کامل شکست خورد. این خطا منجر به هدر رفتن یک صبح کامل شد، زیرا او مجبور شد کل سیستم تکهبندی را بازسازی کرده و تمام ارزیابیها را دوباره تست کند تا پایداری سیستم تضمین شود.
برای توسعهدهندگان، این یعنی عاملهای «نصب و اجرا» (Plug-and-play) برای کاربردهای حساس و با ریسک بالا کافی نیستند. در واقع، افزایش بیرویه تعداد عاملها همیشه به معنای بهبود کیفیت نیست و گاهی تعداد زیاد عاملهای هوش مصنوعی میتواند کیفیت خروجی و کد را کاهش دهد. اثر مرتبه دوم این موضوع، تغییر رویکرد به سمت «مهندسی عامل» (Agent Engineering) است؛ جایی که ارزش واقعی نه در پرامپت، بلکه در دقت خط لوله RAG و سختگیری در چارچوب ارزیابیها نهفته است. برای رسیدن به خروجی مطلوب در کاربردهای خاص، باید درک عمیقی از نحوه اجرای این ماشینها داشت.
اگر در حال ساخت اولین عامل خود هستید، توصیه میشود ابتدا استراتژی تکهبندی خود را بازبینی کنید تا مطمئن شوید که در انواع مختلف اسناد مقیاسپذیر است، پیش از آنکه ساعتها وقت خود را صرف اصلاح پرامپتهای سیستمی کنید.
گام بعدی شما
- اگر در حال ساخت اولین عامل خود هستید، ابتدا استراتژی تکهبندی (Chunking) را روی انواع مختلف اسناد تست کنید.
- به جای تلاش برای رسیدن به دقت ۱۰۰٪، یک معیار پذیرش (Acceptance Criteria) واقعبینانه برای ارزیابیها تعریف کنید.
- برای کاهش هزینهها، از حافظه کوتاهمدت برای ذخیره آخرین پاسخها استفاده کنید تا توکنهای تکراری مصرف نشود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو